GPT-6.2 Astra与Sol发布:性能暴涨,成本骤降
OpenAI发布GPT-6.2系列Astra与Sol,AI正转向能独立完成复杂专业任务的智能体。
OpenAI 正式发布 GPT-6.2 系列模型,包括性能旗舰 Astra 和高性价比版本 Sol。Astra 在 Agent's Last Exam 测试中得分 78.3%,较上一代提升 5.2 个百分点,成本不到上一代三分之一;在专业工作、CAD 设计和科研工作流等测试中均有明显提升。Sol 在代码任务上与 Astra 仅差 0.4 分,但成本远低于 Astra,API 单价未上涨。技术报告还显示,OpenAI 首次将模型自我改进能力评为 HIGH 级别,AI 开始参与下一代 AI 研发。文章认为,能力提升与成本下降正在同时加速,AI 智能体的普及可能超出预期。
OpenAI正式发布了GPT-6.2系列模型,包含主打顶级性能的Astra和高性价比的Sol两个版本。从官方技术报告和B站UP主的解读来看,这次升级的核心信号很明确:AI正在从“会聊天、会写代码”的助手,转向能够独立完成复杂专业任务的智能体。
Astra:啃硬骨头的性能旗舰
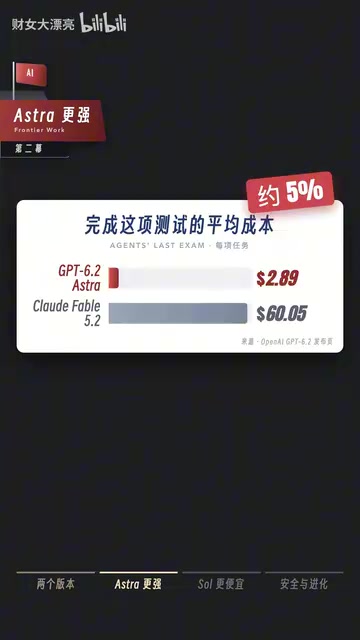
Astra的定位是攻克高难度任务。OpenAI为它设计了一项名为“Agent's Last Exam”的测试,专门评估AI独立完成多步骤复杂专业任务的能力。Astra拿下了78.3%的成绩,比上一代提升了5.2个百分点,而完成任务的平均成本不到上一代的三分之一。
与竞品Anthropic的Claude Fable 5.2相比,Astra在成绩上高出5.5个百分点,完成测试任务的平均成本仅为后者的5%左右。据B站UP主分析,这只是一个特定测试的结果,不代表所有任务都能便宜95%,但它反映出一个趋势:AI能力在提升的同时,完成工作的成本正在快速下降。
复杂专业工作能力的跃升
以前让AI分析一家上市公司的财报,它可以总结数据、整理观点。但如果要求它把过去五年的财报全部整理出来、建立估值模型、再做一份给投资人看的PPT,中间还要处理Excel、检查计算结果、调整排版,传统模型就容易出错。Astra重点升级的恰恰是这类复杂工作:在专业工作测试中比上一代提高了6.2个百分点,输出Token减少了22%,生成的幻灯片、电子表格和报告更符合专业人士的实际使用习惯。
Token 消耗量 是评估大模型使用成本的关键指标之一。模型处理输入和生成输出都以 Token 为单位计费,输出 Token 尤其昂贵。在完成同一类任务时,输出 Token 减少意味着模型表达更精炼、少走弯路、少产生无用内容,直接降低 API 调用成本,也缩短响应时间。Astra 输出 Token 减少 22%,说明它在规划步骤和生成结果时更“有的放矢”,这对需要反复调用模型的长流程任务(如财报分析、报告生成)累积起来的经济意义很大。
3D建模与CAD设计的突破
Astra在视觉和工程领域的表现同样值得关注。OpenAI让它设计了一套汽车底盘的动态模拟:给定“模拟汽车在山路行驶时轮胎和悬架运动”的需求,Astra能自主建立3D模型、编写Python程序计算受力关系,最后调用Blender把整个过程做成动画。在机械装配、发动机设计,甚至将建筑照片转化为可制作的灯具设计等任务中,Astra也展现了能力。CAD设计测试成绩从上一代的62.6%直接提高到82.5%,这意味着工程师做产品设计时,可能不再需要每个步骤都亲自动手。
Agent's Last Exam 是 OpenAI 为评估 AI 智能体(Agent)能力而设计的一套基准测试,名称戏仿了人类用来测试专家知识广度的“Last Exam”。与常规答题类评测不同,它不只看模型能否给出正确答案,而是要求模型在无人逐步干预的情况下,自主规划、调用工具、处理中间文件并完成多步骤的复杂专业任务。这类测试更接近真实工作场景,因此得分高低能反映模型“独立干活”的能力,而不仅仅是“回答问题”的能力。78.3% 这类数字需要放在该测试的难度分布下理解,跨测试或跨厂商的分数并不能直接横向比较。
CAD(计算机辅助设计) 是工程和制造领域的核心工具,传统上依赖专业人员手动建模、约束尺寸并反复校验。让 AI 完成 CAD 任务,难点不只是生成图形,而是要理解几何约束、装配关系和物理合理性,并把设计意图转化为可执行的建模步骤。Astra 在 CAD 测试中从 62.6% 提升到 82.5%,意味着模型能更可靠地把自然语言需求转成结构化的三维设计流程,并调用 Blender、Python 等工具完成计算与可视化。这类能力若稳定下来,会改变产品设计初期的迭代方式。
Sol:低价高能的性价比杀手
Sol的性能不如Astra耀眼,但它对整个AI行业的冲击可能更大——因为它足够便宜。在真实代码任务测试中,Astra拿到44.2分,Sol拿到43.8分,差距只有0.4分;但完成同样一项测试任务,Astra平均花费5.97美元,Sol只需1.29美元。用大约五分之一到四分之一的价格,就能获得非常接近的编程表现(UP主原话提到“1%左右的钱”,结合其语境应理解为相对上一代或特定对比下的成本感知,确切比例以官方数据为准,此处不做精确断言)。
Sol与上一代相比API单价没有上涨。对于每天调用数百万甚至数千万次AI的科技公司来说,这笔账非常划算。
科研、安全与自我改进:技术报告里的隐藏信息
除了性能和价格,技术报告中还有几个值得关注的信号。Astra的科研能力明显提高,在科学研究工作流测试中得分从68.1%提升到77.1%,能更有效地分析科学数据,甚至帮助研究人员发现AI训练过程中的问题。网络安全方面,Astra的安全代码开发测试成绩从48.7%提高到65.7%,安全补丁修复能力也有明显进步,未来AI可以更多地协助程序员检查漏洞、修复代码。但反过来,黑客利用AI寻找漏洞的能力也在增强,因此OpenAI对高风险网络安全功能设置了严格限制。
最引人注目的是,OpenAI首次将对外发布模型的AI自我改进能力评为HIGH级别。这并不意味着AI已经可以脱离人类无限升级,而是说它对AI研发的帮助,按官方评估已经相当于给研究人员额外配备了一名优秀的研究工程师助手。以前人类用AI提高工作效率,现在研究下一代AI时,也开始有越来越强的AI参与进来。
AI 自我改进(self-improvement) 指的是模型参与改进 AI 系统本身的能力,例如辅助研究人员设计实验、分析训练日志、定位训练异常、生成或审查代码。OpenAI 将其评为 HIGH 级别,并不是说 AI 能脱离人类自主无限升级,而是按官方评估,它在 AI 研发流程中提供的帮助已相当于一名优秀的研究工程师助手。这一评级的意义在于:AI 研发的迭代速度可能因 AI 的参与而加快,同时也带来对可控性和监督机制的更高要求。
两个加速过程正在同时发生
Sol不断降低使用成本,Astra持续拉高能力上限,未来AI的发展可能呈现两个同时加速的过程:一边是更强的AI帮助研究人员开发下一代模型,另一边是更便宜的AI进入企业,承担更多原本由人类完成的工作。据UP主透露,Sol已在ChatGPT中上线,实际体验是否真能媲美竞品,还需要用户自己去验证。
这次发布传递的核心信息不是某个单项跑分,而是成本与能力的剪刀差正在迅速扩大——当高性能AI的价格降到企业可以大规模部署的水平,AI智能体的普及速度可能会超出很多人的预期。
相关推荐
从讲坛到参议院:牧师参议员谈何谓罪
一位同时担任埃比尼泽教会牧师和美国参议员的访谈片段:他坦言在华盛顿的经历让他对罪与傲慢有了新认识,布道反而因此更有力量,甚至将华盛顿与所多玛、蛾摩拉相提并论。
TechCrunch Mobility:机器人对比人类的A/B测试
TechCrunch Mobility专栏聚焦交通未来与AI角色,讨论机器人对比人类的A/B测试。本文解读该实验的背景、测试设计挑战及对出行行业的启示,分析人机协作的边界与评估逻辑。
Leonida 项目:将 Xbox 版 GTA 6 重编译到 PC 的开源尝试
Leonida 是一个试图对 Xbox 版 GTA 6 进行重编译、让游戏运行在 PC 上的开源项目。本文分析其技术路线、社区争议与对 PC 游戏生态的意义。