GPT-6.2双模型实测:Astra与Sol造钟做游戏差距有多大
GPT-6.2 Astra 与 Sol 三项实测:执行力强但美学与机械深度仍逊 Anthropic 系。
文章通过 Blender 造钟、霓虹立方体射击、方程式赛车三项同题测试,对比 GPT-6.2 Astra、GPT-6.2 Sol 与 CloudFable 5.2、Opus 5.5。Astra 执行力强、响应修改意见、预算花得极快,两款游戏约 5 小时撞上 200 美元上限;Sol 极便宜,不到 5 美元完成钟表工坊、197 美元完成三项测试,但存在敌人触发缺陷和赛车掉到 2 帧的性能问题。造钟一关两模型齿轮啮合正确却都缺少擒纵机构,钟不会走,而 Fable 与 Opus 做出了真正会走的钟。游戏与美学层面 Anthropic 系仍领先。结论是模型竞争正从“能否完成”转向预算效率、agent 调度与审美细节等工程层面。
OpenAI 同时放出 GPT-6.2 Astra 和 GPT-6.2 Sol,官方定位很清晰:Astra 攻坚最硬核的专业工作,Sol 走日常路线、价格只有四分之一。B站 UP 主用同一套三项测试——Blender 造钟、霓虹立方体射击、方程式赛车——把两款模型彻底跑了一遍,并拉上 CloudFable 5.2 和 Opus 5.5 做横向对比。结论比跑分表复杂得多:Astra 确实能干活,但游戏和美学上的差距依然存在;Sol 便宜到离谱,却也在关键处暴露了妥协。
测试规则:三关同题,预算封顶
三项测试沿用上周 CloudFable 5.2 的同一份简报和同一套规则。第一关 Clockwork,在 Blender 里搭一间老钟楼里的钟表匠工坊,只给一段提示词,不给参考图;第二关 Neon Cube,在巨型立方体内部的霓虹街道里做射击游戏;第三关 Formula,做一款与 AI 车手对战的赛车游戏。后两款游戏都在 Godot 引擎里完成,统一开超高 effort、最多 3 个辅助 agent,全程关闭图像生成,费用按各自日志里的 API 估价计算。游戏测试设 200 美元硬顶,并在 100 美元处检查一次、给出修改意见。
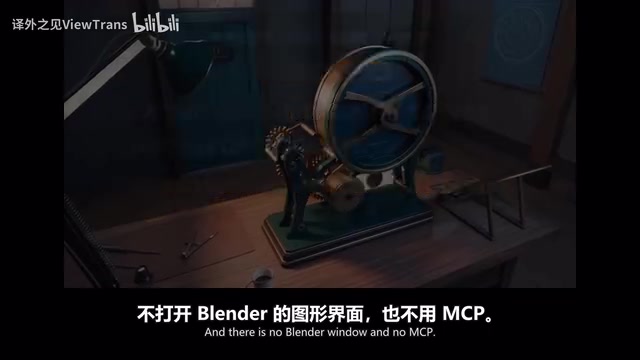
第一关的特别之处在于:没有 Blender 界面,也没有 MCP,模型必须自己写 Python 脚本,从命令行以 headless 方式驱动 Blender。这相当于把“会不会用工具”直接摆上台面。
headless 模式与 MCP 的作用差异
Blender 的 headless 模式指不启动图形用户界面,直接通过命令行执行 Python 脚本,由 bpy 模块操控场景、对象、材质与渲染。这种模式下模型无法“看到”界面、也无法用鼠标点击,所有操作必须转化为精确的 API 调用,因此能直接检验模型对软件对象模型的理解深度。MCP(Model Context Protocol)则是一种让模型调用外部工具服务器的标准协议,若 Blender 提供 MCP 接口,模型可通过结构化工具描述完成操作,容错率更高。测试刻意禁用 MCP,等于剥掉了这层“扶手”,要求模型自己编写并调试脚本,从而暴露它在无工具提示时的规划与纠错能力。
造钟实测:齿轮对了,钟却不走
Astra 搭出的工坊细节不少,背景大窗、桌面上散落的物件都很丰富,但大钟看上去偏厚重。Sol 的钟更重,可把两者并排放在一起,布局几乎一模一样:背后大表盘、中间拆开的钟、旁边的齿轮、左侧的玻璃。简报只要求这些元素存在,位置由模型自己决定,而两个模型不约而同选了同一套摆法。UP 主检查过文件锁,两者从未打开过对方的文件夹,不存在互相偷看。更早的 GPT-6 Astra 虽然布局不同,配色却高度相似——同样的绿金搭配,表盘上同样的星图,两个新模型甚至都用了“7”这个数字。
真正关键的问题是:钟走不走?逐轮测量之后,三个齿轮啮合正常、转向相反、转速与齿数严格对应,机械结构没毛病。但摆锤只是自己在晃,不驱动任何东西,没有擒纵机构。两个模型交出的都是一个带摆锤的齿轮箱,而不是一台真正会滴答走动的钟。而 CloudFable 和 Opus 在这一关都做出了真正的擒纵机构。
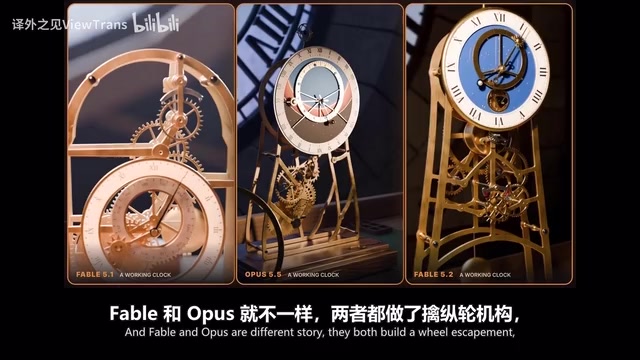
价格上,Astra 花 18 美元,Sol 不到 5 美元。横向看全部历史成绩:Fable 5.2 是 36 美元,Opus 5.5 是 42 美元,GPT-6 Astra 是 30 美元,Kimi 是 16 美元,老款 Fable 5.1 高达 125 美元。Sol 是这项测试有史以来最便宜的模型,UP 主也直言,它同时是表现最差的那个。
擒纵机构为何是机械钟的核心
擒纵机构(escapement)是机械钟表里把持续动力转化为规律 tick 的装置,典型结构由擒纵轮与擒纵叉组成:摆锤或摆轮每摆动一次,擒纵叉便释放一齿,同时给摆锤补充能量维持振荡。没有擒纵机构,齿轮组只能空转或被摆锤随意带动,转速不受控,也就无法计时。对模型而言,这要求它理解“能量传递链路必须闭合”这一物理约束,而不只是让零件在视觉上啮合。齿轮啮合正确只证明了几何关系,擒纵缺失则说明模型没有建立“钟表是一个受控振荡系统”的功能模型——这正是本轮测试区分模型深度的关键点。
霓虹立方体:Astra 把预算花光,Sol 只花了一半
射击游戏这一关先看 Astra。前期版本就能在墙上正常行走交战,射击手感不错,手持枪械的位置也对,但敌人太少、右键没有瞄准、夜色偏亮。Sol 则慢得惊人,花了 9 个小时才用掉第一个 100 美元,UP 主不得不催促它多用 agent、把预算花出去。真正玩起来街上一个敌人都没有——敌人要等你打开某个继电器才会出现。
配色上,GPT 系列自成一派:Sol 6.1、Sol 6.2 和 Astra 6.2 观感相近,整体更亮、橙色更淡,其中 Astra 6.2 最好。但 UP 主更偏爱 Anthropic 系模型的风格,认为 Opus 和 Fable 虽然各有短板,审美上却更有辨识度。
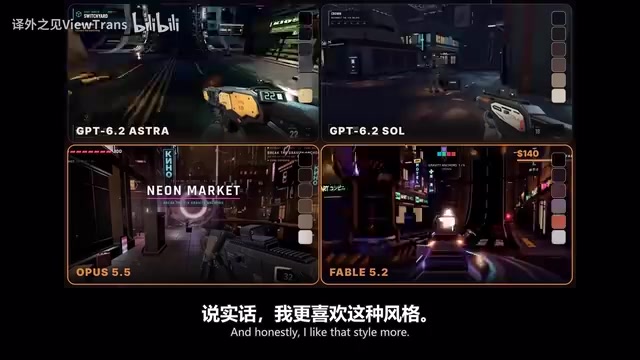
提交一轮意见后继续迭代:Astra 的右键瞄准生效、夜色变暗,200 美元预算一分不剩全部花完;Sol 把敌人直接放进街道,最终只花了 145 美元。Astra 版本里有一处细节让人印象深刻——地面积水能真实反射上方的招牌和建筑,模型为此专门写了一个 shader。Sol 的街道只有路灯的微弱反光。即便如此,UP 主仍把这一关判给 Fable 和 Opus,理由是风格与美学更对胃口。
地面积水反射与自定义 shader
地面积水反射招牌和建筑,通常需要屏幕空间反射(SSR)或平面反射(planar reflection)实现:前者复用已渲染画面的深度与颜色缓冲做射线步进,后者用镜像相机再渲染一次场景。Astra 专门写了一个 shader,意味着它在 Godot 中自行处理了反射矩阵、法线扰动与菲涅耳衰减等环节,而不是简单贴一张环境贴图。这类效果在游戏里属于“观感放大器”,但对性能与正确性都敏感。它能主动实现这一细节,说明模型具备一定的图形学知识储备与引擎 API 检索能力;而 Sol 只做出路灯微弱反光,则反映其在视觉丰富度上的投入明显保守。
方程式赛车:Astra 修好了操控,Sol 掉到 2 帧
赛车关同样是 200 美元上限、100 美元处检查。Astra 前期画面不错,但根本没法开——每个弯道都把人转圈甩出去,背景偏弱,座舱里手指的形状也明显不对。Sol 这边 UP 主犯了个错:因为预算消耗太慢,他允许 Sol 提前交卷,结果 27 分钟后、只花 28 美元就交了出来。就这个价格而言不算差,远好于上次的 Sol 6.1——有山丘、低多边形树木和相当漂亮的天空,转向甚至比 Astra 还好开,但整体像玩具,缺乏速度感,引擎声单薄,方向盘上的手部建模很糟。
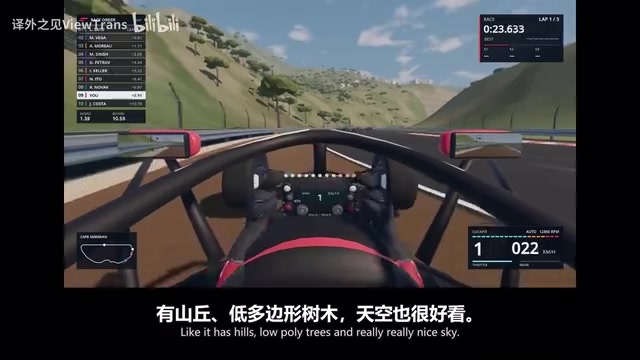
修完一轮后,Astra 的驾驶问题解决,不再每个弯道打转,还新增了观感极佳的山脉、四种树木和带钟楼的村庄,预算再次花光。Sol 的车变重了、镜头会随速度反应、引擎声更响、光效是新的,但有一个无法回避的问题:游戏里存在一个固定时刻,每次尝试都会掉到约 2 帧每秒。UP 主表示不再继续修。这一关的赢家仍是 Fable 和 Opus,细节差距明显,比如手部建模,操控手感也更好;Anthropic 系模型虽然更慢,但对游戏的理解更到位。
固定时刻掉帧的常见成因
赛车场景在某个固定时刻骤降到约 2 帧每秒,通常不是随机波动,而是触发了某个高开销事件:例如首次加载远处区块、生成大量粒子或阴影、编译着色器、或某段脚本在特定赛道位置集中执行物理查询。帧率“固定时刻”复现,说明它与游戏内时间或位置强相关,而非硬件热降频。对模型来说,定位这类问题需要读性能剖析数据、检查场景树中动态实例化的节点,并判断是渲染瓶颈还是脚本阻塞。Sol 未能修复,暴露的是调试链路不完整——它能写出可运行的原型,却缺少系统性的性能归因能力。
账单与结论:快枪手 Astra,廉价工 Sol
三项测试总花费:Astra 419 美元,Sol 197 美元,上周的 Fable 5.2 是 357 美元。最明显的规律是 Astra 花钱极快——两款游戏都在约 5 小时内撞上 200 美元上限。
综合来看,GPT-6.2 Astra 是一个执行力很强的模型:能把活干完,听得进修改意见,给多少预算就花多少。Sol 便宜、略显懒散,但 5 美元造出一间钟表工坊这件事本身就足够惊人。游戏品类上,Fable 和 Opus 依然领先,不过 Astra 已经贴得很近。
对真实使用者来说,这组测试给出的信号是:模型之间的差距正在从“能不能完成”转向“完成后好不好用”。预算消耗速度、agent 调度策略、对修改意见的响应质量,这些工程层面的表现,往往比跑分表更能决定一次任务的实际成本。Astra 适合需要一次做对的硬任务,Sol 适合对成本敏感、可以接受粗糙结果的场景;而如果目标是游戏或视觉审美,Anthropic 系模型目前仍是更稳的选择。
相关推荐
WorkBuddy零基础入门:AI智能体实战教程
基于B站系统教程,详解WorkBuddy AI智能体的核心定位、四层技术架构与实战表现,对比豆包等聊天工具的执行能力差异,分析其免配置、免费额度、生态集成三大优势,适合零基础用户入门AI智能体自动化办公。
GLM 5.5来袭:Claude攻克167年黎曼猜想?
Claude与数学家声称证明悬置167年的黎曼猜想,智谱GLM 5.5发布在即,Google Loop自主智能体曝光,Thinking Machines开源Inkling 2 Mini。本周AI圈从提效工具迈向科学发现。
AI编程让构建变便宜,但维护没有
AI编程智能体让内部工具构建成本大幅降低,但维护成本并未同步下降。本文分析工具泛滥带来的隐性负债,并提出清单、负责人、复用优先三条治理原则。