GPT-6 Astra 实测:20+真实案例与付费决策指南
GPT-6 Astra 能跑 20+ 真实任务,但问题定义与验收标准才是决定成果的关键。
本文基于 20 余个公开案例,系统梳理了 GPT-6 Astra 在三维城市、建筑、绘画设计、游戏原型、软件操作和工程流程等方向的真实表现。文章着重提醒三点容易被忽视的判断误区:游戏类案例必须区分搭建建筑、写原型和让模型当玩家三种完全不同的任务;API 单价相差 2.5 倍不等于项目总成本的倍数,复杂任务的实际账单可达数千美元;模型输出流畅并不等于任务完成,验收必须依赖运行结果截图等实证。作者推荐的工作流是:用 Astra 做产品规格确认与有证据的验收,用经济模型执行,靠工单与接口约定分工协作,最终指出当原型生成变得容易,问题定义、取舍与验收能力才是真正拉开差距的地方。
GPT-6 Astra 发布后,社区里已经涌现出大量真实使用案例——从把曼哈顿搬进虚幻引擎,到写一个类似《我的世界》的游戏原型,再到设计电路板和处理 Excel 表格。这篇文章基于 B站 UP 主整理的 20 多个公开案例和演示画面,带着三个核心问题梳理 Astra 的真实能力:它交付了什么、用什么方式完成、结果到了什么程度。看完之后,你应该能判断自己手头的下一件事,值不值得交给 Astra。
需要先声明一个前提:很多演示视频经过剪辑加速,播放速度不代表真实执行速度。所谓「几分钟完成」多是作者自述,实际迭代往往需要更长时间。
三维空间与建筑:把想法变成可讨论的东西
最抢眼的一类应用是三维空间构建。有作者把曼哈顿搬进虚幻引擎,从高空俯瞰到街面视角都能切换,这个工程持续迭代了一周;另一位把杭州做成网页地图,西湖、雷峰塔和城市建筑连在一起可旋转缩放,原帖给出的制作时间是 24 分钟。
城市案例最值得借鉴的地方,是把抽象想法变成可以「指着讨论」的东西。做景区导览可以先挑三个地标和一条线路,展厅方案可以先确认入口、展区和参观动线。空间比例和真实地理仍要核对,但讨论不必一直停在文字层面。
建筑与室内也是热门方向——楼层、玻璃、绿植、餐厅、庭院住宅、办公室设施都有人尝试。但要清醒地认识到:一个房间看上去很像,并不说明门能正常打开、家具尺寸合理或空间能按方案施工。普通人可以先拿它做布局讨论、比较两个方案的动线,把用途说清楚,模型输出才会正确。
绘画、设计与网站:修改方式比第一张图更重要
第二类是绘画和设计。有人让模型用 SVG 代码「画」出物件和人形,线条、颜色、形状都由代码描述、之后还能继续调整;也有人重现从线稿到上色的绘画过程。
这里有两条需要分清的技术路线:写 SVG 是把线条、形状和颜色写成代码,由浏览器显示;操作绘图软件则要在界面上选工具和图层。两者都能出图,但修改方式、所需工具和出错的位置完全不同。对实际项目来说,能否方便修改往往比第一张图更重要。
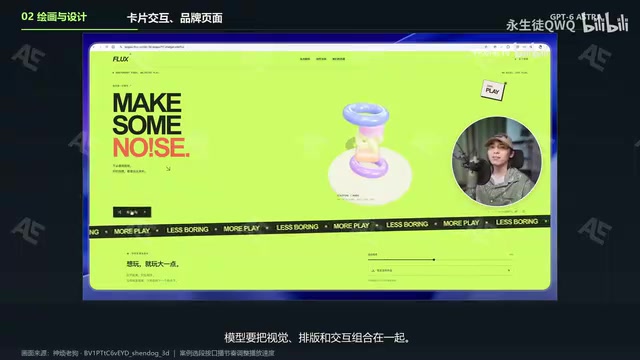
设计不只是一张图,还包括会翻转的卡片界面、带三维物件的品牌页面。同一主题可以生成多种风格的网站——有的克制、有的鲜艳、有的直接把三维物件当主角,让你先挑方向再继续完善。抽象三维和粒子效果适合做视觉实验,但真正放进网站还得考虑手机端流畅度、文字可读性和动画会不会抢走重点。一个实用建议是:先让它做 10 秒可循环的背景,再测加载和滚动,而不是无限加特效。
SVG(Scalable Vector Graphics)是一种基于 XML 的矢量图形格式,用代码描述点、线、曲线和填充色,文件本身就是可读的文本。因为是矢量而非像素,放大缩小不失真,也可以直接在浏览器里渲染,无需额外插件。用 AI 生成 SVG 的优势在于:输出结果是纯文本,模型可以逐行修改某个形状的颜色或坐标,而不必重新生成整张图;设计师也能直接打开文件查看并手动调整。相比之下,让模型操作 Photoshop 或 Figma 这类图形软件,则依赖屏幕截图识别当前状态,每一步都要确认界面是否响应,出错的位置更难定位,回滚也更复杂。
游戏与《我的世界》:三种任务不能用同一标准评价
游戏类案例最容易看混,务必分清三种不同任务:
- 在已有游戏里搭建建筑——如江南园林、亭台水井回廊,重点是空间布局;
- 写一个类似的游戏原型——能移动、挖掘、打开合成界面,重点是把地形和交互接起来;
- 让模型当玩家——读取截图并操作键鼠。
相同的方块画面不能用同一个标准评价。素材中还有《英雄联盟》风格演示、台北版 GTA(人物能走在街上并切换驾驶)、卡丁车竞速、恐怖游戏、以及割绳子这类轻量小游戏。
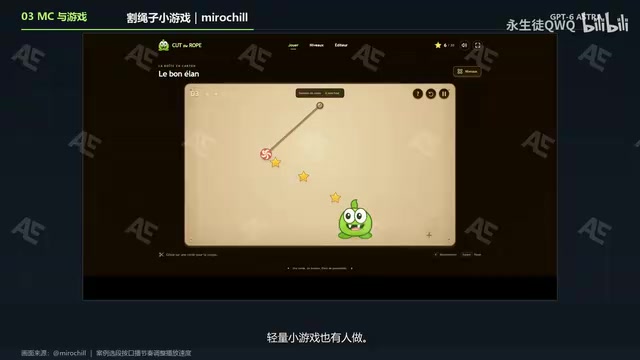
射击和城市游戏最吸引人的地方是原型出现得很快,但一次移动成功不等于碰撞和存档都正常,单机能跑也不等于多人同步已经完成。真正想做游戏,可以先定一个能走完的小关卡,把「移动、一次交互、重新开始」全部接通,再往外扩展。对个人创作者来说,最有价值的往往不是复制一款大作,而是验证一个自己的玩法——比如一间会变化的房间,做得小一点才容易看清玩家到底觉得哪里有意思。
操作软件与工程流程:验收标准来自你的业务
第四类是直接操作软件。比如「我不是机器人」这类每关规则都在变的网页游戏,模型需要读懂当前画面再决定下一步。电脑操作的关键,是把观察和动作接成循环——点了按钮要检查页面是否真的变化,文件保存后要确认能重新打开。评价这类能力应该看完整任务是否完成,而不是鼠标动得有多快。
工程方向也出现了电路板设计、三维模型到 3D 打印的流程,以及更贴近日常的 Excel 表格和文档处理。这些都是把模型输出接到专业工具上。但表格不能只看外观整齐,还要检查公式和来源;电路板不能只看布局像样,还要有懂业务的人核对规则。工具让模型能动手,但验收标准仍来自你自己的业务。 最适合先自动化的,是你能明确判断对错的那一段流程。
价格与智力指数:别把单价倍数当成项目总成本
关于智力表现,作者特别提醒:不能沿用「两边都是 61 分」的旧说法。据 Artificial Analysis 9 月 9 日发布的评测,Astra 最高思考档得分是 53 分,比对照的 Soul 高 6 分。分数必须连同日期和测试设置一起看。
价格方面,截至核对时,普通长度请求的 API 文本价格,Astra 每百万输入/输出 Token 分别为 10 美元和 50 美元,Soul 为 4 美元和 20 美元,单位价格相差 2.5 倍。以 10 万输入加 1 万计费输出为例,Astra 约 1.5 美元,Soul 约 0.6 美元。但这只是纯文本计费,不含工具费和缓存,别直接把 2.5 倍单价当成项目总成本的倍数——模型可能用更少输出完成工作,也可能在复杂任务里持续消耗。
一个真实账单值得警醒:Gary Chen 自述为台北版 GTA 原型花了约 2300 美元,得到的是半成品。他的提醒很清楚——模型愿意继续跑,并不等于继续跑就值得。预算上限、最多重试次数、何时缩小目标,都应提前说清。
Token 是大语言模型计费和处理的基本单位,大致对应一个英文单词或半个汉字,实际换算因语言和分词器而有所不同。API 调用时,输入(发送给模型的全部文字,包括系统提示、对话历史和当前问题)和输出(模型生成的回复)分别计费,且输出价格通常高于输入。"百万 Token"是标准报价单位,例如 Astra 输入 10 美元/百万 Token,意味着发送约 75 万个英文单词的内容才花 10 美元;但在多轮对话或带有长上下文的自动化流程中,每次请求都会把历史对话全部重新传入,Token 消耗会随对话轮次快速累积,这正是复杂项目实际账单远超单次估算的主要原因。
推荐工作流:Astra 做判断,经济模型做执行
作者给出的核心建议是:把 Astra 放在影响全局的判断点上,先明确产品规格、系统架构、接口约定和执行手册,再由 Soul、Terra、Luna 等经济模型执行,最后让 Astra 做「有证据的验收」。
这套方法拆成几个关键环节:
- 产品规格:先回答做什么、不做什么、成功长什么样。范围越具体,后面越容易判断某个新功能是必要工作还是临时扩张。
- 系统架构:把显示、数据、样式、素材分开存放,替换一部分不会牵动整个项目。
- 接口合同:约定交接格式,比如每个作品必须有标题、封面、简介、链接,字段名统一。
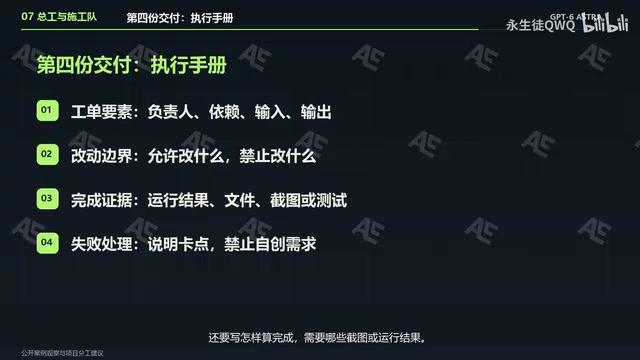
- 执行手册:每张工单写清负责人、依赖、输入输出、允许与禁止修改的范围,以及怎样算完成、需要哪些截图或运行结果。卡住时报告缺了什么,而不是为了交差自己编一个。
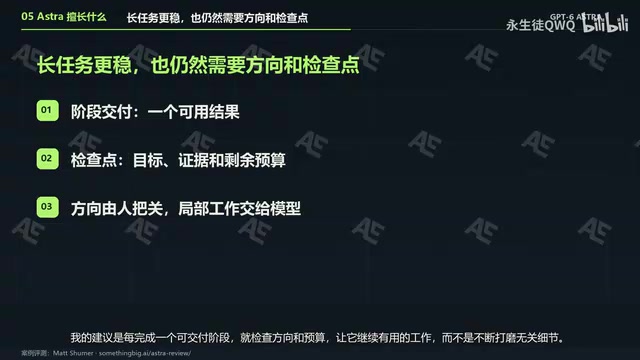
验收环节尤其关键:让 Astra 验收时,要同时给它修改内容、运行结果截图和最初的验收标准,它应逐项回答通过还是退回、依据是什么。没有真实运行证据时必须列出待验证事项,不能因为解释写得流畅就宣布完成。
文中提到的 Soul、Terra、Luna 属于同一产品线内按能力和价格分级的模型系列,"经济模型"指其中成本较低、适合高频执行任务的版本,类似 OpenAI 产品线中 GPT-4o mini 相对于 GPT-4o 的定位。这种分层使用策略的核心逻辑是:推理和判断类任务(确认架构、检查输出是否符合标准)对模型能力要求高,但调用次数少;代码生成、格式转换、批量文案等执行类任务调用频繁,用经济模型可以大幅压低整体成本,同时把顶级模型的算力留给真正需要全局判断的节点。
结语:真正拉开差距的是问题定义
这套方法最适合从一个小项目开始试——做作品网站、展厅小样,或把一个重复的资料整理流程完整跑一轮,记录用量、卡点和你实际返工的时间,再决定哪些判断交给 Astra、哪些步骤继续用更精细的模型。
当做出原型变得容易,真正拉开差距的就会是问题定义、取舍和验收。你知道自己为什么做、知道什么必须准确、也能判断什么时候已经够用——到那时,模型的能力才会真正变成你的成果。
相关推荐
Jev模型爆火:专为Agent设计的极速判断引擎
Jev模型在国内AI圈爆火,搜索热度全球第一。这个专为Agent判断设计的小模型70毫秒出结果、成本便宜几百倍,本文解析其原理、置信度分层策略及四个值得改造的Agent落地场景。
AI没有意图也没有动机:重新理解智能与自主性的边界
Hacker News热议"AI没有意图也没有动机"这一论断。本文剖析大语言模型作为概率预测系统的技术真相,探讨拟人化陷阱、AI安全的正确框架,以及为何清醒认知AI本质对产品设计与公共叙事至关重要。
arXiv获1720万美元资助 独立运营为科研开放铺路
全球预印本平台arXiv获得Simons Foundation、XTX Markets和Siegel Family Endowment共计1720万美元的多年期慈善资助,支持其转型为独立非营利组织。本文解析这笔资金对开放科学与AI研究生态的深远意义。