GPT-6 Astra vs Claude Opus 5.5:一次全面碾压的实测对比

实测对比Claude Opus 5.5与GPT-6全系列,前者在交流感、设计审美、代码能力与长程任务稳定性上全面领先。
作者以重度AI创作者身份,将Claude Opus 5.5与GPT-6 Astra、Soul、Luna在真实工作流中进行横向测评。GPT-6系列问题集中在三处:Astra涨价却无实质提升,Soul/Luna降价但性能倒退、指令遵循差、Skill召回混乱;文案风格晦涩破碎,UI设计爱堆砌无意义文字;Codex代码审查给出的建议几乎无法理解,且生成的框架充斥测试冗余和硬编码补丁。Opus 5.5则在设计克制度、框架review可读性、动画代码实现能力上均表现突出,价格比前代便宜40%,100万真实上下文加上更快的响应速度,使其成为作者目前认为最值得订阅的模型。
作为一名日常重度依赖AI模型完成PPT生成、视频制作、代码框架搭建的创作者,我把最近发布的GPT-6全系列和Claude Opus 5.5都拉到真实工作流里跑了一遍。结论很直接:Claude Opus 5.5的使用体验远超GPT-6 Astra,而且是今年以来Claude和GPT两家模型差距最大的一次。
这篇文章不谈跑分榜单,只讲实际做事时能感受到的差异——交流感、审美、代码能力、长程任务的稳定性,以及那些让人抓狂的细节。
GPT-6全系列的尴尬:版本涨了,体验反而退了
GPT-6 Astra相较于上一代GPT-5.6,除了电脑自动化任务和建模能力有提升外,几乎看不到进步。问题在于,自动化和建模对大多数人并不是刚需。多数人真正需要的是:交流感强、写文案有人味、创意和审美在线、代码能力扎实、长程任务里指令遵循稳定的模型。这些维度上,GPT-6 Astra相对GPT-5.6几乎没有提升,价格却贵了一大截。
更让人费解的是随后推出的GPT-6 Soul和GPT-6 Luna。它们相比上一代同型号降价了50%到60%,听起来是好事,但实际体验完全追不上前代。同样叫Soul,版本号涨了,性能反而下降。
GPT-6 Luna这两天的表现尤其糟糕:指令遵循性很差,对Skill的召回能力也差。让它实现一些很简单的Skill都能写出明显错误,比如擅自把项目名称翻译成中文,写日报时把日报规范本身也一股脑写进了日报内容里。这些低级错误,本不该出现在GPT这个级别的模型身上。
我每天固定的任务流程——做PPT、生成封面、加字幕、自动分发视频——之前用GPT-5.6 Luna基本没出过问题。换成GPT-6 Soul后,它甚至会把字幕样式加错,看了Skill也没理解含义,索性自己重写了一套字幕样式。当你需要频繁地人为介入去纠正它,本身就说明这个模型的执行能力不行,使用体验自然很难受。
GPT晦涩的文案:每个字都认识,连起来不认识
GPT模型一直以来交流感很差,这几乎是它独有的问题。它写的文案不是传统那种"AI味",而是语法破碎、用词晦涩,读起来非常煎熬——每个字都认识,连起来就是不认识。
无论是让它做PPT、做网页,还是写脚本、写日报,输出的文案永远达不到预期。不管你用什么Skill、什么提示词去约束,效果就是烂。
对Codex的评价也类似。如果你对AI的驾驭能力没那么强,很难用Codex做出好项目。除非你本身很有创意、很懂技术、对产品有洞察,能够人为地给它一个明确方向;否则给它一个模糊目标让它自己迭代几小时,它只会堆出一堆看不懂的东西。它写出来的代码往往门禁多、屎山重,喜欢写硬编码的if-else逻辑,然后再给每个if-else写测试,每加一条新逻辑就打个补丁,还得再测这个补丁是不是真补丁。
Codex是OpenAI推出的代码专向智能体(Coding Agent),有别于GPT-6对话模型,它以异步方式在沙盒环境中自主运行,接收一个目标后会独立拆解任务、写代码、执行测试,有时需要数小时才返回结果。这种"扔给它一个方向让它自己跑"的模式,在目标明确时效率极高,但也意味着一旦方向模糊,它会不断自我迭代却偏离初衷——积累大量测试脚手架、硬编码逻辑和补丁式if-else,也就是作者所说的"屎山"问题的根源。理解这一点有助于解读后文对Codex生成框架的批评:问题不只是代码风格,而是智能体在缺乏明确约束时的系统性失控倾向。
UI设计对比:Opus的克制 vs GPT的"塞字强迫症"
用同一个Skill让两个模型做网页设计,差异非常明显。
Claude Opus 5.5能很好地理解Skill里关于图片生成的规范,生成透明底的素材并铺在页面上,还能按要求产出三种不同风格——磁带风、胶片风、扁平风,配色舒服,CTA区域还做了拟态小按钮,整体很有设计感。
GPT-6 Astra的设计能力其实也不错,配色、排版都挺大胆,第一眼看着舒服。但它有个致命毛病:只要哪个位置能塞一行字,它就一定要塞进去。到处都是没有意义的小字,即便Skill里已经明确要求"不要到处写这些没有意义的文字",它依然我行我素。
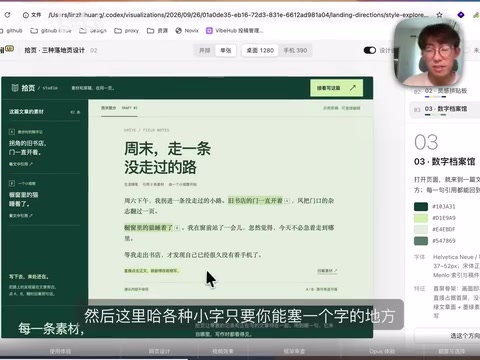
更离谱的是它的文案经常不知所云。让它做一个UI设计稿,它会往页面上写"概念产品设计演示"这种没有任何真实网站会出现的文字。这些堆砌的元素让整个设计变得破碎,不够克制,缺乏高级感——乍看舒服,真要微调时你很难让它写出准确传达意图的文案。
复杂框架Review:谁的建议才是人话
最能体现两个模型差距的,是让它们review我那个用Codex搭了很久的视频生成框架。
这个框架我用GPT-6 Astra反复优化过很多轮,想精简规范、程序化能程序化的部分,但一直改不好。用Opus 5.5做了一次review后,它直接指出:整个流程写了1.4万行Python和JS,而真正决定画面的源码只有651行,其余大量是完全没用的测试。
Opus还点出了GPT留下的一堆坏习惯:Progress文档里大段篇幅都在讲高亮、2px、截图几何复测、字幕断句,没有一条是在讨论"某个镜头怎么抓人"。GPT特别喜欢钻牛角尖——你让它修过一个像素问题,它就把这个具体到某句话的问题精细地写成一条规则,越积越多。它的review规范设计得很细,但几乎每部片都写着"完整元素视听未完成",也就是说规范写多了后续根本没人遵循,只剩登记,对迭代毫无帮助。
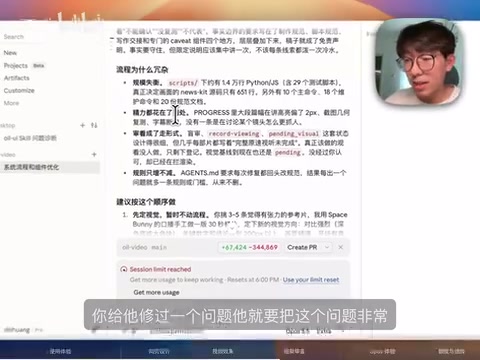
对比之下,同样的提示词交给Codex来review,它给出的五个问题我一句都看不懂——"新工程无法直接走宣称的主路径""任意模型尚未实现writing model可改模型名"……作为亲手实现这个框架的人,我都不知道它在表达什么。而Opus写的问题,任何人来看都能明白,总结也很到位。这直接决定了项目能否被迭代好。
Skill在这里指作者预先编写的结构化提示词文档或规范模板,类似于给模型的"操作手册"——定义输出格式、设计风格、流程步骤等约束条件,以便在重复性工作流(如PPT生成、字幕添加、视频分发)中保持一致性。Skill的召回能力,是指模型在执行任务时能否准确读取并遵循Skill中的规定,而不是自行改写或无视其中的约束。GPT-6 Luna被批评"Skill召回能力差",本质上是指令遵循的稳定性问题:模型理解了规范却不执行,或执行了错误的理解,导致用户需要反复纠正,抵消了Skill带来的自动化效率。
Opus 5.5:把顶级代码能力和交流感一起带了回来
Claude Opus 5.5是自Opus从4.5升到4.6之后最大的一次迭代。
回顾Opus的历程:4.6之后升到4.7,它丧失了以前那种很好的交流感,AI味变重、还有点自我,任务执行效果也下滑。4.7、4.8、5.0三个版本表现都很差。直到Fable 5出来,Claude才重新有了非常顶级的模型,执行效果和审美都很好,但交流感、文案可读性还是不如Opus 4.6。
而Opus 5.5,我认为是把代码能力做到了很高水准的同时,把那种得心应手、指哪打哪的交流感也带了回来。让它写Skill时,它能准确理解需求、做调研、把想要的流程精确落到文档里。
更让我意外的是它的动画和视频实现能力。网上那些让Opus 5.5用代码写出有趣动画的实测,我一开始并不相信——很难想象那些丝滑转场、高亮放大的效果是纯代码写出来的。自己实测后确认属实。我只订阅了20美元档,Opus 5.5在5小时额度内就把我之前整个框架彻底重构,并把视频做了出来,效果比我用GPT-6 Ultra煎熬许久搭建的框架还要好。
价格与额度:便宜了、快了、还更好用
Opus 5.5比之前的Opus 5价格还便宜了40%。这意味着相同提示词可能用更少的Token达到以前的效果,整体用量更充足。
上下文方面,Claude有真正的100万上下文,不会像GPT那样问几个问题就开始压缩上下文。速度上,即便没开Fast模式(可能因为我订阅档位低),也明显比GPT不开Fast时快很多,扣量也更耐用。相比之下用GPT-6 Ultra,额度扣得飞快,一天都不够用。
结语与期待
综合来看,Claude Opus 5.5是目前最好用的模型,唯一的遗憾是使用门槛偏高。而GPT-6全系列——Astra太贵、Soul和Luna又表现拉垮——目前很难推荐。
最后一点期待:希望有国产模型能沿着Claude这种调性去走,提供好的交流感,哪怕只做到Opus 5.5的80%效果,我也愿意为它付出和Claude同等的订阅价格。毕竟对创作者来说,一个真正省心、不用反复纠正的模型,价值远高于榜单上的那几个百分点。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。