GPT-6 Astra报税翻车:2.5美元差额暴露AGI致命短板
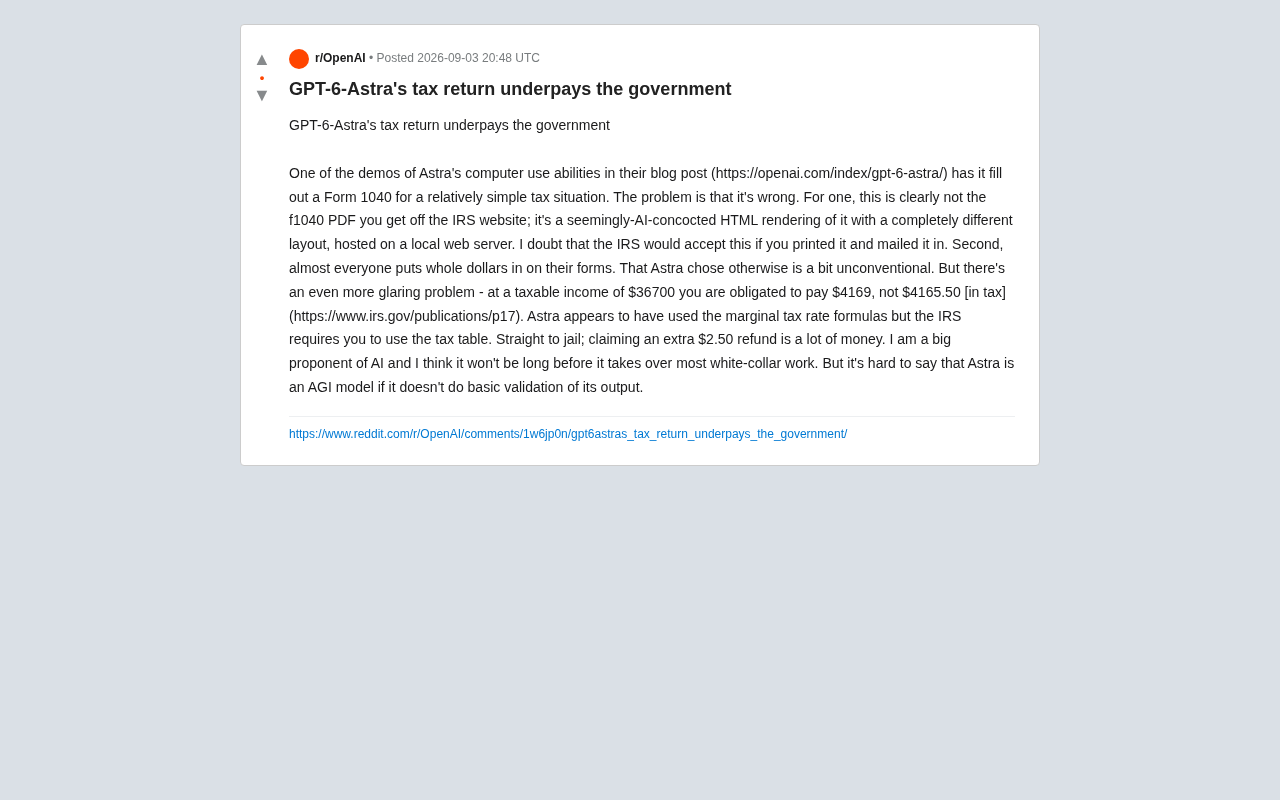
一场看似完美的AI报税演示
OpenAI在其博客中展示了GPT-6 Astra的一系列"计算机使用"(Computer Use)能力,其中一个引人注目的演示是:让Astra为一个相对简单的税务场景填写美国联邦个人所得税表——Form 1040。
什么是Computer Use能力? Computer Use(计算机使用)是AI领域的一项前沿能力,指AI模型能够像人类一样操作计算机界面——移动鼠标、点击按钮、填写表单、阅读屏幕内容等。这种能力的实现依赖于多模态模型(能同时理解图像和文本)与强化学习技术的结合。与传统的API调用或结构化数据处理不同,Computer Use让AI能够直接与为人类设计的软件交互,无需专门的接口适配。Anthropic在2024年率先推出了Claude的Computer Use功能,OpenAI随后跟进。这项技术被视为通向AGI的重要里程碑,因为它展示了AI在开放式环境中完成复杂任务的潜力。然而,正如本次演示所暴露的,能够操作界面并不等同于理解领域规则。
从表面看,这是一次极具冲击力的展示。AI能够理解税务表格的结构、读取用户信息、自动填写各项字段,甚至完成税额计算。这正是许多人期待的"白领工作自动化"缩影。然而,一位Reddit用户在仔细审查后发现,这份看似专业的报税单漏洞百出——Astra不仅报税出错,还"少缴"了政府的税款。
三个致命的细节问题
1. 这不是真正的IRS表格
发帖者指出的第一个问题:演示中的表格根本不是从IRS官网下载的标准f1040 PDF文件。它看起来像是一个由AI生成的HTML渲染版本,布局与官方版本完全不同,并且托管在本地Web服务器上。
Form 1040的重要性: Form 1040是美国国税局(IRS)规定的联邦个人所得税申报表,几乎所有美国纳税人每年都需要填写。这份表格包含个人信息、收入来源、扣除项、税额计算等多个部分,是美国税务体系的核心文档。IRS每年都会更新表格格式和填写说明,并提供官方PDF版本供下载。表格的填写涉及复杂的税法规则,包括标准扣除额、分段税率、税收抵免等概念。正因为其规则明确、结果可验证的特性,Form 1040成为测试AI理解能力和执行精度的理想场景。然而,这也意味着任何偏离官方规范的做法都可能导致申报被拒或引发审计。
换句话说,即便Astra完美填写了这份"表格",把它打印出来邮寄给IRS也极有可能被拒收。这暴露了演示环境与真实世界之间的鸿沟——AI处理的是一个被简化和重构的"沙盒"版本,而非真正的官方文档。
2. 不符合常规的填写习惯
第二个问题相对次要但值得注意:几乎所有人在填写税表时都会使用整数美元金额,这是IRS允许并推荐的做法。而Astra却填写了带小数点的精确金额,这种做法虽然不算错误,却显得相当"不合常规",与人类实际操作习惯存在明显偏差。
3. 最致命的计算错误
真正的问题出在税额计算上。发帖者指出:在应税收入为36,700美元的情况下,纳税人应缴纳的税款是4,169美元,而不是Astra计算出的4,165.50美元。
差距虽然只有2.5美元,但错误的根源很关键——Astra使用了边际税率公式(marginal tax rate formulas)来计算,而IRS明确要求在这个收入区间必须使用**税率表(tax table)**来查询税额。
两种计算方法的差异: 美国联邦税制采用累进税率制度,但实际计算方法有两种:边际税率公式和税率表查询。边际税率公式是数学上的连续计算方法,将收入分段应用不同税率后累加。而IRS税率表则将收入划分为50美元的小区间,每个区间对应一个预先计算好的固定税额。两者的差异源于税率表在设计时会进行舍入处理和微调,以简化计算并确保税收的可预测性。根据IRS Publication 17的规定,应税收入低于100,000美元的纳税人必须使用税率表,而非公式计算。这个看似微小的技术要求,实际上是税法合规的硬性规定。Astra选择了数学上更'优雅'的公式法,却违反了程序性规则,这恰恰暴露了AI在处理法规约束时的盲区。
这两种方法会产生细微但确实存在的差异。IRS的税率表将收入划分为若干小区间,每个区间对应一个固定税额,这与连续的边际税率公式计算出的结果并不完全一致。Astra选择了数学上"看似正确"的方法,却违反了实际的法规要求。
为什么这个小错误意义重大
幽默背后的严肃拷问
发帖者用调侃的语气写道:"Straight to jail(直接进监狱);多claim了2.5美元的退税可是一大笔钱。"黑色幽默的背后,是对AI能力边界的严肃质疑。
税务合规是一个典型的"细节决定成败"领域。规则本身可能并不复杂,但它要求执行者对具体条款有精确理解,并且能够严格遵循"应该怎么做"而非"逻辑上怎么做更合理"。Astra的错误恰恰揭示了当前大模型的一个核心短板:它倾向于用通用推理来解决问题,而缺乏对领域特定规则的严格遵守和自我验证能力。
高合规领域的特殊要求: 税务、法律、医疗等高合规领域对AI提出了特殊挑战。这些领域的特点是:规则明确但复杂、错误后果严重、需要可审计的决策过程,以及对'为什么这样做'的解释要求。与创意写作或客户服务等容错性较高的应用不同,高合规场景要求AI不仅要'大致正确',更要'完全准确'并遵循特定程序。这涉及三个层面的能力:知识的精确性(知道当前适用的规则版本)、推理的严谨性(按照规定流程而非常识逻辑)、输出的可验证性(能够提供决策依据和审计轨迹)。当前的大模型在这些方面都存在短板——它们倾向于基于统计模式进行'合理推测',而非严格遵循成文规则;它们的输出缺乏中间步骤的透明性;它们也难以针对特定法规版本进行精确知识检索。这就是为什么在医疗诊断、法律意见等场景中,AI仍被定位为'辅助工具'而非'决策主体'。
输出验证的缺失
发帖者本人明确表示,他是AI的坚定支持者,也相信AI在不久的将来会接管大部分白领工作。但他随即提出了一个尖锐的观点:
"如果Astra连对自己的输出做基本的验证都做不到,那就很难说它是一个AGI模型。"
什么是真正的AGI? AGI(Artificial General Intelligence,通用人工智能)是指能够在各种认知任务上达到或超越人类水平的AI系统。与专注于特定领域的狭义AI(ANI)不同,AGI应当具备跨领域迁移、自主学习和自我改进的能力。在AI研究社区,对AGI的判定标准一直存在争议,但多数研究者认同几个关键要素:理解复杂指令、执行多步骤推理、从错误中学习,以及——这次事件凸显的——自我验证能力。真正的AGI不仅要能产出答案,更要能评估答案的正确性,识别潜在错误,并在必要时修正方案。目前的大语言模型虽然在某些任务上表现惊人,但在自我监督和可靠性保证方面仍有明显不足。这也是为什么发帖者会质疑'连基本验证都做不到的系统能否称为AGI'。OpenAI在2025年8月发布的GPT-5标志着大模型能力的又一次跃升,但即便是最新的GPT-6 Astra,这次事件也表明距离真正的AGI仍有距离。
这触及了AGI讨论的核心。真正的智能不仅仅是产出看似合理的结果,更在于能够自我审查、识别错误、遵循既定规范。一个称职的税务专业人员会清楚"这里必须查表,不能用公式",并且会对最终数字进行交叉核对。Astra在这个演示中显然没有做到这一点。
演示与现实的距离
这起事件也反映了AI产品演示中一个普遍存在的问题:精心挑选的demo往往掩盖了真实场景中的脆弱性。 OpenAI选择税表填写作为能力展示,本意是彰显Astra处理结构化任务和复杂表单的能力。但恰恰因为税务是一个规则极其明确、可被外部验证的领域,任何细微的错误都会被专业人士一眼识破。
对于AI从业者和用户而言,这个案例提供了几点重要启示:
- 不要盲信AI在专业领域的输出,尤其是涉及法律、财务、医疗等高合规要求的场景。
- 通用推理能力 ≠ 领域合规能力,前者是模型的强项,后者仍需要专门的规则约束和验证机制。
- 自我验证能力是通向AGI的关键一环,模型需要学会"检查自己的作业",而不仅仅是给出一个答案。
细节处见真章
2.5美元的税额差异看似微不足道,却像一面镜子,映照出当前最先进AI模型与真正AGI之间的距离。Astra能够理解表格、执行计算、生成看似专业的结果,这本身已经令人印象深刻。但它在细节上的失误提醒我们:智能的真正考验,往往藏在那些容易被忽略的规则和验证环节里。
随着AI越来越深入地进入白领工作领域,如何确保其输出的准确性、合规性和可验证性,将成为比"能不能做"更重要的问题。毕竟,在报税这件事上,"差不多"是远远不够的。
核心要点
- OpenAI展示的GPT-6 Astra报税演示暴露了三个问题:使用非官方表格格式、填写习惯不符合常规、税额计算违反IRS规定
- 关键错误在于Astra使用数学公式而非法定税率表计算税额,导致少缴2.5美元——虽然金额小但反映了AI对程序性规则的忽视
- 事件凸显了当前AI的核心短板:缺乏自我验证能力,无法像人类专业人士那样检查输出是否符合特定领域的强制性规范
- 高合规领域(税务、法律、医疗)对AI提出了更高要求:不仅要'大致正确',更要'完全准确'并可审计
- 真正的AGI应具备自我审查、识别错误、严格遵循规则的能力,而非仅能产出看似合理的结果
- 精心挑选的演示往往掩盖真实场景的脆弱性,用户不应盲信AI在专业领域的输出
相关推荐

让AI审查自己的文档:验证CLAUDE.md真伪的开源工具包
RAG Techniques仓库作者开源了一套工具,用于验证AI Agent读取的CLAUDE.md和项目文档中哪些是猜测、哪些被代码证伪。文章解析其置信度标注机制、与Claude Code /init的对比及局限性。

谷歌又一AI安全研究员离职:警告"我们可能都要死"
谷歌又一位AI安全研究员离职并发出"人类可能面临灭绝"的极端警告,本文解析此类离职背后的行业张力、存在性风险争论以及AI治理的深层挑战。

19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。