GPT-6 Astra对决Claude Fable 5.1:四项实测全面对比
本周AI圈迎来了两大巨头旗舰模型的正面对决:OpenAI的GPT-6 Astra与Anthropic的Claude Fable 5.1相继发布。前者仍在逐步开放中,一位获得早期使用权的B站UP主(内容源自Chase AI家)对两款模型进行了从基准测试到实际项目的全方位对比。本文将梳理这场对决的关键结果,帮助你判断哪款模型更适合自己的工作流。
基准测试:GPT-6全面领先,但数字要辩证看
从纸面数据来看,GPT-6 Astra几乎在所有基准测试中都击败了Fable 5.1。不过测试者也提醒,这些百分比不应被孤立解读——例如在DeepSuite 1.1上74.1的得分,并不意味着它就实际强了7.5%。
AI基准测试(Benchmark)是衡量大语言模型能力的标准化评估体系,通常涵盖推理、编程、数学、多模态理解等多个维度。DeepSuite、Terminal Bench等新一代基准则更侧重于智能体(Agent)任务和长程推理能力。值得警惕的是,随着模型厂商开始针对性地优化训练数据,"基准污染"(benchmark contamination)问题日益严峻——模型可能在测试集上表现优异,但在真实任务中并不对等。所谓基准污染,是指模型在预训练或微调阶段"见过"了基准测试的题目或近似变体,导致测试成绩虚高。更根本的问题在于,百分比的差距在统计显著性上往往处于误差范围之内,且实验室场景与生产环境存在相当的分布偏移(distribution shift)——即训练/测试数据的分布与用户真实输入的分布之间存在系统性差异,模型在前者上的表现无法线性外推到后者。这正是测试者提醒数字需辩证看待的深层原因。
值得注意的一个细节是,Anthropic这次相对保守,很多基准测试根本没有报告数据;而OpenAI则几乎提供了你想要的所有指标。这种信息透明度的差异,本身也反映了两家公司在营销策略上的不同取向。选择性披露基准数据在行业中并不罕见——厂商通常只公布自己表现优异的测试项目,这种"挑基准发"的做法使得跨模型比较更加困难,也进一步削弱了单一基准分数的参考价值。
从整体趋势判断,测试者给出了一个精炼的结论:
GPT-6是OpenAI这边的一次重大飞跃(尤其相比5.6),而Fable 5.1更像是"带给我们更多本就喜欢的东西"——一次稳健的迭代。
成本才是隐藏的胜负手
真正拉开差距的是成本效率。在Terminal Bench 4.0的最高精度测试中,两者准确率极为接近——Fable 5.1为55.8%,Astra为56.7%。但达到这一水平的代价却大相径庭:
| 指标 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Terminal Bench 4.0精度 | 56.7% | 55.8% |
| 对应成本 | $10.35 | $19.50 |
大语言模型的API定价通常以"每百万Token"为单位分别计算输入与输出费用。Token是模型处理文本的最小单元,大致对应0.75个英文单词或约1.5个汉字,但不同模型使用的分词器(tokenizer)会导致同一段文本被切分为不同数量的Token。输入Token通常比输出Token便宜数倍,而推理类模型还可能额外计算"思考Token"(thinking tokens)的费用。换言之,GPT-6在性能与Fable 5.1相当的前提下,Token成本几乎只有对方的一半——在同等预算下,Astra可以执行约1.88倍的任务量。这一差距在大规模自动化工作流中会被显著放大:一个每天调用10万次的生产系统,年成本差异可能超过数百万美元。历史上GPT系列模型在性价比上就一直占优,这次的数据再次印证了这一点。对于需要将AI嵌入核心业务流程的企业而言,Token单价的微小差异经过调用量的乘数效应后,往往成为技术选型中最具决定性的因素。
实测一:堡垒之夜网页版复刻
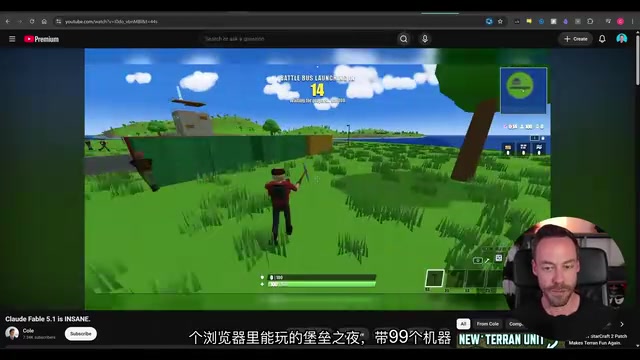
第一项测试极具挑战性——让两个模型用浏览器复刻《堡垒之夜》,要求包含99个机器人和不同武器。这个灵感来自YouTube创作者Cole的视频《Claude Fable 5.1 is insane》。
GPT-6(通过Codex)耗时约45分钟一次性生成,成果相当扎实:完整的选择界面、战斗巴士、滑翔伞跳伞、宝箱拾取、武器切换(Tab键)、护盾值系统、地图查看以及建造功能都能正常运作,甚至自带生成的音效。唯一明显的缺陷是采集资源时画面会卡顿。
OpenAI Codex在此处并非单纯的"一次性代码生成",而是结合了工具调用(function calling)、多步骤规划(multi-step planning)和沙箱执行验证的完整智能体管线。所谓工具调用,是指模型能够在生成过程中主动调用外部函数——如文件系统操作、代码编译器、浏览器渲染引擎等——来验证和修正自己的输出。45分钟的后台处理时间背后,涉及代码分解(将一个复杂游戏拆解为UI层、物理引擎、AI行为树等模块)、迭代修复(运行代码→发现错误→自动修正→再次运行)和运行时反馈等多个隐性步骤,只是这些过程对用户不可见。这与Fable 5.1通过对话轮次逐步构建的交互模式形成了架构层面的对比:前者更像"黑箱批处理"——用户提交需求后等待完整交付;后者更偏"透明交互流"——用户可以在每一轮对话中观察中间状态、提供修正指令。两种范式各有取舍:批处理模式减少了人机交互成本但牺牲了过程可控性,交互流模式则反之。
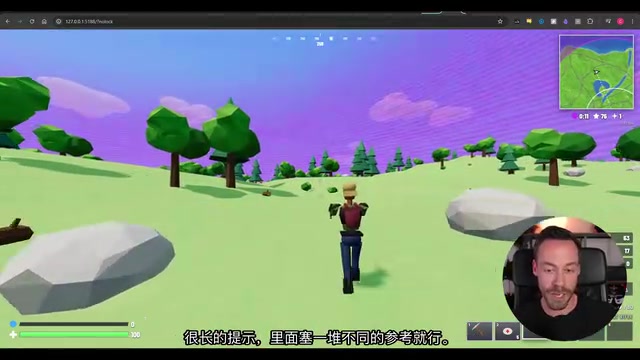
Fable 5.1则花费了约1.5小时、消耗约75万Token。虽然大厅界面元素更丰富,但许多按钮点击后毫无反应;镜头控制更不稳定,建造后的物体会"穿模",射击手感也存在明显的"光运"错位现象。整体画质与精致度略逊于Codex。75万Token的消耗量意味着这次生成的总文本量大约相当于一部中长篇小说的体量——其中包含了大量的来回调试、错误修正和重新生成,这也是对话式迭代模式的典型成本特征。
结论:单次一次性生成的场景下,Codex(GPT-6)胜出。
实测二:AI旅游网站着陆页
第二项测试聚焦前端与设计能力,要求创建一个AI旅游网站的着陆页。这原本是Anthropic模型的传统强项——Claude系列在此前的版本中凭借出色的HTML/CSS/JavaScript生成能力和较高的默认审美水准,在前端社区中建立了良好口碑——但结果却出人意料。
GPT-6生成的页面简洁干净,能自动调用其内部图像模型生成配图,整体"没有在向你喊AI",从Hero区块(即网页首屏的大幅视觉展示区域,通常包含核心标语、主视觉图和行动号召按钮)到FAQ、Footer都处理得相当到位。而Fable 5.1的输出则显得非常基础:黑色背景、左文右图的常见布局、圆角卡片、几乎没有任何动效,从浅蓝到深蓝的过渡也乏善可陈。
大语言模型生成前端UI代码的"默认审美"高度依赖训练数据的分布——如果训练语料中某种风格的组件(如Tailwind CSS的实用类组件、shadcn/ui的默认主题)占主导,模型在零样本(zero-shot,即不提供任何参考示例,仅凭自然语言指令生成)情况下就倾向于复现这种风格。Fable 5.1输出"黑色背景+圆角卡片"的保守布局,很可能正是训练数据中此类模板占比较高的体现。而GPT-6能自动调用图像生成模型填充配图,则反映了OpenAI在多模态融合(multimodal integration)方面的架构优势——将文本生成与图像生成打通为一条统一的管线,而非要求用户手动粘合。
测试者的洞察因此格外重要:
越擅长使用AI的人,模型本身反而越不重要——因为高手懂得提供参考图、知道去哪找组件库。但对于"只说给我做这个"的普通用户而言,模型的默认输出质量至关重要。
这一观点揭示了AI工具链中一个核心矛盾:随着提示工程(prompt engineering)技巧的积累,专业用户可以通过提供设计规范文档、Figma截图、组件库链接等方式大幅提升任意模型的输出质量,使得模型间的差距趋于收敛。但绝大多数用户并不具备这些技能——对他们而言,开箱即用的质量就是一切。对于企业级UI生成场景,建立统一的设计规范提示词库(prompt library)往往比单纯比较模型能力更有实际价值。就中位数输出而言,这一局同样判给了Astra。
实测三:2D动态图形讲解
第三项测试要求两个模型通过Higgs Field MCP调用同一个动态图形技能,制作一个15秒的2D动画,解释互联网消息传递(发短信)的工作原理。
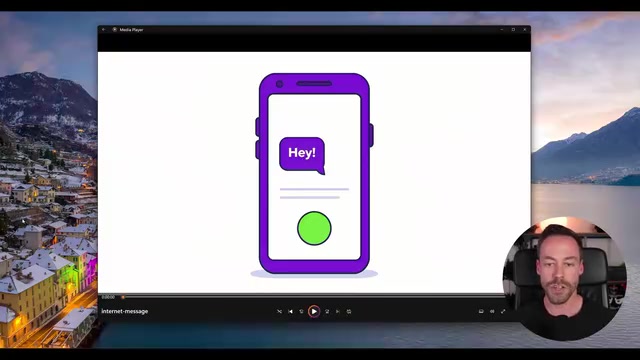
MCP(Model Context Protocol,模型上下文协议)是Anthropic于2024年底开源的标准化协议,旨在统一大语言模型与外部工具、数据源之间的交互接口——其核心理念类似于USB-C之于硬件设备:无论底层是什么模型,只要遵循MCP规范,就能以相同的方式调用工具、读取数据、执行操作。MCP定义了一套标准的JSON-RPC消息格式,涵盖工具发现(tool discovery)、参数校验(schema validation)、执行结果返回等完整生命周期。Higgs Field MCP即是基于此协议的工具服务节点,它允许两个不同模型通过同一接口调用C-Dance 2.5这类动态图形渲染引擎。这也解释了为何两款模型在这一轮旗鼓相当:当任务的核心执行(动画渲染)被委托给同一下游工具时,上游模型的职责退化为"理解需求→生成正确的工具调用参数",其创造性输出能力的差异会被大幅均质化。换言之,在工具链高度标准化的场景中,模型之间比拼的不再是"谁能写出更好的代码",而是"谁能更准确地理解用户意图并正确调用工具"——而这恰恰是当前顶级模型间差距最小的能力维度之一。它们都能熟练调用外部工具,输出扎实的动态图形,也说明在依赖外部工具链的任务中,模型间的差距会被显著缩小。
实测四:3D地球仪旅游仪表盘
最后一项测试更偏创意,要求制作一个功能性的3D地球仪表盘网页应用来销售旅游产品。这类任务需要模型同时具备三维渲染知识(如Three.js或WebGL)、UI/UX设计感和业务逻辑组织能力,是对综合能力的一次高阶考验。
GPT-6的作品名为"Orbit":输入出发地和目的地后,地球仪上会标出位置,底部显示航程信息(如SFO到CPT中转22小时、往返每人864美元),点击"探索"还能查看目的地图片与玩法,甚至内置了一个"Chase the Sun"功能,实时在地球仪上显示当前的黄金时刻位置。整体设计简洁专业,信息层次清晰——用户首先看到地理关系,然后获取行程细节,最后深入目的地内容,这种渐进式信息架构体现了较强的产品思维。
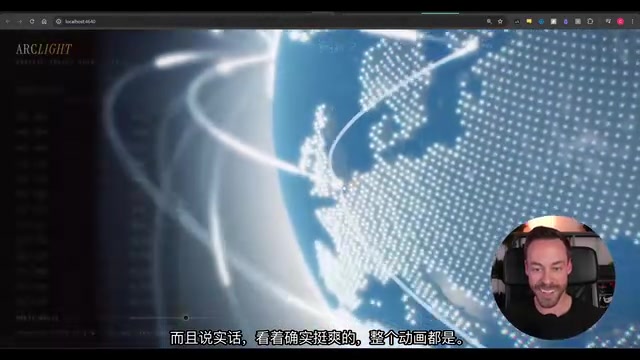
Fable 5.1的作品"Arclight"则一上来就追求视觉冲击力:文字沿路线跟随、实时票价涨幅、太阳时钟联动票价更新、点击城市有炫酷的飞入动画。视觉效果确实"挺爽",但背景过亮导致部分信息难以看清,明显是把视觉放在了功能性之前。这一现象在前端生成领域有其规律性:模型在缺乏明确功能优先级约束(即提示词中未指定"信息可读性优先于视觉效果")时,倾向于最大化视觉显著性(visual salience)——因为训练数据中获得正面反馈的作品往往是视觉上更抢眼的那些——而非可用性(usability)。这本质上是一个优化目标的偏差:模型在生成时隐式地优化"看起来厉害"而非"用起来好用"。
测试者认为,Fable 5.1的作品"如果能用Astra来调和一下就好了",需要更多轮提示才能达到可用状态。这一局仍是Astra胜出。
总结:Astra 3胜1平,但差距没那么大
四项测试的最终战绩是:Astra赢下三项,动态图形打平。结合基准数据的略微领先和更低的Token成本,GPT-6在这场对决中占据了上风。
但测试者也坦诚地给出了更平衡的视角:
- 这只是一次性尝试(single-shot attempt),无法完全代表真实工作流的体验——在实际开发中,用户会进行多轮迭代、提供详细反馈,模型的"可调教性"(steerability)可能比首次输出质量更重要;
- Fable 5.1依然是一款"非常扎实"的模型,"几乎没遇到过说它很烂的人"——Anthropic在指令遵循的精确性、长上下文保持和代码安全性方面仍有其独到优势;
- 内置图像生成能力对某些用户而言是加分项,但并非人人都需要。
除了模型能力,还有一个值得关注的"额度政策"分歧。大模型订阅服务的"额度"并非简单的Token数量上限,而是涉及多个维度的资源分配机制:速率限制(rate limit,即每分钟/每小时允许的最大请求数)、并发上限(同时进行的对话或任务数)、优先级队列(高峰期高价套餐用户是否优先获得计算资源)以及模型可用性(某些套餐才能访问最新旗舰模型)等。Anthropic的20倍套餐标称"20倍用量",但实际使用中每周消耗量仍只能达到标称值的50%左右——这是因为速率限制而非总量限制在起约束作用。更值得注意的是,过去一个月Anthropic的限制反而有所收紧,可能与Fable 5.1上线后激增的用户需求有关。相比之下,OpenAI基本每三天给一次额度重置,提供了更可预期的使用节奏,实际额度更宽松——对于有周期性密集任务(如每周一次的大规模代码重构或数据分析冲刺)的开发者而言,这一差异相当实质。
或许更明智的选择是:同时订阅OpenAI的5X和Anthropic的5X套餐,月底同样支付200美元,但你拥有了在日常工作中真正测试两者的自由。
这一策略的潜台词是:在当前模型能力高度趋同的阶段,"独占押注"不如"多元对冲"。两款模型在不同任务类型上各有所长——GPT-6在一次性生成质量和成本效率上占优,Fable 5.1在长对话保持和细粒度指令遵循上可能更稳——同时持有两者的订阅,允许开发者根据具体任务特性灵活切换,实现真正的"最优工具匹配"。
最终,这场对决的真正启示或许不是"谁赢了",而是——两款模型都已经足够优秀。与其纠结基准数字,不如亲自上手,用你自己的项目来检验它们的真实表现。
核心要点
- 基准测试:GPT-6 Astra在纸面数据上全面领先,但需警惕基准污染和分布偏移问题,百分比差距不等于实际能力差距
- 成本效率:在精度接近的前提下,Astra的Token成本仅为Fable 5.1的约53%,大规模部署时差异可达数百万美元量级
- 一次性生成:Codex的智能体管线在复杂项目(如堡垒之夜复刻)中表现更稳定,45分钟黑箱处理优于1.5小时对话迭代
- 默认审美:GPT-6的前端生成输出更精致,多模态融合(自动配图)是显著加分项,对普通用户尤为重要
- 工具链均质化:当任务依赖外部标准化工具(如MCP协议)时,模型间差距被大幅缩小
- 额度政策:OpenAI的额度重置更规律、实际可用量更充裕;双订阅策略(各5X共200美元/月)可能是当前最优解
- 最终建议:两款模型都已足够优秀,与其纠结数字不如用自己的真实项目来检验
相关推荐

Databricks Genie:让营销团队数据使用量翻三倍的AI分析助手
Databricks 推出的 AI 分析助手 Genie 让营销团队数据使用量提升 3 倍。本文解析这款对话式自然语言查询工具如何降低数据访问门槛,以及对企业 AI 落地的启示。

《俄勒冈之旅》如何成为一代人的文化符号
《俄勒冈之旅》从一款教育软件成长为跨越几代人的文化符号。本文回顾这款游戏如何通过学校课堂渗透、"死于痢疾"等经典记忆点,成为世代玩家的共同回忆。

健康福利平台Thatch估值破10亿美元,医保成本飙升成催化剂
健康福利平台Thatch完成1.08亿美元融资,估值突破10亿美元,投资方包括a16z、Index Ventures、General Catalyst等顶级机构。在美国医疗成本飙升背景下,健康福利科技赛道价值凸显。