GPT-6 Astra语音模式实测:语音驱动的个人自动化操作系统

当语音成为生产力的入口
在一段B站实操演示中,一位AI自动化创作者展示了他与GPT-6 Astra语音模式的完整协作流程。整场演示围绕一个核心命题展开:能否仅凭语音,构建并运营一整套个人操作系统?
答案似乎是肯定的。创作者全程没有敲一行代码,也没有手动操作复杂界面,而是通过与Astra的对话,完成了视频转文章发布、课程落地页搭建、日历管理、会议看板集成等一系列真实业务任务。这不是简单的语音助手交互,而是一次接近"数字分身"级别的自动化实验。
这一尝试所触及的,是"个人操作系统"(Personal OS)这一在生产力工具社区中讨论已久的概念。其思想脉络可以追溯得更远——1945年Vannevar Bush在《As We May Think》中提出的Memex(记忆扩展器),是人类最早对"外部化认知系统"的系统性构想:一台假想的机械设备,能够存储个人阅读过的所有书籍、记录和通信,并通过关联索引快速检索。这一愿景经过半个多世纪的技术演进,先后催生了个人Wiki、Evernote、Notion等工具。Tiago Forte在《Building a Second Brain》中将其系统化为个人知识管理(PKM)方法论,提出了CODE框架(Capture捕获、Organize组织、Distill提炼、Express表达),将信息流的管理从被动存储转向主动创造。然而,传统PKM工具链的核心痛点始终未被解决:各工具之间的数据孤岛导致上下文切换成本极高,用户需要手动在Notion、日历、邮件、项目管理工具之间搬运信息。据RescueTime的研究数据,知识工作者平均每天在不同应用之间切换超过300次,每次切换带来的认知恢复成本约为23分钟。Astra这类AI编排层的出现,试图通过统一的自然语言接口让AI承担跨工具的信息路由与状态同步,从根本上消除这一摩擦——它不是又一个新工具,而是工具之间的"胶水层"。
你可能没注意到,整个过程既能在电脑上完成,也能在手机上随时接管——创作者反复强调设备间同步的顺畅度,意味着这套自动化能力真正做到了"随时随地可用"。
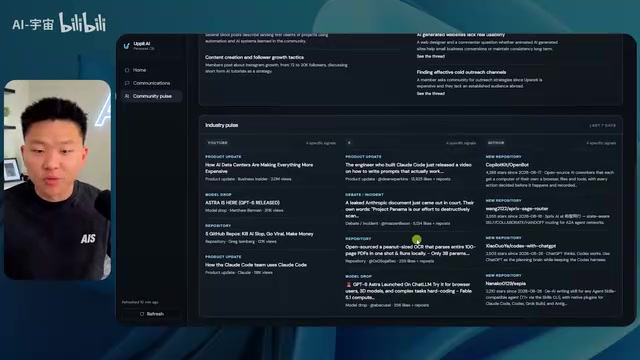
Astra语音模式的技术内核:Codex驱动的多线程协作
语音只是交互层,Codex才是执行引擎
演示中一个关键的技术细节是:Astra语音模式的后端调用了Codex。当你用语音下达指令时,系统实际上是在调度AI操作系统、执行浏览器操作、运行多个任务线程。
Codex是OpenAI开发的专门针对代码理解与生成的AI模型系列。其起源可以追溯到2021年,最初是GPT-3在大规模代码语料库上的微调版本,核心能力在于将自然语言指令转化为可执行的程序逻辑。早期Codex是GitHub Copilot的底层引擎,主要用于IDE内的代码补全和函数生成。随着版本迭代,其能力发生了质的跃迁:从被动的"代码补全器"进化为主动的"任务执行器"。现代Codex不仅能生成代码片段,还能理解多步骤任务的依赖关系,自主规划执行顺序,并在执行过程中根据中间结果调整后续策略——这正是AI Agent(智能体)领域所追求的"规划-执行-反馈"循环。在Astra的架构中,Codex承担的是"执行层"角色——语音输入经过语义解析后,由Codex负责将意图拆解为具体的操作序列:调用浏览器API、触发第三方服务Webhook、管理文件系统等。这种"语音→意图→执行"的三层架构,是当前AI自动化系统的主流范式,在学术文献中通常被称为"感知-规划-行动"(Perceive-Plan-Act)框架,其中语音层负责降低交互门槛,意图层负责语义理解与任务分解,执行层则是实际产生副作用(side effects)的部分——副作用在这里指的是对外部世界状态的实际改变,比如发布一篇文章、修改一个日历事件或发送一封邮件。
创作者演示了一个典型场景:他让Astra把"昨天在YouTube发布的视频"转换成X(Twitter)文章并发布。这一条语音指令背后,系统自动完成了以下动作:
- 下载原视频并转录内容
- 为X平台重新组织成文章格式
- 从视频中截取11张截图
- 分析每张图片内容,并将其插入文章的正确位置
- 自动裁剪非全屏截图、匹配5:2的封面比例
- 自动模糊处理画面中出现的API密钥和个人邮箱
更值得关注的是多线程协调能力。Codex的多线程协调意味着它可以同时维持多个任务的上下文状态,这与操作系统的进程调度机制有着深层的结构类比。在传统操作系统中,进程调度器需要解决三个核心问题:上下文切换(保存和恢复每个进程的寄存器状态)、资源竞争(多个进程争夺CPU、内存等有限资源时的仲裁)、以及优先级管理(决定哪个任务先执行)。AI Agent的多线程执行面临着等价的挑战:每个任务需要独立的上下文窗口(类比进程的地址空间),多个任务可能同时需要访问同一个外部服务的API(类比资源竞争),而用户的即时语音请求通常需要打断正在进行的后台任务(类比中断处理)。创作者同时开启了文章任务、封面任务、落地页开发任务,Astra能够识别这些不同上下文的对话,并确保它们都在指定的"Herc 2项目"中运行,以获取正确的技能包和上下文信息。这种"项目级隔离+共享知识库"的架构,本质上是在AI系统中实现了类似容器化(Containerization)的资源隔离与共享机制。
上下文理解是AI自动化真正有用的前提
创作者反复强调一个观点:能力之外,还需要正确的上下文和连接才能真正发挥作用。当他用语音和Astra交流时,系统"像是真的了解我和我的业务"。
这一点在细节里体现得尤为明显:当他要求制作X文章封面时,没有指定具体图片,Astra自主去YouTube上查找了那张"翘着脚、带OpenAI标志剪辑视频"的照片,并主动将其调整为适配X的比例。系统需要从多个数据源提取信息,理解创作者的"整个大脑"——这种跨源的上下文整合能力,正是AI编排层与传统单点工具最本质的区别。在技术层面,这要求系统具备"长期记忆"(Long-term Memory)能力:不仅记住当前对话的内容,还能检索用户的历史行为模式、偏好设定和业务上下文。当前主流的实现方案包括向量数据库索引(将用户历史数据嵌入为语义向量,在需要时进行相似性检索)和结构化知识图谱(以实体-关系的形式显式存储用户的业务知识)。Astra选择的"项目级上下文"方案——将所有相关信息归类到特定项目中——是一种在检索效率与上下文精度之间取得平衡的实用策略。
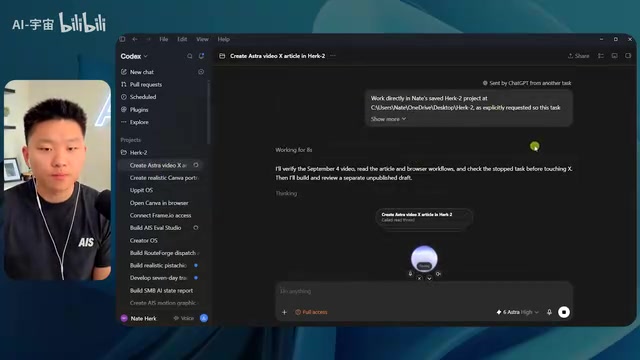
从单点工具到语音驱动的个人操作系统
打通真实业务系统的深度集成
这次演示最有说服力的地方,在于它连接的是真实的生产环境,而非演示沙盒。创作者展示了系统与以下工具的深度集成:
- 真实日历:语音添加事件后,能立即出现在他的实际日历中
- Slack、ClickUp、邮件:可直接在统一界面回复团队沟通、开启新讨论
- Fireflies会议记录:新增的会议板块能抓取会议日期、一句话总结和待办任务
- School社区:读取课程结构并自动生成品牌落地页
Fireflies是Meeting Intelligence(会议智能)赛道的代表性产品,该赛道在2023-2025年间经历了快速增长,与Otter.ai、Grain、Fathom等产品共同构成了一个活跃的细分市场。其技术栈通常包含三层:语音转文字(ASR,Automatic Speech Recognition,当前主流引擎如OpenAI Whisper的词错率已降至5%以下)、说话人分离(Speaker Diarization,识别"谁在什么时候说了什么",这是一个在远场多人对话场景中仍具挑战性的技术问题),以及基于大语言模型的摘要与动作项提取(将30分钟的会议压缩为结构化的决策点、待办事项和负责人分配)。Fireflies与Astra的集成体现了一种正在成形的架构模式——"垂直AI工具+水平编排层":各垂直领域的AI工具通过标准化API暴露结构化数据,而Astra这样的"编排层"AI则负责跨工具的数据聚合与任务路由。这种模式类似于Unix哲学中"每个程序只做好一件事,通过管道组合"的思想,各工具可独立演进,编排层只需维护接口协议。
这套被称为"Upnote OS"(音译,可能为UpNode OS)的系统,本质上是把创作者散落在各处的工作流,收敛到一个语音可控的中枢里。从技术架构角度看,这类系统面临三个核心挑战:
权限管理——系统需要代理用户访问多个OAuth 2.0授权的第三方服务。OAuth 2.0是互联网应用间授权的事实标准协议,它允许用户授权第三方应用访问自己在某个服务上的数据,而无需向第三方暴露密码。但当一个AI编排层同时持有用户在十余个服务上的访问令牌时,安全攻击面急剧扩大——一旦编排层被攻破,攻击者可能同时获得用户日历、邮件、项目管理等多个系统的访问权。
上下文窗口的有效管理——不同任务的上下文如何隔离又如何共享。大语言模型的上下文窗口虽然在持续扩大(从GPT-3的4K Token到当前模型的128K甚至更多),但仍然是有限的稀缺资源,需要精心管理哪些信息被加载到当前上下文中。
错误恢复——当某个子任务失败时如何优雅降级而非整链崩溃。在分布式系统设计中,这被称为"故障隔离"(Fault Isolation),Netflix的Hystrix断路器模式是这一理念的经典实现:当某个下游服务故障时,快速失败并返回降级结果,而非让整个调用链阻塞。
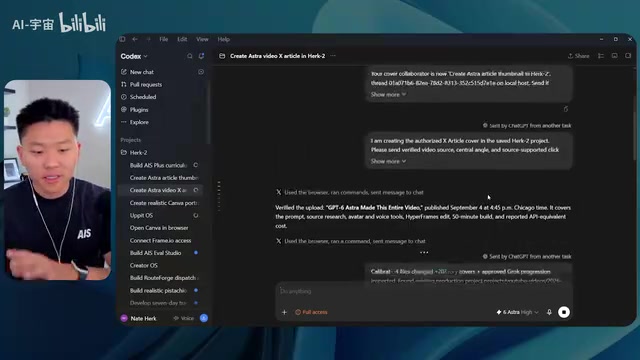
浏览器操作能力的显著飞跃
创作者称GPT-6 Astra的浏览器能力"是我见过最强的"。一个例子是:他给系统两张图片,让Astra在Canva里完成绘制,尽管耗时较长,但考虑到渲染和浏览器操作的复杂度,成果令人印象深刻。值得一提的是,AI操控浏览器这一能力近年来经历了显著的技术演进。早期的方案基于DOM(Document Object Model,文档对象模型)解析——AI通过分析网页的HTML结构来理解界面元素,但这种方法在面对动态渲染的单页应用(SPA)和Canvas绑定的富交互界面时频频失效。当前更先进的方案采用视觉理解路径:AI直接"看"屏幕截图,通过计算机视觉识别按钮、输入框、下拉菜单等UI元素的位置和功能,然后模拟鼠标点击和键盘输入——这正是Anthropic的Computer Use、OpenAI的Operator等产品所采用的技术路线。Canva这类重度依赖Canvas渲染的设计工具,对传统DOM解析方案几乎免疫,因此Astra能在其中完成操作,暗示其具备较强的视觉理解与屏幕交互能力。
另一个更具冲击力的案例来自AIS Live活动:创作者将超过150GB的视频素材链接发给Codex,要求制作一个60秒的活动宣传片,仅用两次请求就完成了。值得注意的是,当前多模态大模型并不直接"读取"视频的全部原始字节——150GB原始素材会先经过视频理解管道处理:关键帧提取(通常每秒1-3帧,将连续的视频流离散化为代表性图像)、场景分割(基于视觉相似度和音频特征识别场景边界,例如检测到镜头切换、BGM变化或说话人切换时标记为新场景)、音频转录(将对话内容转为时间戳对齐的文本),最终转化为模型可处理的多模态Token序列。150GB的原始视频经过这一管道后,可能压缩为数百万个Token的结构化表示。真正考验模型能力的是:在海量素材中识别符合叙事逻辑的片段,理解不同场景的情感权重(开场需要高能量镜头、结尾需要号召性画面),并生成可执行的剪辑指令(精确到时间码的切割点、转场效果选择、配乐节奏匹配)。两次请求完成任务若属实,意味着模型具备较强的一次性任务规划能力,但也可能反映了任务被预先结构化的程度——例如素材可能已经被标签化或分类整理——这正是独立验证难以评估的部分。
生成成果的质量:不只是能用,还有设计风格
当Astra完成课程落地页后,创作者打开全屏展示——页面用Scrollcraft做了动态分层设计,背景中的山脉以不同速度移动,形成视差滚动效果。
视差滚动(Parallax Scrolling)是一种源自1980年代横版卷轴游戏的视觉技术,最早的经典实现可见于《Moon Patrol》(1982年)和《Super Mario Bros》系列。其原理是模拟人眼的运动视差(Motion Parallax)现象:距离观察者越近的物体相对运动越快,远处物体运动越慢,大脑据此推断距离关系,产生立体空间感。在现代Web实现中,通常通过CSS的transform: translate3d()属性触发GPU加速渲染,或使用JavaScript的Intersection Observer API监听元素进入视口的时机,动态计算各层的位移比例。Scrollcraft等工具将这一效果封装为低代码组件,开发者只需配置各层的速度系数即可。然而,值得关注的不仅是视觉效果本身,更在于AI系统能够从工作空间扫描中提取品牌视觉规范(色调的HSL值、字体族的层级关系、构图的黄金比例运用),并将其自动映射到Scrollcraft的模板参数上——这体现的是多模态理解能力:系统同时处理了截图中的视觉信息(通过计算机视觉提取主色调和布局结构)、CSS样式文件中的设计Token(如--brand-primary: #1a73e8这样的变量定义),以及品牌资产库中的图片素材(山景背景图的分辨率、裁剪比例和色彩空间)。
更关键的是风格一致性:新页面自动保留了AI Automation Society网站的标志性视觉语言,包括蓝色色调、山景背景,甚至在认证页面也维持了统一设计。品牌一致性在专业设计领域通常依赖"设计系统"(Design System)来保障——一套包含色彩规范、排版规则、组件库和使用准则的完整文档。AI系统之所以能做到这一点,是因为它"扫描了工作空间,找到所需的一切"——本质上是以自动化方式执行了设计系统中的视觉审计(Visual Audit)流程。
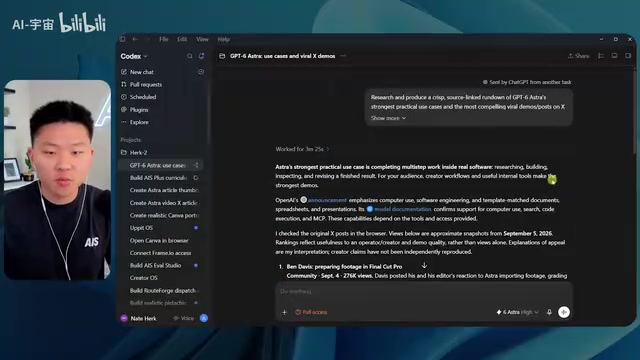
创作者验证后确认,这些确实是社区中真实提供的课程内容,而非占位符——Astra查看了真实课程数据并重建了完整的课程体系。
理性看待:演示效果与日常使用的差距
这段演示无疑令人振奋,但也需要保持冷静判断。首先,本文所依据的是单一来源的B站视频演示,缺乏第三方独立验证,其中部分能力(如"仅两次请求生成宣传片")的实际稳定性和成功率难以评估。AI演示视频中存在一种被称为"幸存者偏差式展示"的常见现象:只展示成功案例,而省略了反复调试、失败重试的过程。在专业评测中,通常需要在多个不同任务上重复实验数十次,统计成功率和平均耗时,才能给出可靠的能力评估。
其次,创作者本身是AI自动化领域的内容创作者与课程销售者,演示带有明显的产品推广属性——视频结尾即引导观众前往其课程学习"如何使用Astra和Scrollcraft"。这意味着展示的是最理想状态下的效果,日常使用中的失败案例和调试成本并未呈现。
还有一个值得关注的风险维度往往被忽略:当AI系统深度整合用户个人数据(日历、邮件、会议记录、课程数据)之后,平台的持续性本身就成为了风险变量。2025年3月,基因检测公司23andMe申请Chapter 11破产保护一事是一个警示。Chapter 11是美国《破产法》第11章规定的重组程序,允许企业在法院监督下继续运营并重组债务,与Chapter 7(清算破产,直接变卖资产偿债)不同,企业不会立即停止运营。然而,23andMe案例的核心争议在于:超过1500万用户的基因数据——这是最不可撤销的个人信息——在破产资产中的法律地位究竟是什么?它是可以被出售给收购方的"资产",还是应当受到特殊保护的个人隐私?加州总检察长曾因此发出警告,建议用户主动删除数据。对于构建在单一AI平台上的"个人操作系统"而言,这一问题同样适用:当服务商陷入经营危机,用户精心构建的自动化工作流将何去何从?更深层的问题是数据可携带性(Data Portability):用户在一个AI编排平台上积累的所有上下文、偏好设定、自动化规则,能否导出并迁移到另一个平台?目前的现实是,绝大多数AI平台并未提供标准化的数据导出格式,这构成了实质性的平台锁定(Vendor Lock-in)。
此外,"GPT-6 Astra"这一命名的官方性也值得留意,需以OpenAI的正式发布信息为准。
结语:AI自动化正在从单点任务走向系统级协作
抛开推广色彩,这次演示确实指向了一个有价值的方向:AI自动化正在从"单点任务"走向"系统级协作"。语音作为交互入口、Codex作为执行引擎、多线程并行处理、深度业务系统集成——这四个要素结合在一起,勾勒出了一种全新的工作范式。这一趋势与软件架构的历史演进形成了有趣的呼应:从单体应用(Monolith)到微服务(Microservices)再到Serverless,软件系统一直在向更细粒度、更松耦合的方向演化。AI Agent的多线程协作模式,可以看作是这一趋势在用户端的映射——每个子任务是一个独立的"微服务",而AI编排层是统一的API Gateway。
创作者引用了一句耐人寻味的话:"不是成本证明价格的合理性,而是价格证明了成本的合理性。"当AI能够替你完成如此多的复杂协作时,真正稀缺的或许不再是执行能力,而是知道"该让它做什么"的判断力与上下文构建能力。这一洞察与经济学中的"杰文斯悖论"(Jevons Paradox)形成了某种共振——当执行成本大幅降低时,需求反而会爆发式增长,最终对"如何定义正确的任务"这一元能力的需求不是减少,而是急剧增加。
核心要点
核心要点
相关推荐

SimpliSafe新款可视门铃:AI+真人保安主动盯防你的家门
SimpliSafe推出售价199.99美元的Video Doorbell Series 2可视门铃,搭配Active Guard主动安防服务,结合AI分析与真人监控坐席,实现家门口的主动威胁侦测与干预。本文解析其技术分工、订阅模式与隐私问题。
富士 Instax Pal 2 迷你相机:补齐屏幕短板的升级之作
富士发布 Instax Pal 2 迷你数码相机,相比初代新增屏幕与取景器,采用微缩化相机造型,补齐了初代盲拍的核心短板,成为一款更实用的便携即时成像设备。
Linux from Scratch:从零手工构建你的Linux系统
Linux from Scratch(LFS)是一个教你从源代码手工构建 Linux 系统的开源项目。本文介绍 LFS 的核心价值、BLFS/ALFS 项目生态及适用人群,帮助你理解 Linux 底层机制。