GPT-6 Pro实测:科研绘图矢量化与学术PPT批量生成技巧
GPT-6 Pro可将图片还原为真正可编辑的矢量SVG,并一步生成可编辑学术PPT,两个指令技巧可显著提升输出质量。
本文记录了一位B站UP主对GPT-6 Pro在科研绘图场景下的实测体验,核心发现是:GPT-6 Pro能将普通图片重建为结构化的可编辑SVG矢量文件,导入Adobe Illustrator后文字与图形元素均可独立编辑,解决了AI生成图像无法用于学术投稿的长期痛点。与GPT-5.6相比,新版本在细节保真度和结构还原上有明显代际提升。文章总结了两个关键技巧:一是指令须明确要求"还原成原图格式的SVG"以避免生成不可编辑的路径描摹文件;二是优先使用Chat模式而非Codex(Work)模式,前者在局部细节保真上更优。此外,GPT-6 Pro还可一步生成可编辑学术PPT,并能将图像型PPT批量转为可编辑格式,效率较此前的"三波法"有所提升,但视觉美观度仍逊于专用图像模型。
GPT-6 Pro带来的科研绘图新体验
长期以来,AI生成图片有一个绕不开的痛点:输出的图像无法编辑,也难以直接用于学术投稿。这次B站UP主分享的GPT-6 Pro(Astra系列)实测经验,正是围绕这一痛点展开——它能够把普通图片还原成真正可编辑的矢量图(SVG),而不是简单的位图描摹。
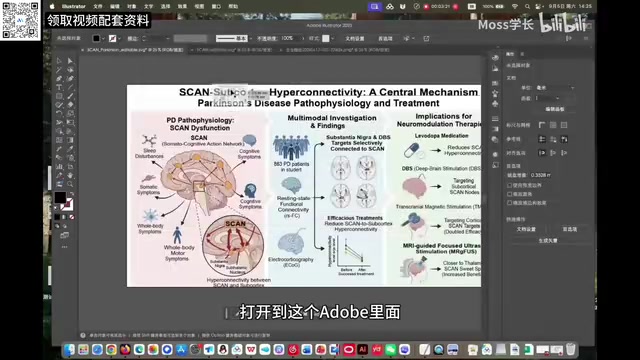
据这位已率先升级Pro账号的创作者测试,GPT-6 Pro在还原矢量图时,SVG源文件里的文本和图形元素都能保持高清无损。将文件导入Adobe Illustrator后,所有文字均可直接编辑,图形元素也能取消编组、单独调整。以一张脑组织解剖图为例,大脑各部分与其他人体组织都可以拆分选中、独立处理。
关键在于,这些元素并非从素材库拼凑而来,而是模型重新绘制的矢量路径。因此无论怎样放大,图形始终保持清晰锐利,这对需要高分辨率插图的科研论文来说尤为实用。
与GPT-5.6的效果对比
为了验证升级带来的差异,UP主用同样的指令在GPT-5.6 Thinking模型上做了对比测试。结果显示,GPT-5.6在还原大块结构和细节处理上明显逊色于GPT-6 Pro——尤其是图像的局部细节,前者的保真度不足,边缘和微小结构容易出现失真。
这一代际差距说明,GPT-6在图像理解和矢量重建能力上确实完成了一次实质性升级,而非参数上的小幅优化。对于经常需要处理示意图、机制图的科研人员,这种可编辑性和保真度的提升具有直接的生产力价值。
两个提升矢量还原质量的实用技巧
实测中总结出两个关键技巧,直接影响最终输出质量。
技巧一:明确要求“还原成原图格式的SVG”
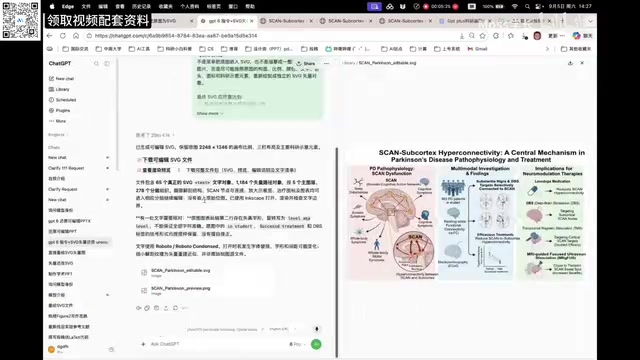
如果只是笼统地让模型“还原成SVG文件”,它大概率会生成路径描摹式的SVG——也就是照着图像逐格扫描重建的文件。这类文件的弊端很明显:文字放大后模糊、字体本质上仍是图像格式无法编辑,细节还会被丢失或简化。
正确做法是使用更精确的指令,要求它“还原成原图格式的SVG文件”,这样生成的矢量图文字清晰可编辑、细节保留更完整,效果会好很多。
技巧二:优先使用Chat模式而非Work模式
GPT-6 Pro提供Chat(聊天页面)和Work(Codex)两种模式。UP主的经验是:Chat模式在矢量还原上更聪明。同样一条指令,用Codex(Work模式)还原时,导入Adobe后虽然文字仍可编辑,但局部细节——比如脑干组织、细胞结构——会出现轻微失真和变形;而用Chat模式生成的结果失真明显更少。
这个差异目前原因不明,但从实测结果看,做精细科研绘图时建议以网页端Chat模式为主。
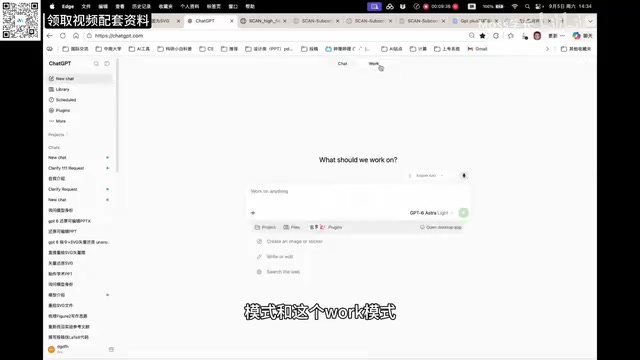
Codex(即文中的Work模式)是OpenAI专为代码生成与执行任务设计的工作流模式,底层架构针对编程类任务做了优化,擅长多步骤自动化操作和文件批处理。Chat模式则是面向开放式对话与创意生成的标准交互界面,模型在此模式下拥有更完整的上下文推理能力,对图像内容的语义理解也更为全面。
两种模式本质上调用的是同一基础模型,但任务分发路径和内部提示策略存在差异。对于矢量绘图还原这类需要同时理解视觉语义、文字内容和空间结构的复杂任务,Chat模式更完整的推理链路似乎更具优势,而Codex模式可能因偏向代码执行逻辑而在图形细节的处理上产生轻微损耗。目前官方尚未对此差异给出正式解释,但这一实测发现对日常使用具有直接的参考价值。
一步生成可编辑学术PPT
除了矢量绘图,GPT-6 Pro在学术汇报PPT制作上也有明显进步。此前需要借助“三波法”配合img模型分步生成,如今GPT-6 Pro可以一步到位直接生成学术PPT,整体水准已经可用。
不过UP主也坦言分歧所在:如果追求图像、表格、排版和视觉上的美观度,img模型生成的PPT依然更胜一筹。因此他个人仍习惯用三波法配合img模型先做出一套好看的PPT。
把图像型PPT转成可编辑格式
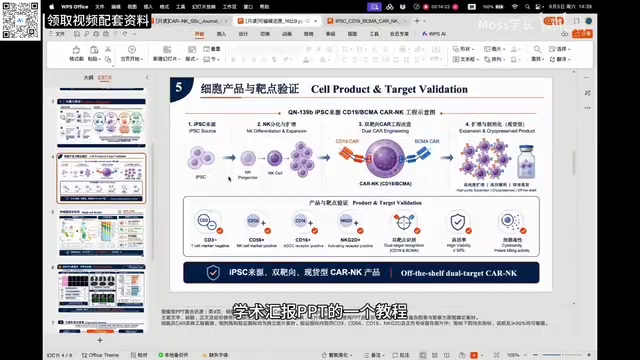
一个实用场景是:img模型生成的PPT本质是图像型,无法编辑。此时可以用GPT-6 Pro配合专用指令,把整份PPT一步还原成可编辑格式。实测这一过程大约耗时30分钟,完成后包括文字在内的所有内容都能自由修改。
值得一提的是,早期版本还需要一页一页地还原PPT,而GPT-6 Pro凭借更强的模型能力,已经可以整份批量处理,效率提升显著。
"三波法"是该UP主此前分享的一套多模型协作工作流:第一波用语言模型规划PPT结构与文案,第二波调用图像生成模型(img模型)渲染每张幻灯片的视觉效果,第三波再对排版和细节进行人工润色。这种方法的核心优势在于,图像生成模型对版式美观度和视觉风格的把控远优于通用对话模型,能产出更精致的幻灯片效果。其代价是流程繁琐、步骤割裂,且生成的PPT本质为图像集合,缺乏可编辑性。GPT-6 Pro的进步在于将"生成"与"可编辑性"整合到单一步骤,但视觉美观度暂时仍是其短板,因此两种方法目前各有适用场景而非简单的替代关系。
小结
从这次实测来看,GPT-6 Pro相比Plus版本在科研场景下的进化是实打实的:可编辑矢量图还原解决了AI绘图无法投稿的老问题,一步生成可编辑PPT则大幅降低了学术汇报的制作门槛。对科研工作者而言,掌握“原图格式SVG指令”和“Chat模式优先”这两个技巧,能明显提升产出质量。当然,在追求极致视觉呈现时,img模型加三波法仍有其不可替代的价值。
背景补充
SVG(Scalable Vector Graphics,可缩放矢量图形)是一种基于XML的开放标准格式,用数学路径描述图形而非像素点阵。与JPEG、PNG等位图格式不同,SVG图形可以任意缩放而不失真,且文件内部的文字、路径、形状等元素均可被程序单独读取和修改。这正是它在学术出版中备受青睐的原因——大多数期刊要求插图以矢量格式提交,以确保印刷时的清晰度。
所谓"路径描摹式SVG",是AI处理位图图像时的一种偷懒做法:它并不理解图像内容,而是沿着像素边缘自动生成大量密集的贝塞尔曲线路径,将图片"套"进SVG容器。这类文件看起来是SVG,实则文件体积庞大、文字元素无法编辑、细节容易失真,与真正意义上的结构化矢量图相差甚远。要求模型"还原成原图格式",本质上是引导它重新理解图像的语义结构,将文字识别为可编辑的文本节点,将图形还原为独立的路径或形状元素,从而生成具备真正可编辑性的SVG文件。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。
泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。
74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。