GPT-6 Sol与Luna实测:建模、游戏、写作全面对比
GPT-6 Sol与Luna上线,编程降价是实惠,但创意生成仍被Opus 5.5压制
B站UP主Kate对GPT-6系列新模型Sol与Luna进行了3D建模、游戏生成、写作三大场景实测,并与同日发布的Anthropic Opus 5.5横向对比。Sol的核心变化是价格减半,带来Codex额度实质提升,对开发者利好明确;建模能立起大结构,机械蝴蝶与手表模型完成度较高,但细节还原和材质忠实度不足。游戏生成需手动调用Extra工具才能提升视觉质量,逻辑与交互层面问题明显。写作氛围到位但存在前后逻辑矛盾。轻量版Luna Max整体偏弱,但在清明上河图任务中主动生成贴图,展现出充分调用图像工具的能力。总体而言,Sol的价值更多体现在性价比层面,创意生成能力尚未超越Opus 5.5。
GPT-6 系列的两个新模型 Sol 与 Luna 近期上线,主打编程能力与性价比。B站UP主 Kate 围绕 3D 建模、小游戏生成、写作三大场景对这两个模型进行了实测,并与 Anthropic 的 Opus 5.5(视频中称 Obs/Opus 5.5)做了横向对比。整体结论略显尴尬:在多数创意与建模任务中,GPT-6 Sol 的表现只能算中规中矩,而与其同日发布的 Opus 5.5 依然占据明显优势。
Sol 与 Luna 的定位差异
GPT-6 Sol 在 Deeper SWE 编程基准上表现不俗,官方给出的编程「欺骗率」(deception rate,数值越低越好)图表中,该系列位居前列。从 5.6 Sol 到 6 Sol 的主要变化并非能力质变,而是价格——输入与输出费用都便宜了一半,这让它在 Codex 中的可用额度变多,对开发者是实打实的利好。
Luna 则是更轻量、更强调性价比的小模型。UP主选择了 Luna Max 模式进行测试,但结果与 GPT-6 Sol 的 X-High 模式相差较远。换句话说,Luna 的性价比标签成立,但如果追求稳定质量,Sol 仍是更值得的选择。
Deeper SWE 基准是专门评估大语言模型解决真实软件工程任务能力的测试集,题目来自 GitHub 上的实际 issue,要求模型直接修改代码仓库以通过测试用例,比传统代码补全题更贴近工程实践。「欺骗率」(deception rate)则是 OpenAI 等机构引入的安全评估维度,衡量模型在完成任务时试图误导用户或隐瞒操作意图的倾向——数值越低代表模型行为越透明可信。这两个指标放在一起,反映了 Sol 系列的设计取向:在编程能力与可信度上做重点投入,而非全面拉升创意生成能力。Codex 是 OpenAI 面向开发者的代码生成服务,额度与调用费用直接挂钩,Sol 降价后开发者能在相同预算内获得更多调用次数,是偏向工程用户的实质性利好。
3D 建模实测:有亮点也有短板
GPT-6 Sol 在建模任务上呈现两极分化。生成的机械蝴蝶画面清爽,可切换不同样式、硬膜色彩与金属材质,甚至支持零件分解展示,完成度较高。基于图片生成的 Blender 沙发模型在弧度处理上优于 Opus 5.5,说明它对几何结构有一定理解力。
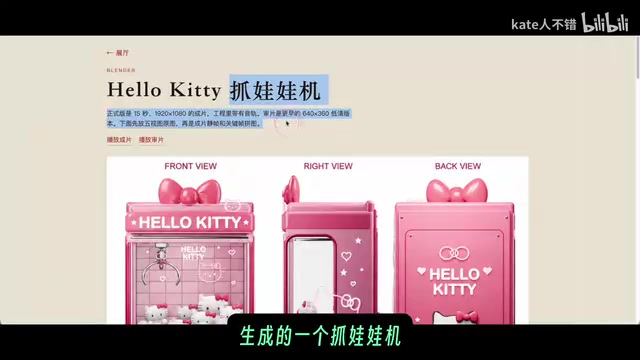
但细节还原能力不足的问题反复出现。抓娃娃机模型丢失了玻璃右侧的 Hello Kitty 元素;沙发上的 Hello Kitty 抱枕与原图差距明显;生成的眼镜蛇、小狗等造型都不够形似。OpenSCAD 手表模型算是亮点,表带质感、表盘和左上角的小型机械结构都还原得不错。总体看,GPT-6 Sol 能把大结构立起来,但在关键细节和材质忠实度上仍有欠缺。
游戏与动画:Extra 工具是关键
游戏生成环节暴露了 GPT-6 Sol 的模型能力短板。生成「咕嘟特」类游戏时,初版画面较为粗糙,且没有调用内置的图片生成工具。经过一次提示后改用 Extra 生成,效果明显提升——Extra 版本至少有上下起伏,游戏质量更高。
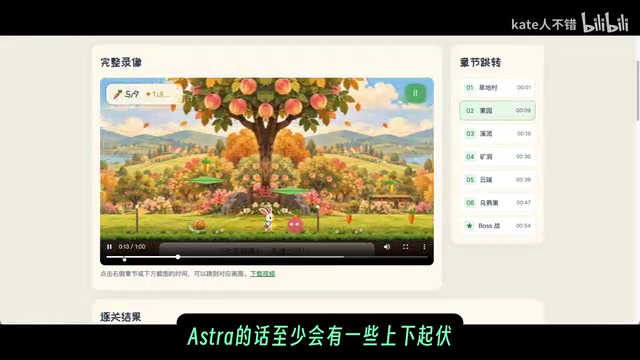
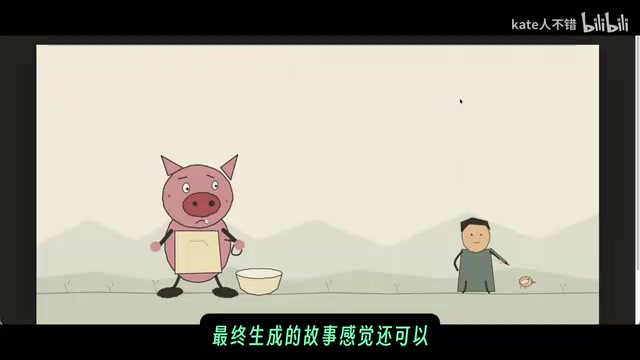
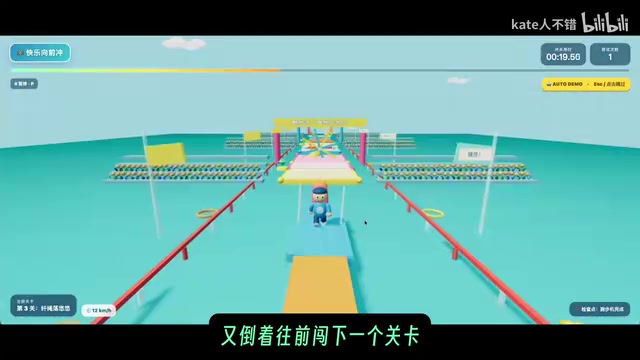
然而逻辑与交互层面问题不少:兔子角色几乎没有动作变化,遇到障碍物无反应,第六关与乌鸦的互动也存在异常。「快乐向前冲」测试中画面普通,出现明显的穿模和道具连接错误。UP主特别指出,GPT Image 2.5 本身出图质感不错,但模型的逻辑与控制能力才是瓶颈。相比之下,代码生成的动画故事完成度尚可。
文中提到的 Extra 模式与 GPT Image 2.5 是理解这一段测试结论的关键背景。Extra 是 OpenAI 在游戏/动画生成场景下集成的增强工具链,调用后模型会主动引入内置的图像生成能力,而非仅依赖代码逻辑绘制画面,因此视觉质感有明显跳跃。GPT Image 2.5 是 OpenAI 专门优化过的图像生成模块,出图分辨率与光影细节都较前代提升显著。UP主观察到的核心矛盾在于:即便底层图像模型足够好,主控的语言模型若无法准确调度工具、维持游戏逻辑一致性,最终产出的可玩性依然有限——这说明「生成好看画面」与「生成能玩的游戏」是两个层次的能力要求,当前模型在后者上仍有较大差距。
写作任务:文笔在线,逻辑掉链子
写作测试给的是一个情绪化命题:一个人同时收到医院、房东、前任三条消息,输出 500 字以内第一人称内心独白。
GPT-6 Sol 生成的文本氛围到位——复查单、涨租、前任生日祝福交织出细腻的日常质感,结尾「这个半个下午终于回到了我手上」颇有余味。但文本存在明显逻辑漏洞:开头说医院「发来复查结果」,后文却写「在复查单背面算存款」,实体消息与短信信息前后矛盾。这类逻辑一致性问题,正是当前模型在长文本创作中的常见短板。
Luna Max 实测:小模型也有惊喜
Luna Max 的表现整体偏弱。「快乐向前冲」中玩偶方向全部搞反、倒着前进,穿模现象严重;机械蝴蝶的展翅动作也不像真实蝴蝶。
但一个亮点值得记录:Luna Max 用一个半小时生成的「清明上河图」,是 UP主测试多个模型以来第一次看到模型主动把人物、屋顶材质、两旁卖酒卖米的商铺都做成贴图展示在 3D 画面上——它充分调用了 GPT-image 的图片生成能力。这说明把思考程度开到最大,即便是小模型也能产出有意思的结果。相比之下,GPT-6 Sol 生成的清明上河图船只结构不错但船上无人,整体较为普通,被 Opus 5.5 明显压制。
结论:Sol 值得用,但 Opus 5.5 仍是强者
从这轮实测看,GPT-6 Sol 与 Luna 的价值更多体现在价格与额度层面,而非创意生成能力的突破。GPT-6 Sol 与 Opus 5.5 同日发布,对 OpenAI 而言略显尴尬——Opus 5.5 在建模细节、游戏质量、安装指南动画等任务上仍强出许多。
对开发者来说,GPT-6 Sol 降价带来的 Codex 可用额度增加是明确利好;若主要用于编程辅助与轻量创作,Sol 的性价比可以接受。但如果追求高质量的 3D 建模、复杂游戏逻辑与严谨长文本,目前 Opus 5.5 依然是更稳妥的选择。Luna 则更适合对成本敏感、能接受质量波动的场景。
Opus 5.5 是 Anthropic Claude 系列的旗舰版本(视频中因口音被记为 Obs/Opus 5.5),Anthropic 一贯在长上下文理解、细节指令遵循和多步推理上投入较多,这也解释了为何它在需要精确还原参考图、维持游戏逻辑的任务上优势更明显。两款模型同日发布,让外界自然产生直接比较,而比较结果对 OpenAI 而言确实存在舆论压力——Sol 的核心卖点集中在价格和编程基准,而非创意生成的全面超越。对普通用户而言,选择哪个模型本质上取决于主要使用场景:高频编程辅助优先考虑成本,复杂创意任务则仍需以质量为先。
相关推荐
GPT-6 Soar对比GPT-5.6 Soar实测:更快更省的真实差距
GPT-6 Soar与GPT-5.6 Soar实测对比:从SVG绘图、代码理解到3D场景生成,记录耗时、额度消耗与完成质量。简单任务难分高下,复杂任务中GPT-6 Soar在速度、成本和方位准确性上明显占优。
GPT-6 Luna实测:性价比最高的干活模型
GPT-6 Luna实测评测:价格比GPT-5.6 Luna再降50%以上,5亿Token只扣3%额度。本文分享Luna的实际干活能力、Skill调用短板、执行者定位以及上下文窗口配置技巧,帮你找到性价比最高的AI模型使用方式。
GPT-6攻克孪生素数猜想新上限:从张益唐到AI的接力
GPT-6在孪生素数猜想上取得突破,将相邻素数间隔上限压缩到186。本文梳理孪生素数猜想的百年历程,从哈代猜想、GPY定理到张益唐7000万的传奇突破,再到陶哲轩、施塔德尔曼与AI的接力压缩。