GPT-6 提示词缓存升级:更高命中率与更低延迟成本
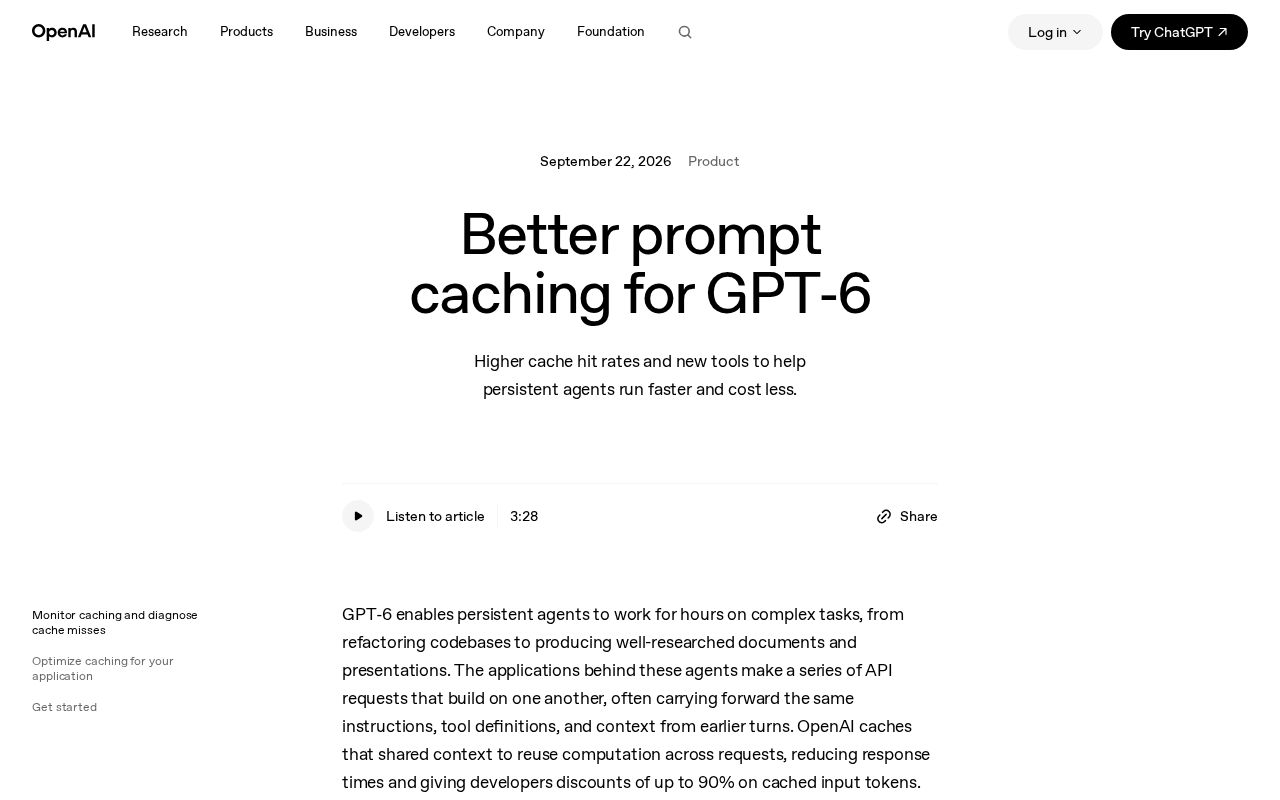
GPT-6 从命中率、显式断点与诊断信息三条主线对提示词缓存机制进行了系统性升级。
GPT-6 对提示词缓存机制进行了系统性升级,核心改进围绕三条主线展开:更高的缓存命中率可直接降低推理成本与首字延迟(TTFT),对 RAG、多轮对话和批量处理等长上下文场景尤为显著;新引入的显式断点机制让开发者能够主动标记缓存边界,将稳定前缀与动态内容隔离,避免后者破坏缓存命中;新增的诊断信息则将缓存使用情况透明化,使优化工作从「凭经验猜测」转变为「基于数据迭代」。三项改进共同构成一套更可控、可观测的缓存体系,建议开发者在接入 GPT-6 时重新审视 Prompt 结构,将稳定内容前置并结合诊断数据验证效果。
GPT-6 提示词缓存的核心改进
提示词缓存(Prompt Caching)一直是大模型应用降本增效的关键机制。当应用需要在多次请求中复用相同的上下文(如系统提示、长文档、few-shot 示例)时,缓存能避免重复计算,从而显著降低延迟与费用。GPT-6 在这一机制上带来了实质性升级,围绕更高的缓存命中率、更精细的控制能力,以及更透明的诊断信息展开。
据官方说明,此次更新的目标很明确:让开发者能够在保持响应质量的同时,进一步压缩推理成本与首字延迟(TTFT)。对于高并发、长上下文的生产环境应用而言,这类优化往往意味着可观的成本节省。
提示词缓存的底层原理是:模型在处理输入时,会将 token 序列逐层计算为 KV(Key-Value)向量,这一过程称为 prefill。缓存机制的本质是将已计算好的 KV 缓存(KV Cache)保存下来,当后续请求的前缀与已缓存内容完全匹配时,直接复用这部分结果,跳过重复的 prefill 计算。由于 prefill 阶段是影响首字延迟(TTFT)的主要因素,缓存命中越多,延迟越低,同时 API 计费中被缓存的 token 通常享有折扣价格,从而降低整体成本。值得注意的是,KV Cache 的匹配要求严格的前缀一致性——只要请求的开头部分与缓存记录完全吻合,后续新增内容才能正常接续缓存,这也正是「将稳定内容前置」这一实践原则的技术依据。
更高的缓存命中率意味着什么
缓存命中率(Cache Hit Rate)直接决定了缓存机制的实际收益。命中率越高,被复用的 token 就越多,需要重新计算的部分越少。GPT-6 通过优化底层的缓存匹配逻辑,提升了在真实使用场景下的命中概率。
在实践中,命中率的提升尤其利好以下几类应用:
- RAG(检索增强生成)应用:往往携带大段固定的检索上下文;
- 多轮对话系统:系统提示与历史对话高度重复;
- 批量处理任务:共享相同的指令模板。
命中率每提升一个百分点,在大规模调用下都会转化为实实在在的账单差异。这也是这次更新中开发者最直接能感知到的收益。
首字延迟(TTFT,Time To First Token)是衡量大模型响应体验的关键指标,指从发送请求到收到第一个生成 token 之间的时间间隔。在流式输出场景下,TTFT 直接影响用户感知到的「响应速度」。TTFT 主要由两部分构成:prefill 阶段(处理输入 token)和网络传输延迟。对于携带大量上下文的请求,prefill 往往占据 TTFT 的主导部分,而缓存命中率的提升能够大幅削减这一开销,使长上下文应用的实时交互体验更为流畅。
显式断点:把缓存控制权交给开发者
GPT-6 引入了**显式断点(Explicit Breakpoints)**机制,这是本次更新在控制粒度上的一大进步。过去,缓存的边界往往由系统自动判定,开发者难以干预哪些部分应当被缓存、缓存到何处结束。
显式断点允许开发者主动标记缓存的分界位置。这带来两方面价值:一是可以确保稳定不变的前缀(如系统提示、工具定义)被完整缓存;二是能够避免频繁变化的内容意外破坏缓存前缀,导致命中失效。
对于结构化程度较高的 Prompt,合理设置断点可以最大化复用比例。这本质上是把缓存策略从「黑盒自动」转向「可编程可控」,让高级用户能针对自身工作负载做精细调优。
理解显式断点的价值,需要先了解缓存失效的常见原因。由于 KV Cache 依赖严格的前缀匹配,一旦 Prompt 前半段出现任何细微变动(例如在系统提示中插入了动态时间戳、用户姓名或实时检索结果),整个缓存前缀就会失效,后续所有内容都需要重新计算。显式断点的作用,是让开发者明确声明「到此为止的内容是稳定前缀,应当被缓存」,从而将可变部分隔离在断点之后,使稳定部分不受动态内容污染。这与数据库查询优化中「固定参数绑定」的思路异曲同工:通过结构上的显式声明,让系统能够准确判断哪些计算结果可以安全复用。
新增诊断能力:让缓存不再是黑盒
缓存优化长期存在一个痛点——开发者很难知道自己的请求究竟命中了多少缓存、哪一部分没有命中。GPT-6 增加了新的诊断信息(Diagnostics),用于回传缓存的实际使用情况。
有了这些诊断数据,开发者可以:
- 验证 Prompt 结构是否真正利用了缓存;
- 定位破坏缓存命中的变动内容;
- 在优化前后进行量化对比,评估调整效果。
可观测性的增强,往往比单纯的性能提升更有长期价值。它让缓存优化从「凭经验猜测」变成「基于数据迭代」,降低了调优门槛。
对开发者的实际影响
综合来看,GPT-6 的这次缓存升级并非单点优化,而是围绕「命中率—控制力—可观测性」三条主线的系统性改进:
| 改进方向 | 带来的收益 |
|---|---|
| 更高命中率 | 直接降低成本与延迟 |
| 显式断点 | 精细控制缓存边界,提升复用率 |
| 诊断信息 | 可观测、可量化、便于迭代优化 |
对于成本敏感或对延迟要求苛刻的生产应用,建议在迁移到 GPT-6 时重新审视自身的 Prompt 结构:将稳定内容前置、利用断点标记缓存边界、并借助诊断数据验证效果。
需要说明的是,本文基于官方发布的摘要信息整理,具体的命中率提升幅度、断点用法与定价细节仍需以官方完整文档为准。建议开发者在正式接入前查阅一手技术文档并进行小规模实测。
相关推荐
Jev模型爆火:专为Agent设计的极速判断引擎
Jev模型在国内AI圈爆火,搜索热度全球第一。这个专为Agent判断设计的小模型70毫秒出结果、成本便宜几百倍,本文解析其原理、置信度分层策略及四个值得改造的Agent落地场景。
AI没有意图也没有动机:重新理解智能与自主性的边界
Hacker News热议"AI没有意图也没有动机"这一论断。本文剖析大语言模型作为概率预测系统的技术真相,探讨拟人化陷阱、AI安全的正确框架,以及为何清醒认知AI本质对产品设计与公共叙事至关重要。
arXiv获1720万美元资助 独立运营为科研开放铺路
全球预印本平台arXiv获得Simons Foundation、XTX Markets和Siegel Family Endowment共计1720万美元的多年期慈善资助,支持其转型为独立非营利组织。本文解析这笔资金对开放科学与AI研究生态的深远意义。