GPT-6与ARC-AGI基准:抽象推理能力的实质跃迁

GPT-6 正式登场
近日,一则关于 OpenAI 发布 GPT-6(代号 Astra)的消息在 Reddit 等技术社区引发广泛讨论。根据社区流传的基准测试截图,GPT-6 在多项高难度评测中展现出显著提升,尤其是在被视为衡量通用推理能力试金石的 ARC-AGI 系列基准上表现抢眼。
大语言模型代际演进背景
GPT系列是OpenAI开发的生成式预训练变换器(Generative Pre-trained Transformer)模型家族。从2018年GPT-1的1.17亿参数,到GPT-3的1750亿参数,再到GPT-4引入的多模态能力,每一代模型都代表了深度学习架构、训练规模和优化方法的跨越式进步。这些模型的技术基石是2017年Vaswani等人在论文《Attention Is All You Need》中提出的Transformer架构。该架构的核心创新——自注意力机制(Self-Attention)——允许模型在处理序列中的每个位置时,同时关注序列中所有其他位置的信息,通过计算查询(Query)、键(Key)、值(Value)三组向量的点积注意力来动态确定信息的重要性权重。相比此前主流的循环神经网络(RNN)和长短期记忆网络(LSTM),Transformer不仅解决了长距离依赖的捕获难题,更因其高度可并行化的计算特性,使得模型规模的大幅扩展成为可能。
这一发展路径的理论基石是2020年由Kaplan等人提出的"Scaling Laws"(缩放定律),该研究揭示了模型性能与参数量、数据量和计算量之间存在可预测的幂律关系,为大模型的"越大越强"提供了理论依据。然而,这一范式在GPT-4之后开始发生微妙转变——纯粹扩大参数规模的边际收益递减,促使研究者转向更精细的架构创新。混合专家模型(Mixture of Experts, MoE)技术允许模型在保持巨大总参数量的同时,每次推理只激活部分参数,大幅提升计算效率。MoE的核心组件是一个可学习的门控网络(gating network),它在每个输入token到达时动态决定激活哪些"专家"子网络——例如一个总参数量达万亿级别的模型,每次推理可能只激活其中十分之一的参数,这使得模型在保持强大表示能力的同时将推理成本控制在可接受范围内。Google的Switch Transformer和Mixtral 8x7B等模型已在实践中验证了这一架构的有效性。
与此同时,训练范式也经历了深刻变革。早期的"预训练+微调"模式逐步演进为"预训练+指令微调+对齐"的三阶段流程。基于人类反馈的强化学习(RLHF)及其演进版本RLAIF(基于AI反馈的强化学习)则持续改善模型的对齐质量和推理可靠性。在RLHF的具体实现中,业界经历了从近端策略优化(Proximal Policy Optimization, PPO)到直接偏好优化(Direct Preference Optimization, DPO)的技术路线转换:PPO需要训练单独的奖励模型并通过强化学习迭代优化策略,流程复杂但灵活;DPO则绕过了显式奖励模型,直接从人类偏好数据中学习策略,大幅简化了训练流程。这些对齐技术的进步确保了更强大的模型同时也更安全、更可控。
GPT-5作为前一代模型,据传在推理能力上已有显著提升,而GPT-6(Astra)的出现则标志着OpenAI在推理深度和抽象能力上的又一次重大突破。值得注意的是,大模型的发展已从单纯追求参数规模转向优化推理效率、可靠性和通用问题解决能力,这一转向反映了整个行业从"更大"走向"更聪明"的战略共识。
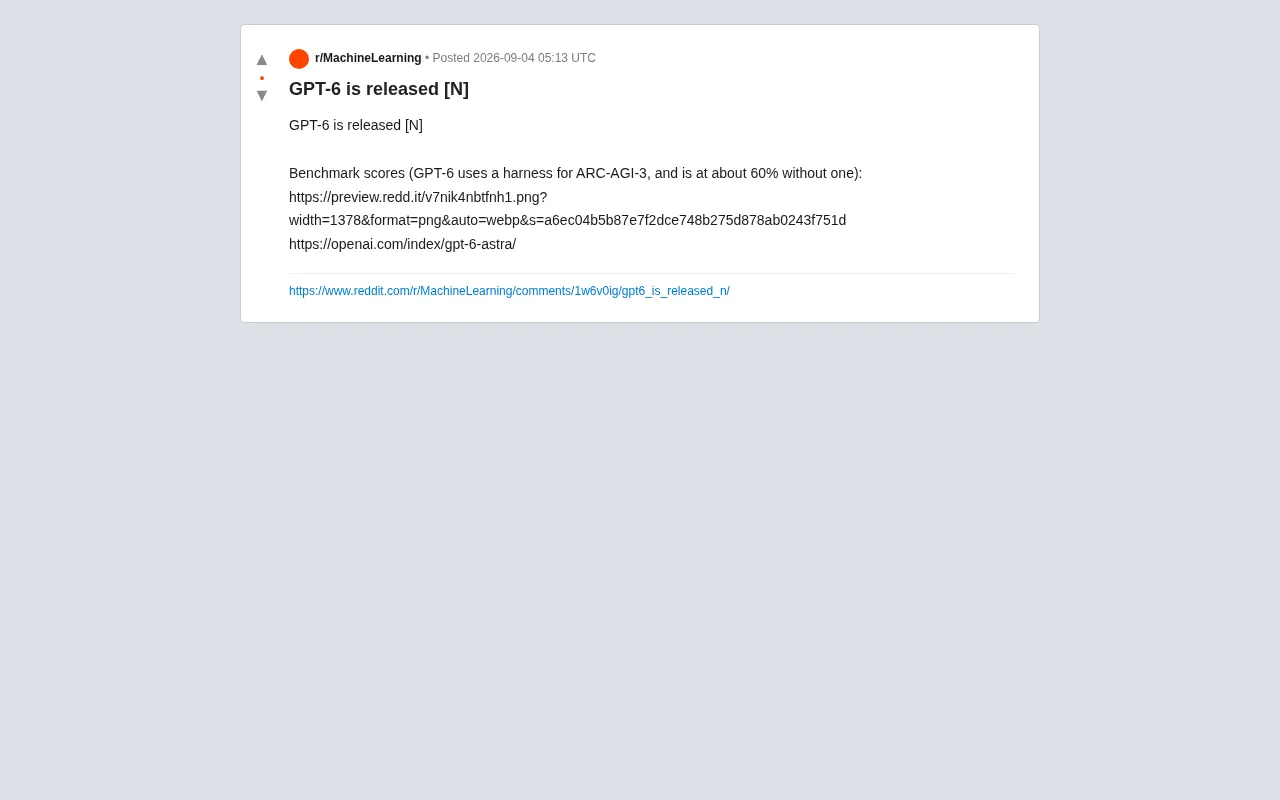
需要说明的是,本文基于社区公开讨论与流传的基准数据展开分析。在缺乏官方全面披露的情况下,读者应对具体分数保持审慎,但其中反映出的技术趋势仍值得深入探讨。
ARC-AGI 基准为何是衡量真正智能的试金石
从模式匹配到抽象推理的本质区别
ARC-AGI(Abstraction and Reasoning Corpus)由 François Chollet 提出,其设计初衷是区分模型的"记忆能力"与"真正的抽象推理能力"。与传统的语言理解或数学题基准不同,ARC-AGI 要求模型面对全新的、无法通过训练数据记忆解决的视觉逻辑谜题,从少数示例中归纳出潜在规则并推广应用。
ARC-AGI基准的技术原理
ARC-AGI由Google研究员François Chollet于2019年提出,包含400道训练题和400道测试题,每道题由2-3个输入输出示例和一个待解决的测试用例组成。题目以网格形式呈现,要求识别颜色、形状、对称性等抽象模式。其核心设计理念基于"开发集效率"(developer-aware generalization)——模型无法通过大规模数据记忆解题,必须具备即时归纳新规则的能力。
这一设计背后有着深刻的认知科学渊源。心理学将人类智能分为"流体智能"(fluid intelligence)和"晶体智能"(crystallized intelligence):前者是在全新情境下推理和解决问题的能力,后者是运用已有知识和经验的能力。传统大语言模型主要展现的是晶体智能——它们在海量文本上训练,善于调用和重组已见过的知识。而ARC-AGI专门测量的是流体智能,要求模型像面对智力测验一样,在零先验经验的条件下发现规则。
Chollet在其奠基性论文《On the Measure of Intelligence》(2019)中进一步明确了ARC-AGI的理论框架。他提出,真正的智能测量不应仅看任务表现,而应衡量"技能获取效率"(skill-acquisition efficiency)——即系统在给定有限先验知识和有限经验的条件下,能多快地获得新技能。为此,他定义了一组"核心先验知识"(Core Knowledge priors),这些先验受发展心理学家Elizabeth Spelke关于婴儿核心认知研究的启发,包括四大类别:物体性(objectness,理解世界由持久存在的离散物体组成)、目标导向性(goal-directedness,理解代理具有意图和目标)、数量与计数(numerosity,基本的数量直觉)、以及基础几何与拓扑(elementary geometry and topology,对空间关系如接触、包含、连续性的直觉理解)。ARC-AGI的每一道题目都围绕这些人类与生俱来的认知基础设计——模型被假定已具备这些先验,题目测试的是在此基础上进行新规则归纳的能力。这种设计确保了测试的公平性:不依赖特定文化知识或专业训练,而是考察最基本的认知灵活性。
这也是ARC-AGI与其他热门基准的根本区别:MATH和GSM8K测试的是形式化数学推理,HumanEval评估代码生成能力,GPQA考察研究生水平的专业知识问答——这些基准虽然各有难度,但都可能受益于训练数据中的相似题目。唯有ARC-AGI通过精心设计的新颖谜题,确保模型无法"背题",从而真正测量从少数样本中归纳抽象规则的核心认知能力。
人类平均得分约85%,而传统神经网络长期徘徊在20%以下,这种巨大差距凸显了当前AI在流体智能方面的根本性短板。Chollet认为这种抽象推理能力是通用智能的核心标志。
这一特性使其成为业界公认最难"刷分"的评测之一。长期以来,大语言模型在该基准上的表现远逊于人类,这也成为质疑"大模型是否具备真正智能"的重要论据。
GPT-6 在 ARC-AGI 上的分数意味着什么
据社区流传的信息,GPT-6 在 ARC-AGI-3 上借助专门的推理框架(harness)取得了较高成绩,而在不使用任何辅助框架的情况下,裸模型能力也达到了约 60% 的水平。
这个数字若属实,意味着相当可观的进步。回顾历史,GPT-4在2023年发布时,其在ARC-AGI原始版本上的裸模型得分仅约5%左右;即便是专门为推理优化的o1模型,在2024年也仅达到约25%的水平;此前在ARC Prize竞赛中表现最优的方案,通过精心设计的程序搜索和混合策略,才首次突破50%大关。60%的裸模型成绩若属实,意味着GPT-6在不依赖任何外部工具的情况下,单靠模型内部的推理能力就超越了此前最强的工程化方案。从认知科学的框架来看,这意味着模型可能正在发展出某种形式的"心智模型"(mental model)——即在内部构建问题的抽象表征,进行假设-验证循环,而非简单地进行模式匹配。这标志着GPT-6 在抽象规则归纳这一核心认知维度上,可能实现了架构或训练方法层面的实质突破,而非单纯依靠外部工具链的"作弊"。
Harness 推理框架:能力放大器还是外挂
围绕 GPT-6 使用推理框架(harness)这一点,社区出现了理性的讨论。所谓 harness,通常指在模型外部搭建的一套推理调度系统——例如多次采样、自我验证、程序化搜索或结构化提示流程,用以放大模型的原始能力。
Harness推理框架的技术实现
推理框架(harness)是包裹在基础模型外的增强系统,通常包含以下组件:提示工程模块负责构造结构化输入;采样策略控制生成多样性和探索深度;验证器对候选答案进行筛选或打分;记忆机制维护推理过程中的中间状态。
从认知科学的角度来看,这种架构与Daniel Kahneman在《思考,快与慢》中提出的双系统理论有着深刻的对应关系。Kahneman将人类认知分为系统1(快速、直觉性、自动化的思维)和系统2(缓慢、刻意、需要努力的分析性思维)。裸模型的单次前向传播类似于系统1——迅速给出直觉性回答;而harness增强的推理过程则更接近系统2——通过多步规划、自我检验和反思来处理复杂问题。然而,这一类比也有其局限性:人类的系统1和系统2在神经基础上深度交织,系统2可以将反复练习的技能"下放"为系统1的自动化过程,而当前的harness系统与基础模型之间的协作远未达到这种流畅的整合程度。尽管如此,这一类比为理解AI系统的推理增强提供了有益的概念框架,也指明了未来研究方向——如何将外部推理框架的能力逐步"内化"到模型本身。
在ARC-AGI这类任务中,harness的一个关键技术路径是程序合成(program synthesis)——将视觉模式转化为可执行代码,通过符号推理验证规则。具体而言,这通常涉及一种领域特定语言(Domain-Specific Language, DSL),即一组预定义的图像变换原语(如旋转、翻转、填充、扩展等),模型的任务变为在这些原语的组合空间中搜索出能将输入映射为输出的程序。2024年ARC Prize获胜方案正是采用了这种策略:让语言模型生成候选Python程序,再在训练样例上执行验证,最后选择通过所有样例的程序作为答案。这种方法本质上是一种神经符号混合系统(neuro-symbolic hybrid),结合了神经网络强大的模式识别和直觉猜测能力与符号系统的逻辑严密性和可验证性。这一研究方向可以追溯到上世纪80年代的专家系统,但在深度学习时代获得了新的生命力——DeepMind的AlphaCode、MIT的DreamCoder等系统都在探索类似的融合路径。
争议在于:若harness贡献显著,究竟应视为模型能力还是工程技巧?业界逐渐倾向于将二者作为系统整体评估,因为实际部署中两者本就不可分割。
这里存在一个值得关注的评价视角分歧:
- 一种观点认为,使用 harness 得出的高分不能完全代表模型自身能力,因为它引入了额外的计算与工程手段,与"裸模型"评测并非同一维度。
- 另一种观点则强调,现实应用中模型从来不是孤立运行的,配套的推理系统本身就是产品能力的一部分。能够被有效框架"放大",恰恰说明模型具备良好的可组合性与稳定性。
正因如此,OpenAI 同时公布带 harness 和不带 harness 两个版本的分数,是一种相对透明的做法——既展示了产品的实际上限,也保留了对基础能力的诚实评估。
从 GPT-5 到 GPT-6 的推理能力演进
深度推理成为大模型竞争焦点
纵观近两年大模型的发展轨迹,行业竞争的重心已从单纯的"知识广度"和"语言流畅度",转向"深度推理"与"复杂问题求解"。从思维链(Chain-of-Thought)到推理时计算扩展(test-time compute),各家实验室都在探索如何让模型"想得更久、更深"。
推理时计算扩展技术
推理时计算扩展(test-time compute scaling)是指在模型推理阶段投入更多计算资源以提升输出质量的技术范式。不同于传统的"一次前向传播即出结果",这类方法允许模型进行多步思考、自我验证或搜索探索。
理解这一方向需要回到Scaling Laws的双重维度。经典的缩放定律关注的是训练时计算(train-time compute)——更大的模型、更多的数据、更长的训练产生更强的能力。但2024年以来,业界发现了
相关推荐

Antigravity调用Gemini报错真相:IP风控实测与应对
Google Antigravity IDE调用Gemini模型频繁报错?实测发现同一账号仅切换IP即可恢复,且同IP在AI Studio仍可正常使用。本文解析这一基于IP的风控策略、成因推测及排查应对思路。
AI超级员工系统拆解:营销自动化工具的能力与风险
一款宣称"全接管基础岗位"的AI超级员工系统在B站流传,本文拆解其视频生成、数字人克隆、智能体和批量获客等功能,并客观分析其中的合规与安全风险,提醒用户警惕"免费领取"营销套路。
群像才是团体的灵魂:内娱几首氛围感满满的合唱盘点
从07届快男到NINE PERCENT,盘点内娱几首氛围感满满的群像合唱歌曲。相比单人高光与数据热度,一群人并肩同行的情谊才是团体无可替代的灵魂。