GPT-6控制Blender生成白膜:AI视频可控化新方案
用AI智能体控制Blender生成白膜预演视频,再交Seedance渲染,让AI视频从抽卡变成工程化可控。
本文介绍了一套由B站UP主深白色实践验证的AI视频新工作流:通过Codex(搭载GPT-6)以自然语言驱动Blender完成建模、镜头轨迹与运镜设计,自动输出白膜预演视频,再将其作为结构参考输入Seedance 2.5进行最终渲染。白膜的核心价值在于提前锁定镜头走位与空间关系,把AI视频生成从随机「抽卡」转化为可控的结构复现。为控制成本,作者提出「GPT-6负责首次连接建模、GPT-5.6负责后续镜头修改」的分工策略。成本测算显示,加入白膜参考后渲染费用约多出20%,但在复杂场景中可显著减少返工次数,综合来看更划算。作者已将相关Blender Skill整理分享,以降低其他创作者的复刻门槛。
OpenAI上线GPT-6后,围绕AGI的讨论再度升温。但抛开这些争议不谈,对AI视频创作者来说,一个更实际的变化已经发生:通过智能体(Codex或Claude)去操控Blender完成建模、镜头设计和运镜,先生成一段白膜预演视频,再结合Seedance 2.5(C-Dance 2.5)的渲染能力生成最终成片。B站UP主深白色完整跑通了这套流程,本文梳理其中的关键环节、技巧与成本账。
白膜视频为什么是可控性的关键
Seedance 2.5上线时的重点宣传能力之一,就是白膜渲染。所谓白膜,是指没有材质、纹理的纯几何模型视频。它的价值在于——如果我们能先把白膜视频精确地做出来,那么AI视频里最难控制的镜头走位、空间关系、运镜节奏,都可以被提前设计好。
此前有官方活动提供了一段白膜视频,让参赛者据此渲染成片。深白色实测后发现,虽然效果谈不上完美,但白膜确实能大幅提升画面的可控性。问题随之而来:如何高效地生成这么一段白膜视频?
传统的3D导演台工具虽然能搭场景、摆人物、控制镜头运动,但建模、调整镜头轨迹和角度依然需要耗费大量时间。既然进入了AI时代,这些繁琐工作理应交给AI来做。
Xfield率先做出了一项有意思的创新:把Claude与Blender连接起来,通过Claude创建场景、设计镜头,最终生成白膜视频。深白色认为,这很可能就是AI视频走向真正可控的终极方案。但Xfield的方案需要下载其Blender插件,且必须购买会员才能使用,价格并不便宜。
白膜(Grey/White Box)概念源自游戏开发领域的「白盒测试」流程,在影视预演中也称为「Previz(Pre-visualization)」。其核心逻辑是:在投入材质、灯光、特效等高成本制作之前,先用最低成本锁定空间关系和镜头语言。传统电影工业中,预演通常由专职的3D预演艺术家完成,需要数天乃至数周时间。AI视频领域引入白膜逻辑,本质上是把这套工业管线中的「镜头锁定」步骤移植过来,用以对抗扩散模型生成视频时固有的随机性——模型每次推理都会在噪声空间中重新采样,导致镜头角度、主体位置无法跨帧保持一致。白膜作为结构化参考输入,相当于给扩散模型施加了空间约束,从而将「抽卡」问题转化为「结构复现」问题。
用GPT-6一句话打通Codex与Blender
深白色此前尝试过多种方式复刻这一功能均未跑通,直到GPT-6出现,用一句话就完成了连接。
完整方案的前置条件:安装Codex并切换到GPT-6模型,同时安装Blender(官网免费下载,建议手动安装以节省Token)。随后在预先编写好的Skill引导下,让Codex与Blender逐步建立连接。连接成功后,就可以用自然语言描述想要的场景或镜头。
在实测案例中,作者让它做一个简单的坦克模型,本以为方块拼凑即可,没想到它花约4分钟做出了带履带、炮筒、炮台细节的模型。接着给出更完整的指令——生成一段30秒电影片段,内容为现代战争中坦克在城市废墟中前进并炮轰前方阵地。约5分钟后,它一次性完成了建模、镜头轨迹、取景与构图,并直接输出白膜视频。
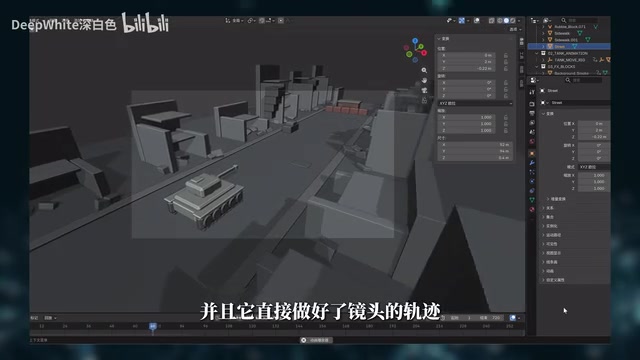
将这段白膜视频结合此前生成的资产图、场景图,写出视频提示词后交给Seedance 2.5渲染,最终成片基本复刻了白膜预演的镜头运动、主体位置与整体节奏。
Codex是OpenAI推出的代码生成与执行智能体,其核心能力在于能够调用外部工具、执行脚本并与本地或云端软件交互。Blender本身内置了Python脚本接口(bpy模块),几乎所有建模、动画、摄像机操作均可通过Python命令驱动。Codex与Blender的连接,本质上是让语言模型将自然语言描述翻译成bpy脚本,再通过本地Socket或命令行接口实时注入Blender执行。GPT-6相比此前版本在工具调用的鲁棒性和多步推理稳定性上有显著提升,这使它能在单次对话中完成「理解场景需求→编写建模脚本→调用摄像机API→输出渲染指令」的完整链路,而无需人工介入中间步骤。这也解释了为何GPT-5.6在首次连接时容易断链,而在路径已建立后反而能够胜任后续的增量修改任务。
参考图与分镜表:更精细的空间控制
除了直接生成,这套流程还支持喂入参考图。作者给出一张参考图,让AI先据此建模还原空间。首次生成存在问题:人物背景本应是玻璃墙,且视野外的部分没有补全。第二遍修改时,作者补充了多角度图片帮助AI理解空间结构,并明确说明背面是墙、两侧是玻璃门,仅用两分钟便完成了修正。
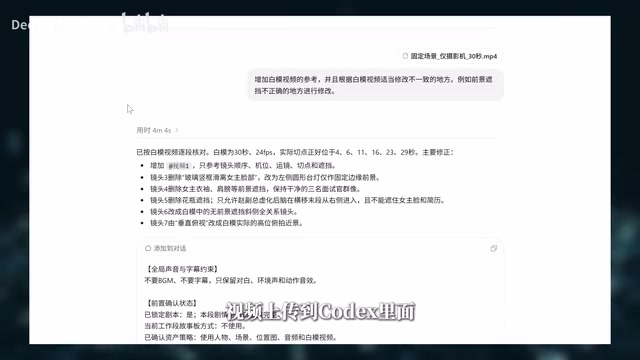
对于镜头语言、构图和运镜,作者上传了自己预先写好的分镜表,让AI据此生成白膜。通过白膜视频可以直观预演当前的镜头语言,发现不满意的地方就修改分镜、重新生成。最终把满意的白膜视频上传回Codex,用「导演拍摄技能」参考白膜生成视频提示词——提示词中会自然带上对参考视频的引用,且每段的运镜、构图、人物表现都与白膜相匹配,从而生成真正可控的成片。
GPT-6跑通、GPT-5.6接力的省钱思路
一个值得注意的现象是:GPT-6能一次性控制Blender,而GPT-5.6一开始却做不到。作者的解法是——先用GPT-6跑通整个流程,把模型、场景、操作路径都建立好,之后再切换回GPT-5.6继续设计新的镜头轨迹。
实测中切换到5.6后用16分钟生成的新白膜视频,效果与6几乎看不出区别。原因在于操作路径已经铺好,后续镜头设计的难度大幅降低,5.6也能胜任。由于GPT-6当前的额度消耗非常大,这种「6负责首次连接建模、5.6负责后续修改」的分工会更划算。
成本账:白膜预演到底值不值
费用是创作者最关心的问题。作者给出了参考数据:
- 从零建模并制作一个坦克白膜视频(含修改),消耗了PLUS会员5小时滚动额度的约40%。若已购买会员,这部分不产生额外现金支出。
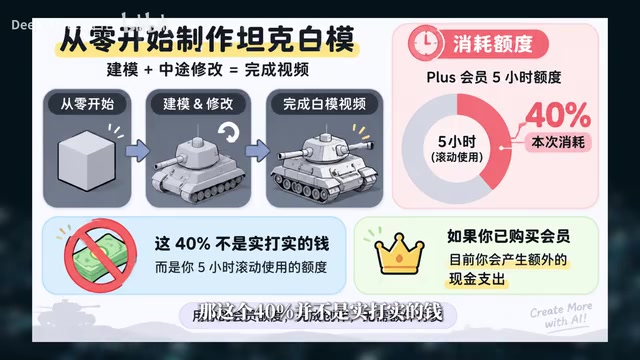
- 正式渲染方面(画布内直接使用的价格),以Seedance 2.5的30秒720P规格为例:直接生成约需56.7元,使用参考视频则涨到68.4元,即多出约20%。
结论比较清晰:如果画面简单、随机性低、有把握一次成功,直接生成成本更低;但只要需要多次「抽卡」,哪怕只抽两次,成本就会立即超过带白膜参考的方案。对于多人物调度、复杂走位、连续动作等场景,作者建议宁可多花20%用白膜视频作参考——这不仅省下反复抽卡的钱,更重要的是减少返工、节省时间,让结果更可控。
「抽卡」在AI视频社区中是对「多次随机生成、从中挑选满意结果」这一工作模式的口语化描述,类比手游中概率性获取道具的机制。由于当前主流文生视频模型(包括Seedance、Kling、Sora等)均基于扩散Transformer架构,每次生成本质上是独立的随机采样过程,相同提示词的两次生成结果在构图、光影、动作细节上往往存在显著差异。这导致创作者在没有结构性参考输入时,往往需要生成5至20次甚至更多才能获得一个符合预期的镜头,而每次生成都产生实际费用。白膜参考视频的引入,将这种「开放式随机采样」收窄为「有约束的结构复现」,从概率上大幅减少满意结果所需的生成次数,这是其经济性价值的底层逻辑。
写在最后
作者把用Codex控制Blender的经验,以及Xfield插件的操作逻辑、连接方法,整理成了一个Blender Skill分享出来。他也坦言,即便没有这个Skill,GPT-6依然可以直接控制Blender,Skill的作用主要是减少摸索流程、节省Token,并补充建模、镜头设计和连接方面的逻辑。
GPT-6是否意味着AGI真正到来,目前仍无定论,但它展现出的能力已经能帮创作者实现过去只敢想象的工作流。「智能体控制Blender生成白膜 + Seedance渲染」这条路径,为AI视频从「抽卡碰运气」走向「工程化可控」提供了一个值得认真对待的样本。
相关推荐
MotoGP米萨诺冲刺赛:马奎斯轮胎策略夺冠全解析
MotoGP米萨诺圣马利诺站冲刺赛,马奎斯凭借中性胎策略在一号弯极限超车带开比赛夺冠。深度解析轮胎博弈、超车线路与积分变化,贝泽奇、马丁分列二三名。
马王归来:马奎斯与伤病的漫长拉锯与MotoGP捷克站
马克·马奎斯MotoGP捷克站表现回顾:从2018年肩伤、连续多次手术到2025年第九冠再到2026年伤病复发的归来之路,以及杜卡迪续约至2028年的最新消息。
MotoGP圣马力诺站:马奎斯登顶争冠,主场英雄一圈崩盘
2026 MotoGP圣马力诺站正赛回顾:马克·马奎斯米萨诺夺冠并首次登顶积分榜,主场英雄贝塞奇第一圈摔车退赛争冠崩盘,阿科斯塔KTM封神获季军。