GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
付费订阅GPT不等于自动用上GPT-6,需进入工作模式并手动开启完整权限与最高思考强度。
本文整理了在电脑端完整体验GPT-6能力的操作路径。核心结论是:购买订阅套餐(Plus 20美元或Pro更高档位)之后,GPT-6并不会自动出现在普通聊天界面——它被刻意置于GPT-work客户端的"工作"模式中,且需要用户手动在模型列表中选中GPT-6、将思考强度调至最高,并开启"完整权限"后确认,才能真正激活GPT-6 Ultra级别的推理能力。网页版同样存在隐藏解锁路径,但操作更繁琐且容易被"重置"按钮打回默认状态。文章还建议新用户优先用Apple ID注册以规避手机号验证,并从Plus套餐起步按需升级,避免为过高额度提前买单。
如果你想在电脑上体验GPT-6的完整能力,而不是仅停留在网页版的对话模式,通过官方客户端GPT-work(即Codex客户端)是目前较为直接的路径。本文根据B站UP主的实操教程整理,梳理从账号注册、订阅充值到开启GPT-6 Ultra最高思考强度的完整流程,并说明网页版与客户端在模型解锁上的差异。
为什么推荐订阅版而非API
教程作者明确建议使用GPT的订阅版本,而非直接调用API。原因很简单:API按量计费的方式在高频、长文本场景下成本会急剧上升,对于需要与模型进行大量高质量对话的普通用户而言,固定月费的订阅套餐显然更划算。
订阅套餐分为几档:入门的Plus版本为每月20美元,适合轻度到中度使用;重度用户则可以考虑Pro会员,提供5倍和20倍两种额度选项。作者特别指出,如果是重度使用,20倍档位(对应约200美元价格)实际上非常值得,因为它给出的额度远超其价格所对应的常规消耗预期。
API(应用程序接口)是一种按实际消耗的Token数量计费的调用方式,Token可理解为模型处理文本的最小单位,中文大约每1-2个字对应1个Token。GPT-6这类大模型在处理长文本或复杂推理时,单次调用可能消耗数千乃至数万个Token,在高频使用场景下费用累积极快。相比之下,订阅制以固定月费换取一定额度内的无限制使用权,更适合日常深度用户。Pro版本的"5倍"和"20倍"档位,指的是相对于Plus基础额度的倍增,对应更高的月费上限,实质上是为高强度用户提供更大的使用空间,而非单纯的速度加成。
账号注册与客户端下载
第一步是准备好网络节点,确保能正常访问OpenAI服务。随后在Google搜索"Test GPT-work",下载对应的Windows版本客户端。这个GPT-work就是前文提到的Codex本地客户端,下载安装后即可运行。
如果你此前已有OpenAI账号,可以直接登录;没有的话,打开GPT官网右上角点击免费注册即可。注册方式支持Google邮箱和Apple ID。作者推荐使用Apple ID注册,因为这种方式通常能规避手机号验证等常见的注册障碍,流程更顺畅。
GPT-work(Codex客户端)是OpenAI面向开发者和高级用户推出的本地桌面端应用,与网页版ChatGPT的主要区别在于它整合了更多工作流功能,包括直接读取本地文件、执行代码、生成结构化文档等,定位更接近AI工作台而非单纯的对话工具。"Codex"这一名称在OpenAI历史上曾指代其代码生成模型,现在被复用为这款客户端的内部称谓,但功能已不限于代码场景,覆盖了文档处理、数据分析等通用办公任务。使用客户端的另一个优势是模型选择和参数调节的入口更为集中,不像网页版那样将高级选项分散在多个隐蔽位置。
购买套餐与充值方式
登录客户端后,进入设置页面,在左侧找到"使用情况和计费"选项,点击"查看套餐"。如果尚未购买会员,可以直接在此选择套餐并完成购买。
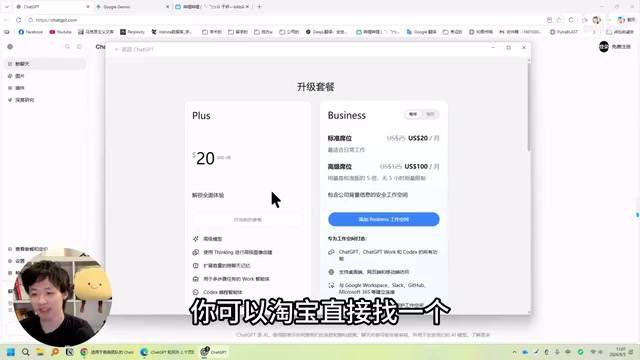
充值方式主要有两种:如果持有海外银行卡,可以直接支付;没有海外卡的用户,可以通过淘宝等第三方渠道代充。对于额度需求判断,作者的建议是——先从Plus起步,如果发现20美元的额度不够用,再往下滚动升级到Pro的5倍或20倍档位。这种阶梯式的选择逻辑,能帮助用户避免一开始就为过高额度买单。
关键:如何真正开启GPT-6
这是整个教程最核心也最容易踩坑的部分。购买会员后返回主界面,很多人会发现一个反直觉的现象:如果只是普通聊天,你根本用不到GPT-6。在聊天模式下,可选模型最高只到GPT-5.6。
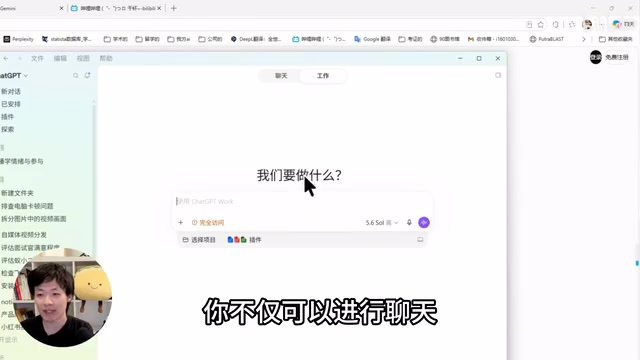
想要用上GPT-6,必须进入GPT-work的"工作"模式。这个模式不仅支持对话,还能执行办公任务,比如读取文档、分析表格、输出网页或报告、编写代码等。在调整思考强度和选择模型的入口,初始状态同样只显示GPT-5.6,且调节的仅是5.6的强度。
解锁的关键动作是:在模型列表中点击一次后,会出现新的GPT-6选项,选中它并将思考强度调到最高。这里有一个必须注意的细节——一定要打开"完整权限"并点击确认,这样才能真正启用最高级别的GPT-6 Ultra版本。如果想加快生成速度,还可以开启1.5倍速选项。至此,才算是完整的"满血版"GPT-6。
"思考强度"(Thinking Intensity)是OpenAI在推理模型中引入的一个控制参数,用于调节模型在生成回答前进行内部推理(Chain-of-Thought)的深度与计算资源投入。强度越高,模型在回答前会"思考"更多步骤,推理链更长,输出质量和逻辑严密性通常更强,但相应地消耗的计算资源(即额度)也会显著增加,生成时间也会延长。GPT-6 Ultra对应的就是这套机制下的最高档位,也是目前对外开放的推理能力天花板。"完整权限"选项的存在,表明官方将最高规格的推理能力设置为需用户主动确认的非默认状态,以此控制全局负载。
网页版的隐藏解锁路径
对于不想安装客户端、偏好网页版的用户,教程也给出了替代方案,但操作更为隐蔽。
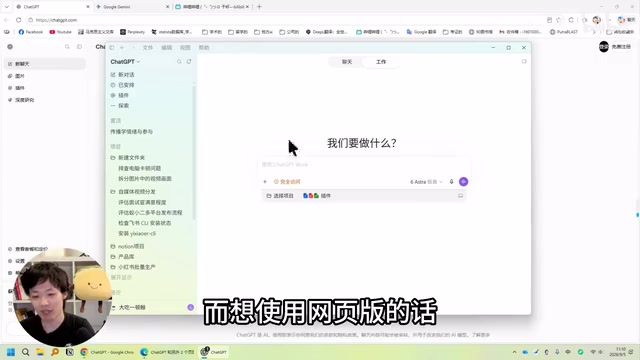
在网页版的工作界面中,点击思考强度调节,向上拖动时GPT-5.6会自动切换为GPT-6的"轻"和"中"档位,但到此就无法继续往上了。想要调到"极高"甚至"最高",需要点击下方的下载列表,选中GPT-6,此时才能继续向上调节。不过要留意,一旦点击"重置",设置又会回退到默认状态。
作者对此推测,官方之所以把高档位藏得这么深,可能是出于控制额度消耗速度的考虑,也可能是为了缓解服务器压力。无论哪种原因,结论都是一致的:想体验真正高级别的GPT-6,需要手动一层层把设置调到最高,默认状态下系统并不会给你最强的配置。
小结
整个流程的价值点在于揭示了一个信息差:付费订阅并不等于自动获得最强模型体验。GPT-6被刻意放在"工作"模式而非普通聊天中,且需要手动开启完整权限和最高思考强度。对于真正需要高质量输出的用户,理解并完成这些设置,才能物尽其用地发挥订阅套餐的价值。
相关推荐
无需框架:用Python+Ollama打造本地ReAct AI Agent
不依赖 LangChain 等框架,用纯 Python 配合本地 Ollama 从零打造具备工具调用能力的 ReAct AI Agent。100% 本地运行、无需 API 密钥,深入理解智能代理的推理循环与消息管理机制。
海外博主实测DeepSeek新Flash模型:KV缓存效率暴涨337倍
海外博主实测DeepSeek新Flash模型,KV缓存效率相比V1提升337倍。文章详解其架构重构、视觉生成、原生目标检测与AutoML能力,以及harness选择对性能的关键影响与实际适用场景。
DeepSeek V4.1 Flash编程工具实测:原生图像与缓存复用大升级
DeepSeek V4.1 Flash编程工具链迎来重大升级,新增原生图像输入、缓存复用优化、文件预览与智能体控制。本文详解开源Harness架构、安装配置及两个实测案例。