GPT-6与Claude Opus 5.5实测对比:谁在偷偷特调?

GPT-6三档与Claude Opus 5.5同日竞技,揭示图像生成能力差距与测试题过拟合隐患。
OpenAI的GPT-6 Luna/Sol/Astra与Anthropic的Claude Opus 5.5在同一天发布,B站UP主以「猫骑车」为统一测试题进行横向对比。OpenAI三款模型呈现明显能力梯度:Luna基础造型失误较多,Sol基本可用但细节粗糙,Astra精细度最高。Claude Opus 5.5以丰富的动态细节(随风飘动、链条、骑行起伏、夜间车灯)和车筐放老鼠的创意见长,但基础造型存在小瑕疵。测试最值得关注的发现是:Claude在原版「刺猬测试」上表现优异,换成猫后有所下滑,暗示可能存在针对特定测试题的过拟合优化。UP主提醒,单一图像测试不能代表模型全部能力,选主力模型应结合效果、速度与价格,并用真实任务验证。
OpenAI和Anthropic在同一天发布新模型,一边是GPT-6 Sol和Luna,另一边是Claude Opus 5.5,发布时间撞在一起,颇有几分针尖对麦芒的意味。B站UP主元宝用一套统一的图像生成测试,把这几款模型放在同一条起跑线上比拼,还顺带揪出了一个耐人寻味的问题——有模型疑似针对特定测试题做了「特调」。
测试方法:为什么把刺猬骑车换成猫
这次测评沿用了经典的「动物骑自行车」生成测试,但UP主特意把原本流行的「刺猬骑车」换成了「猫骑车」。原因很直接:有些模型在刺猬这道题上表现极佳,可一换动物就露了馅,存在针对性优化的嫌疑。
评判标准锁定三件事:猫和车画得对不对、骑行姿态合不合理、以及题目要求的细节完成了多少。为了拉出参照系,测试还额外请来了更高等级的GPT-6 Astra作为标杆,形成四个模型同题竞技的局面。这种「换题验证」的思路,本质上是在测试模型的泛化能力,而非记忆特定样本的能力。
「泛化能力」是机器学习中的核心概念,指模型在未见过的新数据或新场景上保持良好表现的能力,与之相对的是「过拟合」——模型对训练数据或特定样本记忆过深,导致换一道相似题就会失手。对大型语言/多模态模型来说,过拟合不仅发生在训练阶段,还可能以「针对性优化」的形式出现:开发者察觉到某道题在社区中广泛流传后,专门对该题的生成结果进行强化调优,使模型在这道题上的表现远超其真实能力水平。这种现象在AI评测圈也被称为「benchmark gaming」(榜单刷分)。正因如此,独立测评者往往会对流行测试题进行变形或替换,以区分模型的真实泛化能力与对特定样本的记忆效果。
OpenAI阵营:三档分明的完成度
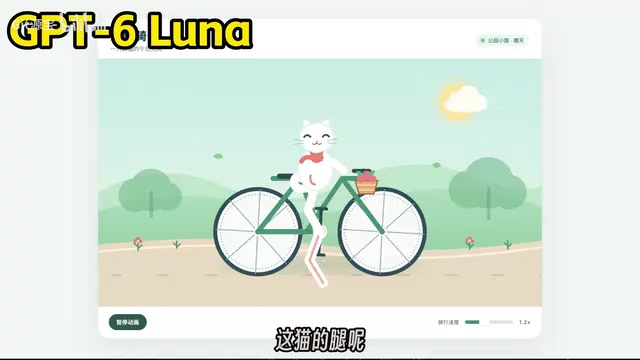
先看GPT-6 Luna。结果相当拉垮——猫的腿画成了「大分叉」,屁股没坐在座椅上,车子的行进方向也不对,几乎全是扣分点。UP主的评价直接给到「拉完了」,因为这只猫看着挺凶,但压根没在骑车。
二哥GPT-6 Sol明显正常许多:猫长得像猫了,身体和脚都在正确位置,但车子没有链条,猫脸细节也有些糊弄,整体能看但不够精致。这一档被归为「NPC」水平。
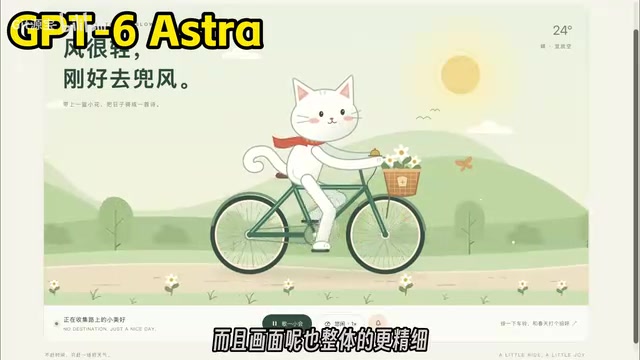
真正撑场面的是大哥GPT-6 Astra。该有的细节全都到位,画面整体更精细,被给到最高档「夯」。三个结果并排一看,从Luna到Sol再到Astra,完成度一档一档往上走,模型等级的森严一目了然,也算印证了「一分钱一分货」的定价逻辑。
Claude Opus 5.5:动态细节是亮点
Claude Opus 5.5的表现颇有意思。它在车筐里放了一只老鼠,相当于「出门骑车还带上干粮」,这种自主发挥的巧思让画面多了几分生活感。
它的短板也存在:猫的鼻子和嘴巴有点歪,道路两侧宽度一大一小不太协调。但动态细节做得确实出色——有随风飘动的效果,车上有链条,身体会随骑行上下起伏,甚至能切换到夜间模式并打开车灯。这些小细节叠加起来,让整个画面「活」了不少。
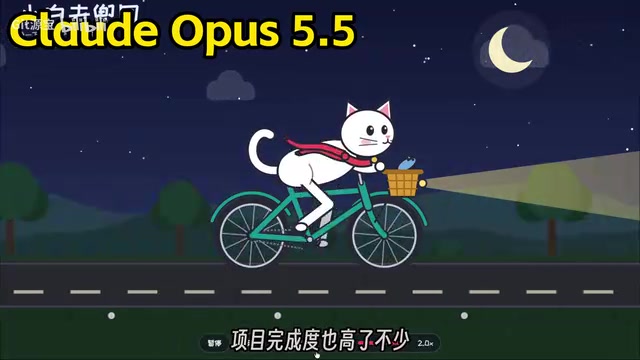
综合基础造型的瑕疵和动态完成度,UP主给Claude Opus 5.5的评级是「人上人」。仅就这一轮猫猫测试而言,最终排序基本明朗,但作者也反复强调:这只是单一图像生成任务的排名。
单一测试的局限与「特调」疑云
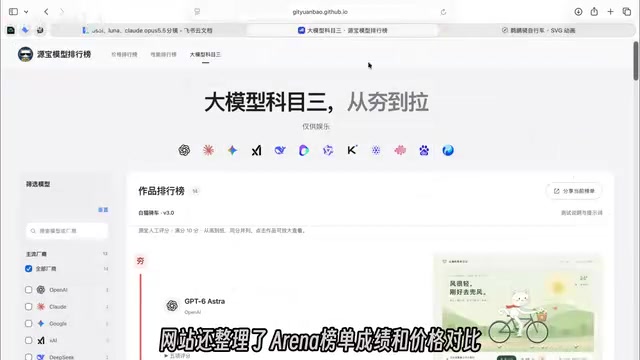
这条测评最值得关注的,其实是方法论上的提醒。UP主明确表示,这个排名对做网页、做动画有参考价值,但写文章、查资料、处理文件等任务不能照搬——选主力模型还得综合效果、速度和价格一起看。为此他把其他主流大模型的测试结果、AI榜单成绩和价格对比都整理进了一个排行网站,方便横向参考。
回到开头的疑点:谁家模型做了特调?作者展示了Claude在「刺猬测试」上的效果,确实很不错,但一换成其他动物,表现力就明显下滑。他谨慎地没有下定论——单凭一组结果还不能认定Claude专门针对刺猬做了优化,但可以确认的是:刺猬做得好,不代表换一道相似题它也能做得同样好。这正是把测试题从刺猬改成猫的核心动机。
这个观察对普通用户很有启发。跑分和demo里的惊艳表现,未必能迁移到自己的真实场景。评估AI模型时,用自己的实际任务去测,比看官方演示更靠谱。
「过拟合」在图像生成模型的评测场景中尤为隐蔽。文字问答类的过拟合通常会在稍作改写后暴露,但图像生成任务的提示词变化(例如「刺猬」换成「猫」)在语义层面差异极小,模型理论上应具备相近的完成度。如果两者之间出现显著落差,说明模型很可能对原始提示词的视觉输出做了专项强化,而非真正提升了「理解动物骑行姿态」的底层能力。这类针对性优化的成本远低于大规模训练改进,但在用户层面却很难被察觉——尤其当大多数人只用最流行的那几道题来评估模型时。
结语
这轮对比呈现出清晰的分层:OpenAI用Luna、Sol、Astra三档产品拉开了明显的能力和价格梯度,Claude Opus 5.5则以丰富的动态细节和自主创意见长。但更重要的一课在于——不要用单一测试题定义一个模型的全部能力,也要警惕模型可能对流行测试题存在过拟合。想选对主力模型,最终还是要回到自己的真实需求上做取舍。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。