ChatGPT全双工语音模型GPT Live发布:对话体验全面革新

语音交互的"图灵时刻"
"图灵时刻"这一表述有其深厚渊源。计算机科学先驱艾伦·图灵于1950年在论文《计算机器与智能》中提出"模仿游戏"(Imitation Game),即后世所称的图灵测试——当一个人在不知情的情况下,无法通过对话分辨对方是人还是机器时,则认为该机器达到了人类水平的智能表现。值得补充的是,图灵原始论文中的测试对象实际上是「模仿女性的男性」与「真实女性」的比较,AI只是后来的延伸诠释。2014年「尤金·古斯特曼」程序宣称通过图灵测试,但批评者指出其策略是扮演「英语非母语的13岁乌克兰男孩」来规避语言能力评估——这一案例深刻揭示了图灵测试的边界所在。
值得注意的是,图灵本人从未将该测试定义为智能的终极标准,而是将其视为一种可操作化的替代指标。此后数十年间,哲学家约翰·塞尔的"中文屋"思想实验等批评从未停止:1980年,塞尔描述了一个不懂中文的人按照规则手册处理中文符号输入输出的场景——从外部观察者的角度,该系统似乎"理解"中文,但其内部实际发生的只是符号的机械替换,毫无语义理解可言。这一思想实验直指图灵测试的根本局限:通过测试只能证明行为上的模拟,无法证明真正的理解或意识。然而在工程实践层面,图灵测试将评估标准锚定在人类感知体验上,而非抽象的计算能力指标,这一点仍具有极强的指导意义。GPT Live的发布团队选择援引这一概念,本质上是在宣告:语音交互已从"能用"跨越到"自然",从工具属性迈向伙伴属性——这一标准从"功能完成率"转向了"交互自然度",而GPT Live正是在这一维度上发起冲击。
OpenAI 在最新直播中正式发布了 ChatGPT Voice 全新版本,背后由代号 GPT Live One 的语音模型驱动。官方将其定位为"有史以来最强大的语音模型"——一个真正意义上的全双工(full-duplex)对话伙伴。
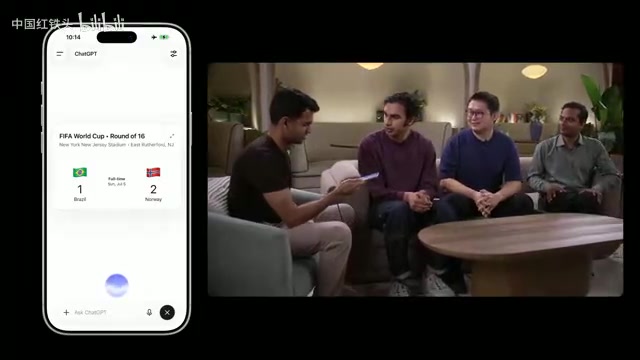
发布会的开场本身就是一次演示:OpenAI 团队与 ChatGPT 共同主持了这场直播。整场活动中,AI 始终"在线",无需唤醒词,随时可以插话、补充或主动退让,呈现出前所未有的对话流畅度。
这值得关注,因为过去几年间,语音助手虽持续迭代,却始终存在一个根本痛点:交互不自然。用户不得不小心翼翼地"轮流发言",在嘈杂环境下更是几乎完全失效。GPT Live 试图从架构层面彻底解决这一问题。
正如团队在直播中所说:"这是与技术对话终于像真正的对话,而不是命令行的时刻。"
核心突破一:全双工连续交互
本次发布最关键的技术突破,是模型实现了真正的全双工能力。
什么是全双工?
全双工(Full-Duplex)概念源自电信工程领域。在传统通信系统中,信道分为三种模式:单工(Simplex,只能单向传输,如广播)、半双工(Half-Duplex,双向但不能同时进行,如对讲机)、全双工(Full-Duplex,双向同时传输,如电话)。发布会上给出了一个直观比喻:就像你和朋友打电话,双方可以同时听和说——这就是全双工。
值得深究的是,电话全双工的工程实现远非直觉上那样简单。贝尔实验室在1960年代开发的混合线圈技术和后来的数字信号处理芯片,解决了「声学回路」(Acoustic Echo)问题——即麦克风拾取扬声器声音后形成的自我干扰。这一技术从物理层面将发送信号与接收信号分离,使双方得以同步通话。AI语音全双工面临类似但更复杂的挑战:模型需要在语义层面而非物理层面实现「回声消除」,建立对自身输出的实时追踪,并将其从输入理解中剥离。这本质上是一个需要元认知能力的任务,要求系统在说话的同时「知道自己说了什么」,从而避免将自身的输出误判为需要响应的新输入——这在单一神经网络推理流中是一个极具挑战性的工程问题。
然而,全双工技术在AI语音领域的实现远比电话系统复杂。传统电话利用物理信道分离(频分或时分)实现双向同步通信,而AI语音全双工面临的是算法层面的挑战:模型必须在同一神经网络推理流程中,同时维持输入流的实时理解与输出流的连续生成,且两者在语义层面相互影响。早期语音AI系统受限于端点检测(VAD,Voice Activity Detection)技术——系统必须先判断用户是否说完,才能开始处理并回应,本质上是半双工架构。
VAD技术自1970年代数字电话系统起即被广泛使用,最初目的是压缩带宽——在传统电话中,人类对话约有50%的时间是静默的,VAD可以识别这些静默区间并停止传输,大幅降低信道占用。早期基于能量阈值的VAD在安静环境下有效,但存在根本性局限:它是一个二元分类器(说话/不说话),无法理解语义完整性。这导致用户在「思考停顿」时系统误以为发言结束,或在句子末尾语调上扬时系统误判——这些都是规则系统无法解决的语义层问题。更深层的挑战在于,即便是最先进的深度学习VAD,也只能判断声学信号的存在,无法感知"这句话的意思说完了吗"——这需要完整的语言理解能力,而非信号处理。早期解决方案,包括微软Cortana、亚马逊Alexa等,均依赖VAD作为"交通指挥员",强制实施发言权转换,在嘈杂环境中尤其脆弱。这一机制导致了用户熟悉的"卡顿感"和"被打断就崩溃"的体验。
GPT Live的架构突破在于将"监听-理解-生成"统一至同一连续计算图中,配合流式推理框架(Streaming Inference),使模型能够在token级别上交织处理输入与输出,从根本上消除了轮次边界。实现AI语音全双工的核心挑战在于:模型需要在生成输出的同时,持续监听并理解输入流,还需实时判断何时应该停止说话、何时应该让步,这对实时推理和流式处理架构提出了极高要求。
用团队成员 Kundan 的技术表述来说,全双工意味着模型"可以持续处理输入流,同时持续产生输出流,始终如此"。"对话不再有回合(turns)的概念"——模型能够即时响应用户的打断、停顿、纠正,乃至"边想边说"的自然思维流程。
实时翻译:全双工能力的极致体现
实时语音翻译(Simultaneous Speech Translation)被公认为语言技术领域最复杂的任务之一,也是认知负荷最高的人类语言任务之一。研究表明,专业口译员工作时大脑前额叶皮层的激活程度远超普通双语者,且通常需要每隔30分钟轮换以避免质量下降。其核心挑战在于:人类语言具有"头部重量"特性,尤其在中文、日语等语言中,句子的核心语义往往在句尾才完整呈现(如动词置于句末的SOV结构),而传统同声传译系统需要积累一定信息量后才能输出,不可避免地引入延迟。口译员因此发展出"预期策略"(Anticipation Strategy)——根据语境、语法规律和领域知识预判句尾语义,提前开始输出翻译——这是一项需要数年训练才能掌握的高级认知技能,其本质是在信息不完整时做出基于概率的最优输出决策。
口译员采用的"预期策略"与GPT Live描述的"在语义节点智能停顿"在原理上高度相似。两者都在解决同一个信息论难题:如何在信息不完整时做出最优输出决策。AI系统的优势在于可以同时调用更大的语料库进行概率预测,且不受工作记忆容量限制,可以同时处理多个语言对,且不存在认知疲劳——一个AI口译系统理论上可以同时为会议室内使用50种语言的与会者提供服务,且不需要休息。
直播中最令人印象深刻的演示之一正是实时语音翻译。一位团队成员用中文、另一位用英文展开真实对话,ChatGPT 在双方说话的同时进行叠声双向配音翻译。模型会"在语义节点智能停顿,收集更多上下文"——这正是对经典同传难题的AI化解法:在信息歧义最小的节点输出翻译,在流畅度与准确度之间取得动态平衡。
翻译并非逐词的机械转换,而是以意义为单位进行转换,追求流畅度与语义准确,而非字面对应。值得一提的是,实时翻译只是这一通用模型的能力之一。同一个模型既可以做实时翻译,也可以进行日常对话,还能在语言学习场景中主动打断纠错——完全依据用户指令灵活切换。
核心突破二:委派机制实现"边聊边思考"
语音助手长期面临一个信任困境:智能水平往往落后于文本模型。人们不太依赖语音助手,根本原因在于它"听起来不够聪明"。
GPT Live 通过一套巧妙的架构突破了这一瓶颈——双模型协作 + 委派(delegation)机制。这一设计思路在计算机科学中有深厚根基:在面向对象编程中,委派模式允许对象将特定方法调用转发给另一个对象处理,以实现职责分离。GPT Live将这一思想移植至多模型协作场景,与混合专家模型(Mixture of Experts, MoE)、"模型路由"(Model Routing)和"级联推理"(Cascaded Inference)等研究方向高度契合,也类似于心理学家卡尼曼提出的人类大脑"双进程"理论:快速直觉系统(System 1)负责维持对话流,慢速理性系统(System 2)处理需要深度推理的复杂问题。
MoE的概念最早由Jacobs等人于1991年提出,其核心思想是训练多个"专家"子网络,并通过一个门控网络(Gating Network)决定对于特定输入激活哪些专家。谷歌2017年将其规模化至语言模型(Shazeer等人的Sparsely-Gated MoE论文),实现了在参数量大幅增加的同时保持计算量相对稳定的目标。Mistral的Mixtral系列则将稀疏MoE带入开源社区,证明了这一架构的广泛适用性。GPT Live的委派机制在MoE基础上增加了时间维度的异步性——不同于MoE在同一前向传播中并行激活专家子网络,委派机制允许两个完全独立的模型在不同时间尺度上协作:GPT Live负责实时响应(约200ms延迟敏感区间),GPT 5.5负责深度推理(可接受数秒延迟),最终将结果无缝织入对话流。这种设计与分布式系统中的「事件驱动架构」原理相通,代表了大模型系统工程设计的新方向。
在传统单体语音模型中,推理深度与响应速度之间存在根本性的取舍——更强的推理往往意味着更高的延迟,而语音对话对延迟极度敏感(通常要求200ms以内才能保持自然感)。GPT Live的创新在于将这一思路延伸至多模型异步协作:当 GPT Live 遭遇需要深度推理的复杂问题时,它会将任务委派给更强大的 GPT 5.5 并行处理,同时,自身继续与用户保持对话,确保交流不中断。这种"快慢双轨"架构有效规避了单模型在推理深度与响应速度之间的根本取舍。
直播演示中,用户一边准备关于声音历史的讲座,一边要求 ChatGPT 同步核查历史年份、查询 BART 地铁 16 街站是否延误、确认下午天气。模型同步处理多项搜索与推理任务,并自然融入对话——最终指出用户所说的"爱迪生锡箔留声机 1865 年"应更正为 1877 年。
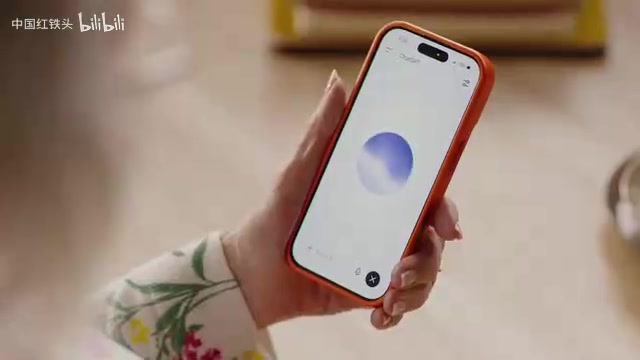
团队还透露了一个实用设计:模型内置智能等级选择器(intelligence picker)。追求极速响应可选 instant 模式;需要更深度推理时,则可切换至 medium 或 high 等级。
更自然的对话质感
除底层技术突破外,GPT Live 在对话体验细节上的进步同样显著。
直播展示了大量细节:自然的语气词、附和性的"back channel"、笑声,以及快速的来回接话。"Back channel"是来自会话语言学(Conversational Analysis)的专业术语,由语言学家Victor Yngve于1970年正式提出,指听话者在对方说话过程中发出的简短回应信号,如"嗯""对""我明白"——这些信号向说话者传递"我在听、请继续"的社交信号,是维持对话节奏与连贯性的关键元素。研究发现,back channel在不同文化和语言中呈现显著差异:日语使用者的频率远高于英语使用者,甚至韩语、芬兰语的back channel模式也各具特色,这一差异曾导致跨文化沟通中的严重误解——美国人往往认为日语母语者"不断打断谈话",而日语母语者则认为美国人"对谈话内容漠不关心"。从神经科学角度,back channel的产生被认为涉及"镜像神经元"系统——人类大脑中一类在观察他人行为时同样激活的神经元,被视为共情与社会性共鸣的生理基础。缺乏back channel正是早期AI语音助手"感觉冷漠机械"的重要原因之一。
从技术角度,生成恰当的back channel需要模型具备实时语音理解能力,并能判断当前语义单元是否完整,同时选择语调与内容匹配的回应形式——这只有在全双工架构下才能实现。这些看似微小的元素,让整个交互"更轻松、更真实"。
在语言学习演示中,模型扮演英语教练,能够主动、即时打断学习者的语法错误——例如将"I've never went"纠正为"I've never been",并解释"excited"与"exciting"的区别。这一场景涉及应用语言学中长期争论的「纠错时机」问题:克拉申(Krashen)的"输入假说"认为过度纠错会产生「语言焦虑」(Language Anxiety)并打断自然习得流程,而行为主义传统则认为错误表达若不及时纠正会导致「石化」(Fossilization)——即错误表达形式被永久固化为学习者的语言系统组成部分,极难纠正。GPT Live能够根据指令灵活调整纠错策略,意味着它可以针对不同学习者实现个性化的干预强度——这体现出模型并非被动等待用户说完,而是"主动倾听、实时判断并及时介入"。
自然笑声与语气词的生成则涉及情感语音合成(Emotional TTS)领域——这是语音AI中最具挑战性的方向之一。深度学习时代的WaveNet(DeepMind,2016年)和Tacotron(Google,2017年)开创了端到端神经TTS架构,解决了音质问题,但情感真实性成为新的瓶颈。自然笑声的合成尤其困难,因为笑声涉及高度非线性的声道动态——笑声与语音在生理上由不同的肌群控制,且在社交语境中对「时机感」极度敏感。错误时机的笑声会引发强烈的「恐怖谷」效应(Uncanny Valley)——这一现象由日本机器人学家森政弘(Masahiro Mori)于1970年提出,描述当人形机器人或AI的拟人程度接近但未完全达到真实人类时,观察者产生的强烈不适感,形似一个"谷底"。有趣的是,恐怖谷效应在运动的类人体上比静止的类人体上更为强烈,这与语音AI的动态特性高度相关。GPT Live生成自然笑声的能力意味着其自然度可能已跨越恐怖谷的另一侧,进入「可被接受为类人」的高自然度区间。这同时也引发了新的伦理思考:当AI语音无法与人类区分时,如何保障用户的知情权?
一位团队成员分享道,最让他惊讶的是模型整体的"时机感与情感表达"——自然到某个瞬间,你会真的忘记对面是一个 AI。这正是图灵测试最通俗化的表达,也是团队将此次发布称为"图灵时刻"的根本原因。
安全性与未来展望
团队强调,安全性从模型训练第一天起就是首要优先级。随着模型自然度与智能水平的持续提升,当AI语音变得难以与人类区分时,语音欺诈(Voice Phishing)、深度伪造(Deepfake Audio)等风险也随之上升。OpenAI 表示将持续加强安全防护机制,包括在必要时引导对话远离敏感或风险话题。这一承诺背后是语音AI领域安全研究的紧迫性:2023年多起利用合成语音实施诈骗的案例——包括利用合成子女声音向父母索要紧急汇款的"虚拟绑架"骗局——已引发美国联邦贸易委员会(FTC)等监管机构对实时语音合成技术的密切关注,部分国家已开始讨论强制要求AI生成音频添加数字水印的立法。
在收尾环节,Kundan 表示:这个模型"让我们离真正可访问的 AGI 更近了一步——一个与 AI 对话终于开始感觉像真实对话的世界"。
从命令到对话:人机交互范式的转变
GPT Live 的意义不止于技术参数,更在于它对人机交互范式的重新定义:从需要"轮流发言"的半双工命令模式,走向"同时听说"的全双工自然对话;再借助委派机制引入顶级模型的推理深度,语音交互正在成为一种真正低门槛、高智能的入口。这一转变意味着AI评价标准正在从"功能完成率"迁移向"交互自然度"——而后者,才是普通用户真正感知到的智能边界。
该模型已于发布当天开始在 ChatGPT 中向用户推出。至于它能激发出多少此前难以想象的应用场景,正如团队所说——他们"才刚刚触及表面"。
核心要点
相关推荐

34款AI编程助手混战终端,如何避免选错?
34款AI编程助手涌入终端,Orca工具支持多代理并行。本文分析淘金热背后的整合趋势、多代理并行的成本陷阱,以及如何保持代理中立的工作流,避免选错工具。

Gemini CLI实战:终端里的AI编程Agent
深入解析Gemini CLI:从安装认证到实战构建任务管理应用,涵盖计划模式、自动调试、GEMINI.md上下文持久化与token成本统计,帮助开发者用终端AI Agent提升编码效率。

Open Design:免费开源版Claude Design,激活你的编程智能体
Open Design 是一款免费开源的 Claude Design 替代品,本地运行,内置 250+ 设计技能,自动检测 16 种编程智能体,支持原型、幻灯片、移动端界面等设计任务。