GPT Live全双工语音:AI如何学会倾听与对话节奏

从对讲机到真人对话
OpenAI最新发布的GPT Live,表面上只是ChatGPT语音功能的一次升级——它说话更自然,会在你停顿时耐心等待,也会在你还没说完时用轻微的反馈告诉你"我还在听"。但这次升级的意义远不止"声音更像真人"那么简单,它更像是OpenAI在重新定义我们使用AI的方式。
过去我们和AI交流主要靠输入框:先把需求整理成提示词发出去,等模型生成答案,不满意再补一句。这个流程很强大,但本质上仍是在"提交请求"。而现实生活中的需求往往不是一句完整指令——你可能一边做饭一边问下一步,也可能通勤路上突然想查信息,或者面试完只想把过程说出来让AI帮你复盘。在这些场景里,键盘不是最自然的入口,语音才是。
问题在于,过去的AI语音并不好用。它听起来像在聊天,实际体验却更像对讲机:你说完一段它停一下再回复,你稍微卡壳它就以为你讲完直接插话,旁边有噪音还可能误判。结果是用户在适应机器的节奏,而不是反过来。
全双工架构:同时听和说
要理解GPT Live的突破,需要回顾ChatGPT语音的技术演进。早期版本的底层逻辑是把三个系统串起来:先把声音转成文字,再让大语言模型根据文字生成回答,最后转成语音播出。这套**级联架构(Cascaded Architecture)**能跑通,但损耗很大。
级联架构在语音AI领域存在了数十年,其核心问题是信息在管道传递过程中的逐级损耗。**自动语音识别(ASR,Automatic Speech Recognition)**系统在将音频转为文字时,会丢失音调变化、语速波动、情感色彩等副语言信息;大语言模型在处理文本时无法感知这些维度;**文字转语音(TTS,Text-to-Speech)**系统则需要重新"猜测"合适的语调来合成输出。这种损耗的累积效应使得你的语气、停顿、犹豫和情绪,在第一步转文字时就已经被压平了——模型拿到的不是一个"正在表达的人",而是一句被整理过的文本。
相比之下,端到端语音模型(End-to-End Model)直接对音频特征建模,将语音理解与生成统一在同一个神经网络内,使模型能够直接从音频波形中学习语义、情感和韵律的联合表示,从而保留了更丰富的副语言信息(Paralinguistic Cues),这也是为什么Advanced Voice Mode相比早期版本在情感感知上表现更自然的根本原因。端到端架构的核心突破在于消除了模态转换的中间层损耗:传统级联系统中,每次"音频→文本→音频"的转换都是一次有损压缩,而端到端模型将整个感知-生成过程压缩在统一的特征空间中,就像人类大脑处理语音时并不会先将声音"翻译"成文字再思考,而是直接在语音-语义的联合空间中进行理解。
后来的Advanced Voice Mode把语音理解和生成放进同一个模型,延迟明显降低,声音也更自然,但它仍然主要依赖"轮次判断"——系统要先判断你是不是说完了才决定该不该开口。这一判断机制在工程上被称为语音活动检测(Voice Activity Detection,VAD),传统方法主要依赖能量阈值和静音时长:超过一定时间的静默即视为发言结束。这种方法在干净录音环境下尚可接受,但在真实对话中极易误判——思考中的停顿、寻找词汇的犹豫、环境噪音的短暂消失,都可能触发错误的"轮次切换"。更先进的方法引入语义完整性判断,通过语言模型预测当前句子是否已构成完整表达。VAD技术的发展史折射出语音AI的核心矛盾:对静默的判断既不能太激进(打断用户思考),也不能太保守(造成明显延迟),而"正确的等待时长"实际上是高度语境依赖的——同一个三秒停顿,在讲故事和在回答是非题中意味着完全不同的状态。
GPT Live的关键变化是全双工架构:它可以同时听和说。**全双工(Full-Duplex)是通信工程中的经典概念,指通信双方可以同时进行双向数据传输,无需像半双工(Half-Duplex)那样轮流占用信道——电话网络自20世纪初就采用这一设计。将全双工引入AI语音交互的难点不在于硬件,而在于模型层面的实时决策,以及一个容易被忽视的工程挑战:系统自身播放的声音不能被麦克风拾取后误判为用户输入,这需要精确的声学回声消除(Acoustic Echo Cancellation,AEC)**和信号处理算法协同工作——这一技术在电话会议系统中已有成熟应用,但在AI语音场景中还需要与语义理解层紧密配合,才能区分"用户在回应AI的话"和"麦克风拾取到了扬声器的声音"。这也解释了为什么早期AI语音系统普遍采用半双工设计——回声消除问题的工程复杂度远超表面看起来的程度。
GPT Live不是等你彻底讲完才处理,而是在生成语音的同时持续接收你的声音,综合音频特征、语义状态和上下文历史不断判断当前的互动状态——你是在思考还是已经结束,它该继续听还是轻轻回应,如果你突然插话它是否应该立刻停下来。

落到体验上就是一句话:AI开始学习真正的对话节奏。真正自然的交流不是两个人轮流朗读,我们平时聊天有很多细小动作在维持沟通——对方点头、轻轻"嗯"一声、在你找词时不催促。过去语音AI缺的不是发声能力,而是这种细腻的实时感。所以GPT Live的进步不只是"说话更顺",而是更懂得什么时候不要说话。
语音承接ChatGPT的完整能力
这个能力最容易展示的场景是实时翻译。传统翻译工具通常要先录一句、等系统处理、再播出译文。**同声传译(Simultaneous Interpretation)**是人类认知能力的极限挑战之一,要求译员在听取源语言的同时实时产出目标语言,通常滞后2-5秒。职业译员依赖两种核心策略:一是"暂存"(Buffering),将尚未翻译的内容保留在工作记忆;二是"语义预判"(Anticipation),根据源语言的句法结构预测后续词语,从而提前启动翻译。不同语系的句法结构差异(如日语和德语的谓语后置)会对这两种策略造成不同程度的认知负担,这也是专业同声传译培训需要数年的核心原因之一。GPT Live的持续音频流理解机制在功能上类似于这种预判策略,但可以利用更大的上下文窗口和知识库辅助预测——你还没完全结束它已经在跟上语意,对方突然插话它也能调整节奏。翻译从"轮流播报"变成了更接近真实通话的体验。值得注意的是,AI在处理专业术语、文化语境和高度即兴的口语表达时仍有局限,专业同声传译在高风险场合(外交、医疗谈判)的不可替代性短期内不会消失,但门槛较低的日常跨语言沟通场景确实面临实质性冲击,这也是外界调侃"同声传译面临冲击"的真正背景。
但翻译只是入口,更大的变化是语音开始承接ChatGPT的完整能力。以前很多语音模式像是缩水版ChatGPT,复杂任务还是要回到文字界面。现在搜索、记忆、图片识别、文件上传和可视化卡片都可以进入Voice:你问天气、股票或比赛结果,屏幕上会出现卡片;你让它参考文件、理解图片,也可以在语音对话里完成。语音不再只是把文字念出来,而是在变成ChatGPT的一个主入口。
前台交互与后台推理的分离
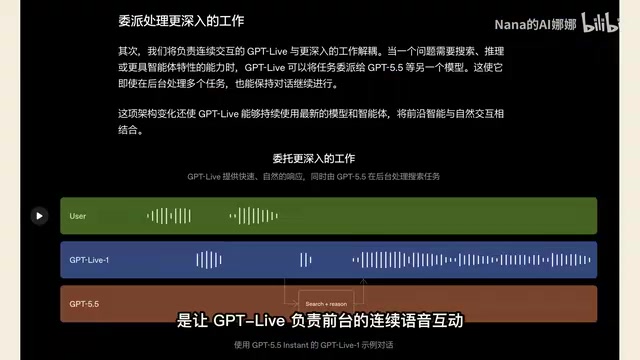
GPT Live还有一个重要的架构变化:前台交互和后台推理被拆开了。过去大家总希望一个模型什么都能做——既反应快又能深入思考,既像朋友一样马上接话又像研究员一样查资料。但这两个目标天然冲突:语音交互要求低延迟,复杂任务却需要时间。
OpenAI这次的做法是让GPT Live负责前台的连续语音互动,简单问题直接回答;如果问题需要搜索、推理或更强的agent能力,就把任务交给后台模型处理。这本质上是一种计算资源的动态调度策略,与互联网工程领域的**微服务架构(Microservices Architecture)**高度同构:轻量级前台模型如同API网关(API Gateway),负责低延迟的请求路由、状态维持和用户反馈;重量级后台模型则专注于深度推理,按需异步调用。这种解耦设计的关键优势是可独立迭代——前台针对自然对话优化,后台模型则可以随着新版本发布不断替换,而无需重构用户感知层。微服务架构在互联网行业的普及(Netflix、亚马逊等公司自2010年代起大规模采用)揭示了一个普遍规律:将低延迟响应层与高计算密度处理层分离,不仅能提升系统整体性能,还能大幅降低迭代成本——每个服务可独立部署、独立扩容,故障隔离也更为精确。将这一思路引入AI交互系统,是工程实践积累向AI产品设计的自然迁移。
发布时后台调用的是GPT 5.5,用户还可以选择不同推理强度:快速问题用Instant,复杂问题用Medium或High。前台模型还需要承担**上下文持久化(Context Persistence)**的职责——用户在等待复杂任务完成时的追问、补充条件等交互,必须被准确整合进最终结果的生成过程中,确保后台异步返回的结果能无缝融入正在进行的语音对话流,而非造成突兀的"加载感"。上下文持久化在多轮对话系统中是一个非平凡的工程问题:前台模型需要维护一个"对话状态机",记录哪些信息已被后台接收、哪些追问尚未得到响应、用户是否修改了原始需求——任何状态丢失都可能导致后台返回的结果与用户当前预期不符,形成令人困惑的对话断层。
这套设计解决的是语音场景里一个很现实的问题:用户不喜欢等待,但复杂任务一定需要时间。在文字界面里等几秒还能接受,因为你看得到加载状态;但语音里的沉默会让人不舒服——就像打电话时对方突然安静十几秒,你会怀疑是不是断线了。GPT Live的前台模型可以在后台任务进行时继续和你互动,必要时追问条件,或用自然方式解释它正在处理什么,等后台结果完成再把答案接回对话。这类交互不再像一次请求,而像一段持续协作。
安全边界:越自然越需要克制
所以GPT Live真正挑战的不只是Siri这类传统语音助手。传统助手更偏命令式——设闹钟、放音乐、查天气,问题一复杂就退回搜索结果或模板回答。GPT Live的方向是把自然语音、搜索、记忆、文件理解、视觉卡片和前沿模型连接起来,让语音入口从"快捷操作"变成"工作界面"。OpenAI强调每周已有超过1.5亿人在使用ChatGPT的Voice和Dictation,说明语音并非边缘功能。
但越像人的AI越需要边界。文字说"我在听"和一个自然声音在耳边说"嗯,我听着呢",心理效果完全不同。这种差异的根源在于人类沟通中的副语言信号(Paralinguistic Signals)——语调、语速、停顿、叹息等超越词语内容本身的信息层。心理学研究(可追溯至梅拉比安在20世纪60年代的经典工作)表明,当AI系统能够模拟这些信号,会触发人类大脑中与社交互动相关的神经机制,产生"被理解"和"被倾听"的感知,甚至激活与真实社交互动类似的多巴胺响应。值得关注的是,梅拉比安的原始研究结论——"沟通中55%来自肢体语言,38%来自语调,仅7%来自词语内容"——在学界存在相当争议,其适用范围被严重过度引用。但核心洞察仍然成立:语调和副语言信号在情感沟通中的权重显著高于词语本身,这一点在神经科学层面有充分的后续研究支撑。
这一现象在人机交互研究中被称为拟社会互动(Parasocial Interaction),原本由霍顿与沃尔(Horton & Wohl)于1956年提出,用于描述观众对电视明星的单向情感依附——当AI语音足够自然时,这种效应会显著增强,用户可能在不自知的情况下建立超出合理范围的情感依赖。拟社会互动在流媒体时代已被广泛记录:粉丝对YouTube博主或播客主播产生类似真实友谊的情感连接,并在对方"消失"时产生真实的悲伤反应。AI语音交互将这一效应推向了新的层次——不同于电视明星的单向广播,AI能够实时回应、记住你的偏好、适应你的情绪,这使得拟社会关系的形成速度和深度都可能远超传统媒体场景。当模型懂得等待、附和、安慰,人很容易把这种体验理解成一种关系。
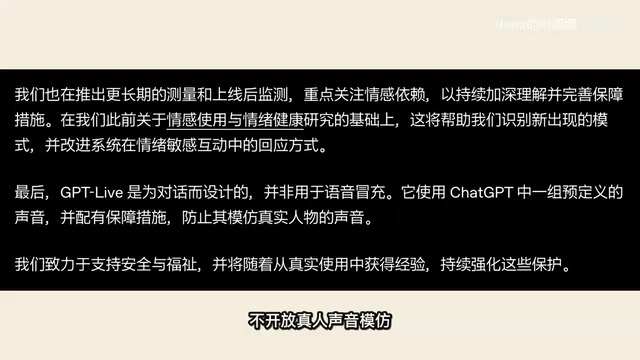
为此OpenAI做了明确限制:GPT Live只使用预设音色,不开放真人声音模仿,以降低**声音克隆(Voice Cloning)**和诈骗风险。声音克隆技术经历了从统计参数合成到深度学习的代际跃迁,2023年微软研究院发布的VALL-E模型仅需3秒音频样本即可生成目标人声,后续研究进一步将所需样本压缩至1秒以下。这一能力的普及带来了深刻的安全隐患:语音作为身份认证因素正在失效,电信诈骗中的"AI换声"案例已在全球多国造成大规模经济损失,国际刑警组织和多国网络安全机构已将此列为新兴高风险威胁。限制预设音色是对这一风险的主动防御,避免平台本身成为声音克隆的工具或跳板。从更宏观的技术伦理视角看,声音克隆问题折射出深度伪造(Deepfake)技术的普遍困境:生成能力的民主化速度远超检测能力和法律监管的响应速度,在监管框架完善之前,平台层面的主动限制是目前可行的主要防线之一。此外,针对语音场景做了专门的安全评估,用合成音频模拟高风险情况;对话中若出现危险内容,系统会转向安全方向,严重时中断语音并提供危机干预资源;面向未成年人也有家长控制。
这里也要保持清醒:自然不等于可靠。GPT Live让对话变顺了,但它仍然是模型,能调用搜索和推理不代表每个回答都正确。语音甚至可能让人更容易放松警惕——当一个系统说得流畅、声音自然,我们会本能地觉得它更可信。认知心理学中的**流畅性效应(Processing Fluency Effect)**已有大量实验证据:信息呈现越流畅(易读、易听、表达清晰),人们越倾向于将其判断为真实可信,无论内容本身是否经过核实。语音AI的自然度提升恰好放大了这一效应——流畅的语音比生硬的机器声更容易触发信任感,而这种信任感与信息准确性之间并无必然关联。医学、法律、金融和重大决策仍然需要独立核验。语音降低了使用门槛,也可能同步降低了怀疑的门槛。
语音作为可持续升级的前台
从产品角度看,GPT Live透露了OpenAI的长期方向:它不是把语音做成独立模块,而是做成一个可以持续升级的前台。前台负责交互,后台模型可以随着新模型发布不断替换。今天你感受到的是更自然的对话,明天后台变强后,同一个语音入口就能承担更复杂的任务。
这很像操作系统的逻辑:用户看到的是一个入口、一个按钮、一个通话界面,但背后接入的能力会持续进化。计算机交互历史上的每次范式跃迁都遵循同一规律:新交互方式降低使用门槛,扩大潜在用户规模,并重新定义平台控制权的边界。命令行界面将计算机使用权限定在专业工程师群体;图形用户界面(GUI)的普及(以1984年Macintosh为标志)使得非技术用户得以进入,微软借助Windows建立了长达二十年的桌面垄断;触屏交互(以2007年iPhone为标志)重新分配了应用分发权(App Store模式)和用户数据控制权。每次范式跃迁背后都存在一个关键机制:新入口的设计者获得了对整个生态的结构性控制权。命令行时代,Unix许可证控制了计算能力的分发;GUI时代,操作系统厂商通过API标准掌握了软件生态的准入规则;移动时代,应用商店成为开发者与用户之间的必经通道,平台以30%抽成为代价换取流量分发权。语音AI入口若成为下一代主流交互层,同样的权力结构将在AI时代重演——谁定义了对话界面的规则,谁就掌握了AI能力向用户分发的"最后一公里"。
语音作为AI时代的新入口,战略价值不在于功能本身,而在于它将成为用户与AI能力之间最自然、最高频的连接层——"谁控制了对话界面,谁就控制了用户与AI能力之间的通道"。这也解释了为什么苹果、谷歌、Meta和亚马逊都在加速布局各自的语音AI入口——这不仅是功能竞争,更是下一代人机交互操作系统的卡位之战。
如果这个方向成立,很多应用都会被重新改写——教育场景里AI能陪你练口语、模拟面试,并根据你说话时的卡顿判断你真正没听懂的地方;客服场景里语音agent能在多轮对话中理解问题、确认条件、调用后台系统;办公场景里你只需说一句"帮我看这份文件抓出风险点"。
当然,GPT Live首发阶段还不支持屏幕共享和视频对话,部分语言的表现也需继续优化。纯语音仍然缺少很多视觉上下文——人面对面时的判断很多来自表情、眼神和动作。未来如果语音、视频、屏幕理解和环境感知继续融合,AI的交互才会更加完整。
从回答问题到持续协作
这次GPT Live最重要的变化不在某个演示多惊艳,而在于它把AI从"回答问题"推向了"持续协作"。文本框时代,人需要先把需求整理成提示词;语音时代,AI开始适应人的表达节奏,听懂停顿和犹豫,判断何时回应,再把复杂任务交给后台处理。很多临时、模糊甚至还没想清楚的需求,都可以在对话中逐渐说清楚。
鼠标普及了图形界面,触屏推动了移动互联网,GPT Live往前推进的是一个更接近"通话"的AI入口。未来使用AI可能不再需要先打开窗口、组织提示词——只要把想法直接说出来,协作就已经开始了。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。