GPT-Next神秘模型泄露:OpenAI启动28天冲刺,Gemini 4 Argon临近

OpenAI、Google、Anthropic三强暗战:新模型泄露、28天冲刺承诺与订阅性价比大洗牌。
近期AI三巨头虽无重磅发布,但竞争暗流涌动。OpenAI泄露出神秘高效新模型GPT-Next,并启动28天产品冲刺承诺,首日已将主力模型推理速度提升约50%,背后是Anthropic在订阅性价比上的直接施压。SemiAnalysis报告显示,同等价格下Anthropic订阅的API等价价值约为OpenAI的5倍。Google方面,Gemini 4 Argon后端迭代迹象密集,图像模型Nano Banana 2.1正式上线,同时RSI(递归自我改进)相关占位符的出现为其快速迭代能力提供了一种解释框架。开源层面,Reflection AI发布5010亿参数MoE架构模型Beam。整体来看,竞争焦点正从单纯能力比拼,转向效率、成本与实际使用体验的综合较量。
近期AI领域虽无惊天动地的发布,但OpenAI、Google和Anthropic三大阵营的暗流涌动,透露出下一轮竞争的方向。从神秘的GPT-Next模型泄露,到OpenAI的28天冲刺承诺,再到订阅价值的重新洗牌,这些碎片化信息拼凑出一幅颇具看点的行业图景。
神秘的GPT-Next模型浮出水面
目前OpenAI最大的谜团来自一个鲜为人知的新模型——GPT-Next。它既不是所谓的GPT-Minor,也不是已被放弃的GPT-6.1 Astra,而是一个与GPT-6.1 Sol高度相似、或许略有提升但没有重大改进的版本。
这个模型是在生成一段相当出色的体素(voxel)风格Pokémon作品后被发现的。从早期输出来看,它在3D环境构建和Web开发任务上的表现确实比GPT-6.1 Sol更进一步——能够处理带有光影、着色器、功能组件的3D厨房环境,甚至加入了不同宝可梦的动画角色。虽然创意和执行力只是边际提升,但细节的丰富程度值得关注。
真正引人瞩目的是价格传闻。据早期估算,约4万credits可能产生了接近50亿tokens的使用量(含缓存tokens)。如果数据属实,这个新checkpoint的效率将极为惊人,可能暗示它是一款针对成本优化的高效模型。不过UP主也提醒,单个体素测试和零散的价格估算不宜过度解读。
OpenAI的28天冲刺承诺
OpenAI产品负责人Tibo发起了一项"28天发货承诺":接下来的28天内,团队要么每天为Codex和工作流用户交付一项有意义的改进,要么给所有人一次完整的额度重置。这对用户而言是双赢。
团队目前聚焦四件事:简化产品、提升效率(让用户获得更多使用量)、推出突破性功能、发布新模型。第一天就已兑现——GPT-6 Astra和GPT-6.1 Sol的默认速度提升了约50%,目标从每秒30 tokens提升到约50 tokens,这一改进同样适用于通过"Sign-in with ChatGPT"接入的服务,包括OpenCode、Pi、AMP、Devin等。
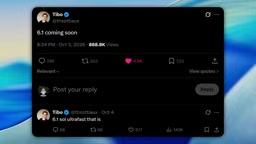
视频作者推测,这项挑战期间OpenAI很可能会投放另一款重磅模型,大概率是比Astra更便宜、更高效的版本,这也与GPT-Next的出现相互印证。此前Tibo在X上含糊地提到"6.1正在到来",后来澄清指的是"6.1 Sol Ultra Fast",而非已被砍掉的6.1 Astra。背后的直接压力来自Anthropic——其新模型在效率和使用额度上对OpenAI形成了明显冲击。
Gemini 4 Argon与Nano Banana 2.1的进展
Google这边,Gemini 4 Argon的发布似乎比预期更快。其后端日志中迅速出现了大量与Argon相关的内部模型slug,包括多个LSP、barium checkpoints以及实验性变体。这种快速迭代、带有bug修复和多配置测试的迹象,说明Google在积极打磨而非停留在早期原型。在一项SVG模拟测试(生成支付卡交易完成动画)中,Gemini 4 Argon甚至击败了Fable 5。
图像生成方面,Nano Banana 2.1已登陆Gemini网页版和移动端。它的命名历程相当混乱:从六月的"instant ramen"(被认为是Nano Banana 2 lite),到八月的version 2,再更名为"spicy mayo",九月通过Vertex以"Nano Banana 2.5"提供给合作伙伴,最终Google将其从"light"重新归类为"flash"并命名为2.1。在与腾讯混元HY Image 3.5的对比测试中,Nano Banana 2.1在角色一致性上更好,但HY Image 3.5在光影、氛围和创意表现上更胜一筹,且价格更低(约每2张2K图2美分)。总体而言,早期表现尚算稳健但未到惊艳。
Google的RSI传闻再添疑点
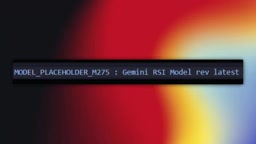
关于Google所谓的RSI(递归自我改进,Recursive Self-Improvement),此前被认为是不实传言,但后端日志中又发现了一个神秘的内部模型占位符,为"Google正在实验RSI"的猜测添了一把火。这或许能解释Google为何能如此快速地开发出众多flash变体。
不过作者保持谨慎——单一的模型slug或占位符不足以证明Google已经攻克RSI,它可能只是一个命名,或某种模仿性框架。但结合近期Google密集的模型活动,这确实为整个拼图增添了一块耐人寻味的碎片。
递归自我改进(Recursive Self-Improvement,RSI)是AI安全领域的一个核心概念,指AI系统能够自主修改、优化自身的算法或权重,从而在无需人类干预的情况下持续提升性能。理论上,一旦AI达到足够高的初始能力阈值,RSI可能触发"智能爆炸"——每一轮自我改进都使下一轮改进变得更容易,形成正反馈循环。这也是部分AI研究者将其视为潜在存在风险的原因之一。
在工程实践层面,RSI与当前主流的RLHF(基于人类反馈的强化学习)和模型蒸馏技术存在本质区别:后两者仍依赖人类提供反馈信号或教师模型,而RSI强调系统自主生成改进方向。如果Google确实在实验某种形式的RSI框架,即便是受限版本(如让模型参与设计自身的训练数据或评估标准),也将是一个具有重大意义的技术路线转变,足以解释其近期模型迭代速度异常加快的现象。
订阅价值大洗牌:Anthropic碾压OpenAI
SemiAnalysis发布的一份报告测试了几乎所有主流AI订阅的使用额度,结论相当惊人:在高负载的agentic工作流中,Anthropic订阅的性价比显著高于OpenAI,且差距不小。
据其分析,在同等价格下,Opus 5.5提供的API等价价值约为GPT-6.1 Sol的5倍;即便对比中端模型,Anthropic订阅也能提供超过5倍的API等价价值。报告还指出OpenAI近期将200美元ChatGPT方案的使用额度砍掉了约一半,理由是GPT-6.1 Sol更高效(也被视为IPO前的动作)。唯一的例外在高端:Pro和Max 20x方案下,OpenAI给出的GPT-6 Astra额度略高于Anthropic的对应模型。
具体数字上,CloudMax约给出1.25万美元的Sonnet、约1.2万美元的Opus(或2.5千Fable)的API等价用量;而ChatGPT Pro约为2千GPT-6.1 Sol或3千GPT-6 Astra。作者也公允地指出,API等价成本只讲了一半故事——模型质量、速度、上下文长度、工具集成和生态实用性同样关键,"5倍的额度"不等于"5倍的实际价值"。
"API等价价值"是SemiAnalysis报告所用的比较框架:将订阅套餐内可用的模型算力,按该模型在公开API市场的按量计费价格折算为等价美元数。例如,若某订阅每月可调用价值1万美元API用量的Sonnet,则其API等价价值为1万美元。这一指标直观反映了订阅套餐相对于按量付费的"折扣深度",对重度agentic工作流用户尤其有参考意义,因为此类场景的token消耗往往极大。
但这一指标存在明显局限:它假设用户能够完全"用满"额度,而实际上不同平台的速率限制、上下文窗口、工具调用支持和工作流兼容性都会影响实际可用量。此外,模型单价反映的是市场定价策略,不必然等于用户产出的实际业务价值,因此作者特别强调"5倍额度≠5倍实际价值"这一判断。
水印、开源模型与工具更新
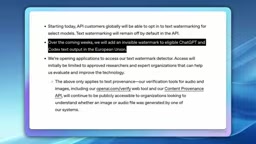
OpenAI正为应对欧盟AI法案推出文本水印系统TextScreen。它不插入可见标记,而是在模型用词选择中嵌入统计信号供后续检测。据OpenAI测试,TextScreen在不明显降低输出质量的前提下,匹配甚至超越了Google的SynthID for Text,且计划开源。全球API客户现已可在部分模型上选择启用。局限性也被承认——文本可被改写、翻译或修改。
美国新AI实验室Reflection AI发布了开源模型Beam,总参数约5010亿,激活参数仅230亿,采用MoE架构以提升推理效率。Beam专为推理、编码和agentic工作流设计,从零端到端训练而非基于现有开源模型,权重将于本月向所有人开放。
工具层面,Google在Anti-gravity中为Pro订阅者新增了Opus 5.5 Medium和Sonic 5.5 Medium(但额度极为有限);Claude Code新增了mod功能,其中"cache control"插件可显示5分钟提示缓存窗口并提醒保持缓存"温热",有效节省tokens、延长会话时长;Claude Projects则新增了直连本地文件夹的能力。此外,有用户用一句prompt让Fable 5.5在约一小时内生成了融合Pokémon与Balatro的完整游戏,含机制、视觉、音乐和演示视频,表现相当惊艳——该模型甚至可能近期就会发布。
MoE(Mixture of Experts,专家混合)架构是近年来大模型扩展的主流方案之一。其核心思想是将模型拆分为多个"专家"子网络,在推理时由一个门控机制(Router)动态选择激活其中少数几个专家处理当前输入,而非像密集模型那样激活全部参数。Beam的5010亿总参数中仅激活230亿,意味着每次推理的实际计算量远低于同等参数规模的密集模型,从而在保持高模型容量的同时大幅降低推理成本和延迟。
GPT-4和Mixtral都被广泛认为采用了类似架构。MoE的主要挑战在于训练稳定性(不同专家容易负载不均)和通信开销(分布式训练时专家间数据路由复杂),因此"从零端到端训练"对Reflection AI而言技术门槛颇高,也是其着重强调这一点的原因。
结语
这一轮更新没有爆炸性的大模型发布,但从GPT-Next的泄露、OpenAI的28天承诺,到Anthropic在性价比上的压制,三大阵营的竞争正从单纯的能力比拼转向效率、成本与使用体验的综合较量。对普通用户而言,谁能在同等价格下提供更多实际可用的算力,正成为越来越重要的选择标准。
相关推荐
LZ4:极速压缩算法的开源标杆
探索 LZ4 极速压缩算法:了解其设计哲学、性能优势以及在 Linux 内核、数据库等领域的广泛应用。12k+ Star 的开源项目如何成为速度标杆。
Agent-Browser:AI智能体的浏览器自动化CLI
Vercel Labs 开源 agent-browser,一个用 Rust 构建、专为 AI 智能体设计的浏览器自动化 CLI 工具,GitHub 星标超 4.5 万,提供命令行优先的浏览器操控能力。
全球首家人形机器人公司Agility登陆纳斯达克,买不买?
Agility以全球首家人形机器人上市公司身份登陆纳斯达克,本文分析这一标志性事件对行业与投资者的意义,拆解纯人形机器人赛道的商业化考题与投资判断框架。