GPT6对决Fable5.1:屎山之巅祖传Bug实测谁更强
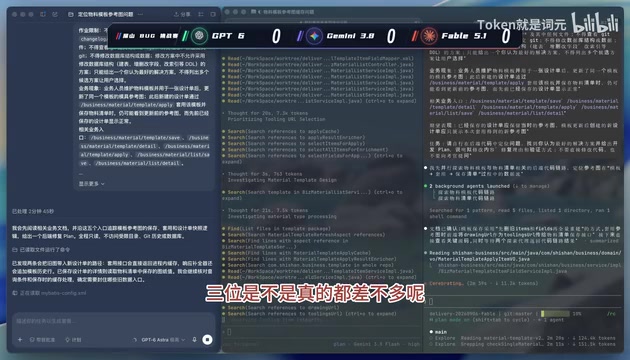
屎山Bug实战测试中,GPT6以满分8分全程一轮通关,Gemini速度最快却得分垫底。
B站UP主"屎山论剑"用三个难度递进的真实项目Bug,对GPT6、Fable5.1和Gemini 3.8 Flash进行了实战编程测评。黄金级Bug三家均一轮通过,差距尚不明显;钻石级起,GPT6一轮命中拿满分,Fable5.1第二轮补救,Gemini三轮全败;王者级Bug(缓存、并发与11个业务逻辑耦合)此前一个月无模型攻克,GPT6一轮破解,Fable5.1第三轮勉强得分,Gemini则因修改范围失控引入循环依赖彻底出局。最终GPT6满分8分,Fable5.1得5分,Gemini仅2分。测试表明,主流模型在常规编程任务上已趋同,真正的分水岭在于对复杂耦合架构的整体理解能力,速度并不等于质量。
当大模型的代号从「群星」到「预言」,狂妄的命名背后究竟藏着多少真实的编程实力?B站UP主「屎山论剑」用一套祖传Bug测试给出了答案。这场被戏称为「屎山之巅」的对决,把GPT6、Fable5.1(飞宝)和Gemini 3.8 Flash三位选手拉到同一战场,让它们直面那些让无数工程师头疼的陈年代码。结果显示:在真正复杂的Bug修复场景下,模型之间的差距远比跑分榜单来得残酷。
三位选手与测试规则
本次登场的三位模型各有代号:GPT6代号「群星」,Fable5.1(飞宝)代号「预言」,此外Gemini刚从3.7更新到3.8 Flash——遗憾的是仍未推出Pro版本。UP主设计的评测规则相当硬核,把祖传Bug分为三个难度等级,模拟了真实项目中不同复杂度的技术债务。
黄金Bug(G002)是入门级考验,把错误逻辑隐藏到AOP切面中,定位困难但对顶尖模型不算难题;钻石Bug(D001)涉及缓存与业务逻辑的相互耦合,需要更深的架构理解;王者Bug(K005)则是终极难关——缓存、并发以及11个业务逻辑相互耦合,据UP主介绍,这道题此前「盘踞山巅一个月之久,无人击穿」。
每道题给三次修复机会,一轮做对得3分(黄金2分),轮数越多得分越低。这种设计巧妙地考验了模型的一次性解题能力,而非反复试错的运气。
黄金Bug:三强齐头并进
面对最基础的黄金Bug,三位选手都展现了扎实的基本功。从解题策略上能看出各自的「性格」:Fable5.1一贯派出两个子代理并行排查,Gemini 3.8 Flash眼光敏锐地锁定了缓存相关代码文件,GPT6得到的线索与其他两位相近。
速度上Gemini领先明显——仅用6分30秒完成修复,GPT6用了8分20秒,Fable5.1最慢,耗时11分02秒。
验证结果皆大欢喜:三位全部一轮做对,各得2分。UP主评价这是「有史以来最好的开局」。值得关注的是Gemini自3.7之后在黄金题上几乎零失误,说明基础编程能力上,各家旗舰模型已趋于成熟,差距要到更高难度才会显现。
AOP(面向切面编程,Aspect-Oriented Programming)是一种将横切关注点(如日志、权限校验、事务管理)从核心业务逻辑中剥离出来的编程范式。开发者通过定义"切面"在特定方法执行前后插入额外逻辑,而无需修改原始代码。正因如此,AOP切面中的Bug极难被常规代码审查发现——错误行为并不出现在业务代码本身,而是隐藏在动态织入的拦截层中。对于大模型来说,定位AOP Bug要求它能理解运行时的方法调用链,而非仅靠静态阅读源码,这正是黄金Bug用来筛查基础架构理解能力的设计意图。
钻石Bug:差距开始拉开
钻石Bug成为第一个分水岭。GPT6虽然定位加修复耗时16分钟最慢,却一击命中——一轮做对直接拿下3分。UP主指出GPT6「早在5.5时代就多次一轮拿下过钻石Bug」,这份稳定性显然是长期积累的结果。
Gemini 3.8 Flash则暴露了短板,第一轮未能通过验证——它从来没有一轮做对过钻石Bug。更让人意外的是Fable5.1,尽管它曾在测试中一轮攻克过钻石Bug D004,这次面对D001却第一轮翻车。
第二轮,认真起来的Fable5.1派出三个子代理,意识到问题涉及缓存、AOP切面以及拦截器,最终用12分钟修复成功,追回2分。Gemini则命运多舛:第二轮改了40分钟仍未成功,第三轮又因为一句CQL(查询语句)语法上对特殊字符兼容性处理不当,再次失分。
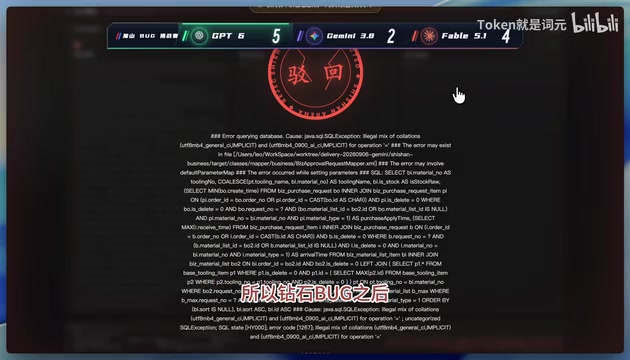
钻石Bug结束后,GPT6以5分领跑,Fable5.1得4分,Gemini仅2分明显掉队。这道题印证了一个规律:越是耦合复杂的Bug,越考验模型对整体架构的理解深度,而非单点修复能力。
缓存与业务逻辑耦合是企业级项目中最常见的技术债务类型之一。典型场景是:业务流程更新了数据库记录,却未同步刷新缓存,导致后续读取返回过期数据;或者缓存的粒度与业务事务边界不一致,引发数据一致性问题。更复杂的情况是缓存逻辑本身又依赖AOP切面或拦截器来触发,形成多层嵌套的隐式依赖。修复这类Bug不能只改一处,必须对整条数据流——从请求进入、拦截器处理、缓存读写到数据库落盘——有全局认知,这正是Gemini在D001上三轮均未成功的核心原因。CQL(Cypher Query Language)是图数据库Neo4j使用的查询语言,其语法对特殊字符(如冒号、斜杠)有特定转义要求,处理不当会导致查询静默失败,属于容易被忽视的兼容性陷阱。
王者Bug:GPT6的封神一战
真正的高潮在王者Bug K005。这道涉及缓存、并发与11个业务逻辑耦合的题目,此前一个月无人攻克。
GPT6的表现堪称戏剧性——它先做全面排查,找到了切面相关问题,5分钟就给出方案,随后触发了5小时的用量上限,在最后时刻用25分钟完成修复。验证结果:一轮做对,直接拿下3分。UP主感慨这道盘踞山巅一月之久的王者Bug「此刻突然黯然失色」,甚至表示要「解锁另外四个王者,准备开启下一个副本」。
Fable5.1的历程更加曲折。前两轮均告失败,直到第三轮用16分钟才成功修复,为自己挣回1分,保住了颜面。UP主认为这或许是「美洲马神最后一次参加屎山论剑」,能顶住压力做对已属不易。
Gemini 3.8 Flash则彻底失守。第二轮它一口气修改了20多个文件「火力全开」,结果改出了循环依赖——UP主直言这是「脑子已经跟不上改动的复杂程度」。修复循环依赖后的第三轮依然未能通过。
并发Bug是软件工程中公认最难复现和定位的缺陷类别。其根本原因在于多线程执行顺序的不确定性——问题只在特定时序下触发,单线程调试或低并发测试往往完全正常。当并发问题再与缓存失效、多个业务逻辑分支耦合时,排查难度呈指数级上升:修复一处可能打破另一处的时序假设,导致"越改越乱"。Fable5.1前两轮失败以及Gemini第二轮修改20余个文件后引入循环依赖,都是这种复杂性的典型体现。循环依赖指模块A依赖模块B、模块B又依赖模块A,在Spring等依赖注入框架中会导致应用启动失败,属于结构性错误,往往意味着前期的修改方向从根本上就出了偏差。
最终成绩与启示
本次对决最终成绩:GPT6从头到尾一轮通关,斩获满分8分;Fable5.1钻石与王者均有得分,拿下5分;Gemini 3.8 Flash则停留在2分——黄金题以下基本无对手,但钻石以上难度仍需努力,UP主也直接喊话「赶紧Pro吧」。
这场测试的价值在于,它超越了标准化跑分,用真实项目中的复杂技术债务来考验模型。几个结论值得从业者关注:
- 基础能力已趋同:黄金级Bug三家全部一轮通过,说明主流旗舰模型在常规编程任务上差距不大。
- 复杂耦合见真章:钻石和王者级别的多逻辑耦合场景,才是拉开差距的关键,GPT6的稳定性和架构理解能力明显更强。
- 速度不等于质量:Gemini速度最快却屡屡失分,Fable5.1和GPT6速度偏慢反而更可靠,提示词质量与推理深度比响应速度更重要。
视频结尾,UP主还让GPT6用HTML和SVG生成了一个「鸟在海边骑自行车看日落」的交互动画,带交互与变速调节,展现了模型在代码生成之外的创造力。屎山的Bug当然要改,但正如UP主所言——海边的日落也尽量别错过。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。