GPU基准测试在说谎:热节流下的LLM推理该怎么测

30秒基准测的是GPU冷态峰值,生产需用稳态数据做容量规划。
文章指出,团队常用30秒短测得到的tokens/s做容量规划,但这一数字反映的是GPU在boost频率下的冷态峰值性能。现代GPU(如被动散热的T4)在持续负载下会因功耗与温度触及上限而热节流降频,实测稳态吞吐往往比冷态低近10%。作者提出三步方法:用nvidia-smi或NVML同步记录SM频率、温度、功耗和throttle reasons;让基准测试持续10–15分钟,拆分prefill与decode并对比cold与steady数据;再通过锁频、persistence mode、量化选择和dcgm-exporter监控来换取稳定性能。核心结论是容量规划必须使用稳态的median和p10,而非平均值或冷态数字。
大多数团队在评估LLM推理性能时,习惯跑30秒拿一个tokens/s的数字就拍板。但把这个数字搬进生产环境后,实际吞吐往往比预期低一截。问题不在模型,也不在推理框架,而在于测量方式本身忽略了GPU在持续负载下的热节流行为。
为什么30秒的基准测试几乎毫无意义
现代GPU不会一直跑在固定频率上。以NVIDIA T4为例:TDP只有70W,boost clock最高1590 MHz,且采用被动散热——卡本身没有风扇,散热依赖服务器风道。刚开跑时显卡温度低,驱动会把频率推到最高;几分钟后温度和功耗触及上限,驱动开始降频。这就是throttling(热节流)。
常见的降频原因有三类:
- SW Power Cap:触及功耗上限,在T4上非常频繁
- HW Slowdown / HW Thermal Slowdown:硬件层面的过热保护
- SW Thermal Slowdown:驱动主动降频以控制温度
对LLM推理而言,decode阶段主要受memory bandwidth限制,SM频率下降并不会导致速度等比例下滑;而prefill阶段受compute限制,受降频影响要严重得多。如果你只测开头30秒的一个笼统tokens/s数字,你测到的只是GPU状态最好的那一刻——而生产环境永远不在那个状态。
Boost clock 是GPU在散热和功耗允许的余量内可以短暂达到的最高频率,并非持续可用的额定频率。NVIDIA的GPU默认遵循一套动态频率调节策略:当芯片温度较低、功耗未触顶时,驱动会把SM频率推到boost上限;一旦温度或功耗逼近阈值,频率便逐步回落到base clock附近甚至更低。因此厂商标称的boost clock本质上是“瞬时峰值”,而不是持续负载下的稳定工作点。对LLM推理这类长时间满载的workload而言,真正决定tokens/s的是稳态频率,而非开机头几十秒的boost频率。理解这一点,就能明白为什么任何以“跑一下看看多快”为目的的短测,测到的都是GPU最理想的瞬时状态。
第一步:在基准测试过程中观察GPU
在测tokens/s之前,先得知道GPU在干什么。nvidia-smi自带持续日志模式,可以另开一个终端同步采集:
**TDP(Thermal Design Power)** 是GPU厂商给出的散热设计功耗,表示该卡在持续负载下预期消耗并需要被散去的热功率上限。T4的TDP仅70W,且采用单槽被动散热设计——卡上没有风扇,完全依赖服务器机箱的前后风道把热量带走。被动散热卡的实际散热能力高度依赖机箱风道、进风温度和相邻板卡的发热,因此同一张T4装在不同机箱、不同机架位置,能维持的稳态频率可能明显不同。这也解释了为什么云上同型号实例之间的吞吐会有几个百分点的差异:热环境不同,热节流触发的时点和深度就不同。评估这类卡时,TDP和散热方式比boost clock更值得先看。
# 每秒输出CSV,与基准测试并行运行
nvidia-smi \
  --query-gpu=timestamp,temperature.gpu,clocks.sm,clocks.mem,power.draw,power.limit,clocks_throttle_reasons.active \
  --format=csv,nounits -l 1 > gpu_log.csv &

# 查看当前降频原因详情
nvidia-smi -q -d PERFORMANCE

# 查看显卡支持的最高频率
nvidia-smi -q -d CLOCK | grep -A3 "Max Clocks"
驱动535以上版本把该字段改名为clocks_event_reasons.active,旧名字在多数驱动上仍可用;如果遇到Field ... is not a valid field报错,改用新名称即可。该字段是一个bitmask:0x0000000000000004对应SW Power Cap,0x0000000000000020对应SW Thermal Slowdown。
读gpu_log.csv时通常会看到同一个模式:第一分钟clocks.sm稳定在1590,第3到5分钟逐渐跌到1200–1350并稳定下来。这个稳定值才是计算容量该用的数字。
第二步:测足够久,并按时序记录数据
llama.cpp的llama-bench适合快速对比,但默认只重复5次(-r 5),每次都很短。可以这样加强:
**NVML(NVIDIA Management Library)** 是NVIDIA提供的底层监控与管理接口,`nvidia-smi`命令本身以及`dcgm-exporter`、各类GPU监控Agent都构建在它之上。通过`nvidia-ml-py`这个Python绑定,程序可以在基准测试循环内以亚秒级粒度读取温度、SM/显存频率、功耗以及throttle reasons位掩码,从而把每一次请求的tokens/s与当时的GPU状态一一对齐。相比事后看`nvidia-smi`的瞬时快照,NVML采样的价值在于时序对齐:你能直接看到第几分钟开始降频、降频后decode与prefill各自掉了多少。这也是把“测一个数”变成“测一条曲线”的关键工具。
# 预热+多次迭代,输出JSON便于分析
./llama-bench -m models/gemma-3-4b-it-Q4_K_M.gguf \
  -ngl 99 -p 512 -n 256 -r 50 -o json > bench.json
更有效的做法是持续向llama-server发送请求,同时通过NVML采集GPU指标。以下脚本依赖nvidia-ml-py(pip install nvidia-ml-py requests):
import time, json, statistics, requests
import pynvml as nv

URL = "http://127.0.0.1:8080/completion"
DURATION = 15 * 60  # 跑15分钟
PROMPT = "解释PostgreSQL中B-tree索引的机制。 " * 20

nv.nvmlInit()
h = nv.nvmlDeviceGetHandleByIndex(0)

rows, start = [], time.time()
while time.time() - start < DURATION:
    r = requests.post(URL, json={"prompt": PROMPT, "n_predict": 256,
                                  "cache_prompt": False}).json()
    t = r["timings"]
    rows.append({
        "t": round(time.time() - start),
        "prefill_tps": t["prompt_per_second"],
        "decode_tps": t["predicted_per_second"],
        "temp": nv.nvmlDeviceGetTemperature(h, nv.NVML_TEMPERATURE_GPU),
        "sm_mhz": nv.nvmlDeviceGetClockInfo(h, nv.NVML_CLOCK_SM),
        "power_w": nv.nvmlDeviceGetPowerUsage(h) / 1000,
        "throttle": hex(nv.nvmlDeviceGetCurrentClocksThrottleReasons(h)),
    })
    print(rows[-1])

json.dump(rows, open("run.json", "w"))

def summary(sub, label):
    d = [x["decode_tps"] for x in sub]
    p = [x["prefill_tps"] for x in sub]
    print(f"{label}: decode median={statistics.median(d):.1f} "
          f"p10={statistics.quantiles(d, n=10)[0]:.1f} | "
          f"prefill median={statistics.median(p):.0f}")

summary([x for x in rows if x["t"] < 60], "Cold (0-60s)")
summary([x for x in rows if x["t"] > DURATION - 300], "Steady (最后5分钟)")
脚本里有三个关键点:
cache_prompt: False:不关掉的话,prefill会复用上一个请求的KV cache,测出的prefill数字虚高- 拆分prefill和decode:两个阶段对热节流的反应差异很大,混在一起会掩盖问题
- 对比cold和steady:这是整件事里最重要的数字。两者差距超过5%,容量规划就必须用steady值
第三步:确认显卡降频后的止损手段
知道卡在降频之后,可以采取以下措施:
- 锁频换取稳定性能:
sudo nvidia-smi -lgc 1200,1200锁定GPU频率。听起来像自废武功,但吞吐会变得稳定、p99延迟更可预测,很多情况下平均性能反而不降,因为频率不再反复波动。解锁用sudo nvidia-smi -rgc。云VM上可能没有这个权限。 - 开启persistence mode:
sudo nvidia-smi -pm 1让驱动在多次运行之间不卸载,避免第一个请求偏慢。 - 选择匹配workload的量化:decode受带宽限制,Q4_K_M通常比FP16更不容易受降频影响,因为每个token需要读取的数据更少。
- 显卡热时减小prefill batch:如果workload偏重prompt(长上下文RAG),减小
-ub(ubatch size)以降低功耗尖峰。 - 生产环境监控:通过
dcgm-exporter把NVML指标导出到Prometheus,当DCGM_FI_DEV_CLOCK_THROTTLE_REASONS连续超过10分钟非零时告警。
还有一点:云上同型号的两台T4实例可能相差几个百分点,取决于机架位置和服务器风道。不要只在一台实例上测完就把数字套到整个集群。
p99延迟 指把所有请求的延迟从低到高排序后,第99百分位对应的那个值,即最慢的1%请求的延迟水平。对在线推理服务而言,p99往往比平均值更能反映用户体验和SLA风险:平均值会被大量快速请求拉低,掩盖掉少数卡顿请求。GPU频率反复波动时,平均吞吐可能看起来还行,但落在降频窗口里的请求会显著变慢,p99随之恶化。锁频之所以常能在平均性能不明显下降的前提下改善p99,正是因为它消除了频率波动带来的延迟长尾。做容量规划时,除了median,也应关注p10吞吐和p99延迟这类尾部指标。
要点与结论
LLM基准测试只跑30秒,得到的是营销数字,不是运维数字。原文作者分享了一个真实教训:团队在按小时租用的GPU上测8B模型,30秒跑出42 tokens/s并据此做容量规划,上线后连续跑一整天实际只有37–38 tokens/s,容量缺口接近10%——问题既不在模型也不在llama.cpp,而在测量方式。
应该立即做的事:
- 基准测试至少跑10–15分钟,同步记录SM频率、温度、功耗和tokens/s
- 分别报告prefill和decode,用median和p10替代平均值
- 用steady state数字做容量规划,冷卡数字不可用;差距超过5%时在sizing文档里写清楚
- 需要可预测延迟时考虑锁频,而非追求峰值吞吐
- 把throttle reasons纳入监控,随时知道生产是否在低于spec的状态下运行
GPU不会说谎,它只是精确回答你提出的问题。想知道跑一整天时的性能,就得在跑一整天的条件下测量。
相关推荐
Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。
Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。
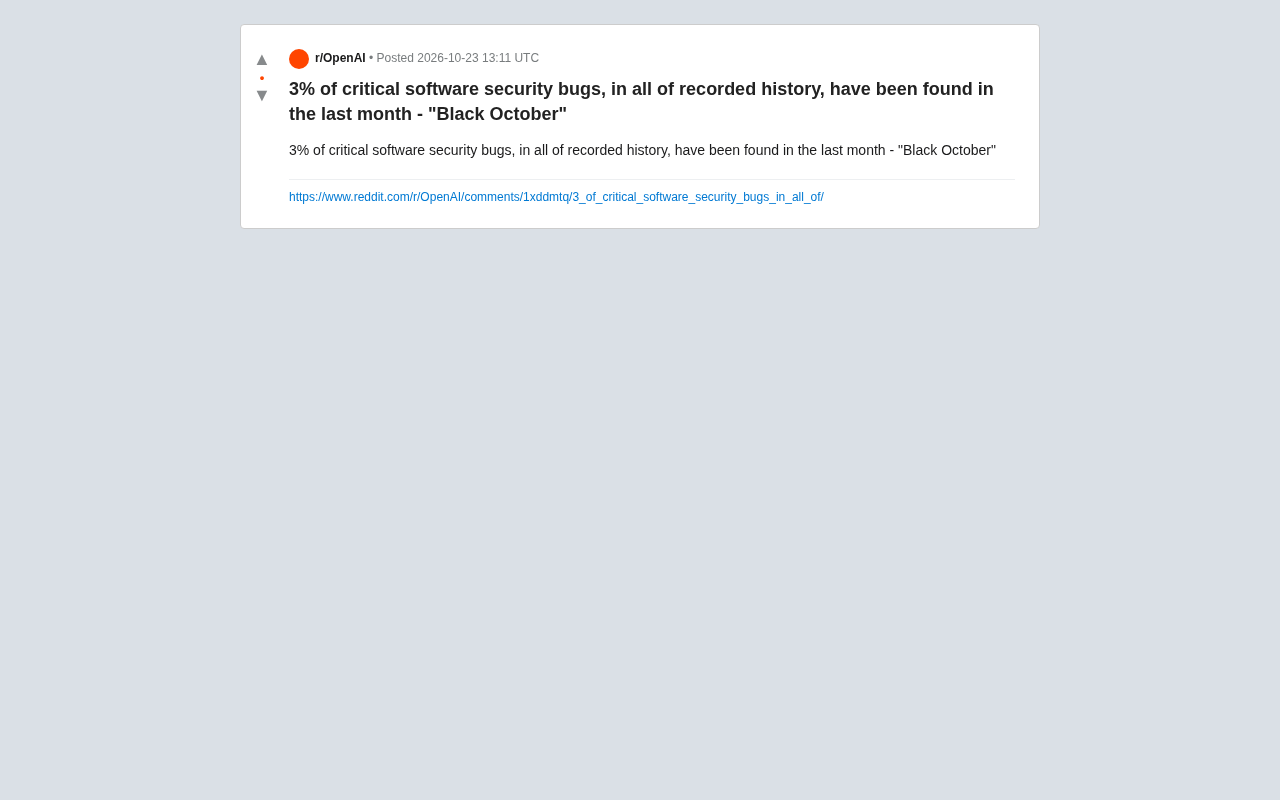
“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。