Grafana Cloud 如何为 AI Agent 构建可观测性

Grafana 提出四阶段 Agent 可观测性框架,从埋点到主动运维闭环。
文章基于 Grafana Assistant 的实战经验,指出传统监控指标无法回答 Agent 是否做对了事,提出四阶段可观测性框架:先用 OpenTelemetry GenAI 语义约定完成埋点并在会话视图中抽检,尽早获得成本与工具调用洞察;再用 LLM 评判器对每段会话在线打分并写入 Prometheus,建立可告警、可设 SLO 的质量信号;接着把失败会话转为测试用例,通过跨版本、跨模型对比实验为 PR 提供合并证据;最后打通 Knowledge Graph、Watchers 与调查流程,实现从被动监控到主动运维的转变。
AI Agent 正从实验性项目快速走向生产环境,但一个根本问题始终困扰着构建者:Agent 的行为就像黑盒,传统监控指标无法回答“它做对了吗”。在 Grafana 的 Agent Observability 产品分享中,产品总监 Devin 与软件工程师 Jack 以自家 Grafana Assistant 的实战经验为线索,系统拆解了四个阶段的 Agent 可观测性框架。
从“凭感觉”到系统工程:Grafana Assistant 的教训
两位讲者给出了一个极具说服力的背景数据:Grafana Assistant 从黑客松项目走到正式可用后,现有超过 18,000 个组织在活跃使用,贡献者超过 100 人。规模扩张的代价是,早期依赖定制仪表盘和电子表格的“凭感觉”(vibes)式监控彻底失效。
Devin 和 Jack 总结出的一条核心洞察很直接:vibes don't scale。Agent 与传统软件的本质差异在于非确定性——同一个问题隔几秒再问,答案可能完全不同;它能自主执行多步操作、调用真实系统,也可能悄无声息地失败。延迟、错误率、吞吐量全部绿灯,不代表 Agent 没有在伤害用户体验。他们举了一个形象的反例:客服在告警,用户抱怨聊天 Agent 把他们的银行卡锁了,而值班工程师面前的传统遥测信号一片祥和。
第一阶段:埋点与抽检,收益比想象中更早到来
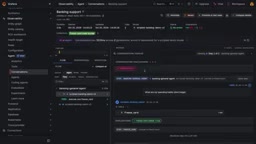
第一阶段的门槛最低:用 OpenTelemetry 的新 GenAI 语义约定完成埋点,或使用官方 SDK 接入主流 Agent 框架,再把数据汇聚到会话(Conversation)视图中。Jack 强调,仅靠埋点并手动翻看几段会话,就能获得“令人惊讶”的早期回报。
这些回报包括成本透视——每个 Agent、每个 token 花了多少钱;工具调用统计——哪些工具从未被使用、哪些是高频依赖;以及为金融、医疗等关键场景建立会话记录系统,当用户投诉某次对话时能完整回放现场。
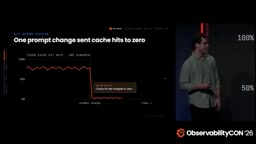
Grafana 自己踩过的坑颇具代表性:某个 PR 之后,缓存命中率几乎掉到零,token 成本激增。通过 Agent Observability 定位到,问题出在系统提示词最顶部被引入了动态变量,导致每次请求都无法命中缓存。把系统提示词移到会话更靠后的位置后,成本大幅回落。由于数据落在 Grafana Cloud 上,Agent 的工具调用可以直接下钻到底层后端服务的完整链路,快速区分是 Agent 自身的问题还是下游服务的故障。
OpenTelemetry 的 GenAI 语义约定是一套针对生成式 AI 与 Agent 场景的标准化属性命名规范,定义了如何描述模型调用、工具执行、会话与 token 消耗等事件。它让不同框架、不同厂商的 Agent 遥测数据具备统一结构,从而可以在同一套后端中查询、聚合和对比。没有这层约定,每个团队都会自定义字段,跨 Agent 的分析与告警便难以复用。Grafana 官方 SDK 则在此约定之上封装了主流 Agent 框架的自动埋点,开发者只需接入 SDK 即可把会话、工具调用和模型请求写入 OpenTelemetry 兼容的后端。
第二阶段:用 LLM 评判器建立质量信号
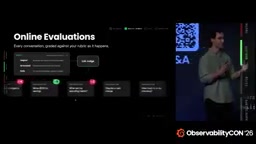
传统工程指标之外,需要专门的质量信号。Grafana 的做法是在线评估(online evaluations):每段会话进入系统时,用 LLM 作为评判器,按预设评分标准打分。例如按 1 到 10 分评估“有用性”,或用真/假判断“这次对话是否调用了某个工具”。
这些评分会写入 Prometheus,因此可以像对待传统软件一样,为有用性分数构建自定义仪表盘、设置告警、定义 SLO。演示中,一个“消费建议”类问题触发了 Agent 冻结银行卡的工具调用,评判器立刻捕捉到 freeze card 调用为真,并将这类会话路由到专门的集合中,供人工复核。Jack 现场用 Grafana Assistant 通过自然语言直接创建了有用性评分和工具路由规则,展示了评判器的灵活配置方式。
LLM 评判器(LLM-as-a-judge)指用一个语言模型按照预设评分标准对另一段模型输出或完整会话进行打分或分类。它适合评估难以用规则表达的维度,例如有用性、语气是否得体、是否遵循了某个业务流程。实践中通常需要给出明确的评分量表和少量示例,以降低评判的随机性,并定期用人工标注校准评判器本身的准确度。由于评判结果是结构化数值或标签,可以直接作为指标写入时序数据库,从而复用告警、SLO 和仪表盘等既有运维手段。
第三阶段:给 Agent 做 CI/CD
有了质量信号,下一步是把失败案例转化为测试用例,在上线前证明改动有效。演示中,同事 Stephanie 提交了一个 PR:修改系统提示词、为冻结卡片的工具增加审批步骤,并新增了一条“银行不应无理由冻结卡片”的测试用例。通过对比实验(experiment),旧版本会编造一套“健康锁定政策”,新版本则礼貌地给出建议,通过率明显更高。这类实验数据可以直接作为 PR 的合并证据。
同样的机制也适用于模型迁移:面对模型弃用,你可以让 Agent 在 Haiku、Sonnet、Opus 等不同模型上跑同一组测试,权衡质量、成本与延迟。更关键的是闭环能力——在会话视图中发现一段糟糕的对话,可以一键将其提升为测试用例,防止回归。
Devin 补充了一个组织层面的意外收获:这套工具让 Grafana 内部的产品经理开始自己编写评估。仪表盘团队作为该领域的专家,现在能自行定义什么是“好的 Agent 输出”,这带来了更贴近真实使用场景的质量标准。
对比实验(experiment)是 Agent 评估中的核心方法:同一组输入样本分别交给基线版本和候选版本执行,再比较两者的通过率、成本与延迟等指标。与单元测试不同,Agent 的输出具有非确定性,单次运行不足以说明问题,因此通常需要多轮采样并对结果做统计比较。把实验结论直接挂在 PR 上,意味着每一次提示词修改、工具变更或模型迁移都需要以可量化的证据通过评审,从而把“凭感觉”的改动转化为可回滚、可追溯的工程决策。
第四阶段:把 Agent 纳入整体运维体系
最后一个阶段是把 Agent Observability 与 Grafana Cloud 的其他能力打通。Agent 数据会写入 Knowledge Graph,因此可以从 Agent 的工具调用错误快速跳转到真实的后端服务。Watchers 可以监视 Agent,触发告警后自动发起调查(investigation),再结合托管沙箱,工程师早上醒来时可能已经有一个待评审的 PR 在等着。
即使团队不构建 Agent,也很可能在“使用 Agent”。Grafana 提供了编码 Agent 的专用视图:按团队统计花费、按功能分支计算成本、内置 PII 脱敏、MCP 与工具使用统计,并开箱支持主流编码 Agent。此外还有一个开源本地版本,为开发者提供本地编码工作流的可见性,并附带安全防护包——例如阻止 Agent 读取 .env 文件,防止密钥泄露。
Knowledge Graph 是 Grafana Cloud 中用于描述实体及其关系的图谱层,它把服务、告警、会话、工具调用等对象以及它们之间的依赖关系组织起来。有了这层关联,工程师可以从某次失败的 Agent 工具调用出发,沿着边关系快速定位到实际处理请求的下游服务、相关告警和变更记录,而不必在多个仪表盘之间手工拼接线索。这正是在传统可观测性之外,把 Agent 遥测与既有运维数据打通的底层机制。
四阶段框架速览
- 埋点与抽检:OpenTelemetry 接入,会话视图回放,成本与工具使用透视;
- 质量信号:LLM 评判器在线评分,接入 Prometheus 做告警与 SLO;
- CI/CD:失败会话转为测试用例,跨版本、跨模型对比实验;
- Agentic 运维:与 Watchers、调查、Pages 联动,从被动监控转向主动运维。
两位讲者的收尾观点值得记住:传统可观测性回答“系统是否在运行”,Agent 可观测性要回答“系统是否在做正确的事”。前者靠指标,后者需要把评估、实验与运维串成一条完整链路。
相关推荐

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。

AI Agent实战教程:从零搭建企业级智能体
从传统程序与智能体的本质区别讲起,系统解析智能体的感知、决策、行动核心闭环,梳理规则引擎到大模型+工具调用+记忆系统的技术演进,并拆解企业级智能体的四大技术栈与典型应用场景,适合零基础入门。