Grok 4.5实测:代码生成与科研绘图能力全面解析

Grok 4.5来了:大模型竞赛进入新阶段
xAI发布Grok 4.5之后,大模型领域的竞争再度白热化。据多位开发者的实测分享,Grok 4.5在综合能力上直接对标Anthropic的Claude Opus系列,代码生成、逻辑推理与多模态处理均展现出旗舰级水准。
关于xAI与Grok的技术背景:xAI由埃隆·马斯克于2023年创立,Grok系列大模型是其核心产品线。与OpenAI、Anthropic等竞争对手不同,xAI的训练数据来源包含X(前Twitter)平台的实时信息流,这赋予了Grok模型在时效性信息处理上的天然优势。Grok 4.5在架构上延续了Mixture-of-Experts(MoE,混合专家模型)的设计思路——这一架构通过动态激活不同"专家"子网络来处理不同类型的输入,在维持推理速度的同时显著提升参数规模的利用效率,是当前主流大模型提升性价比的核心技术路径之一。
文章提到的多模态处理,是指模型同时理解和生成文本、图像、代码等多种数据类型的能力。这一能力的实现依赖于视觉编码器(Vision Encoder)与语言模型骨干网络的深度融合——视觉编码器(通常基于ViT,即Vision Transformer架构)负责将图像转化为模型可理解的向量表示,再与文本Token共同输入Transformer主干进行联合建模。当前顶级多模态模型的竞争焦点已从"能否识别图像"升级为"能否在复杂跨模态推理任务中保持一致性",这也是Grok 4.5与Claude Opus 4、Gemini 1.5 Pro等进行横向比较时的核心评估维度。
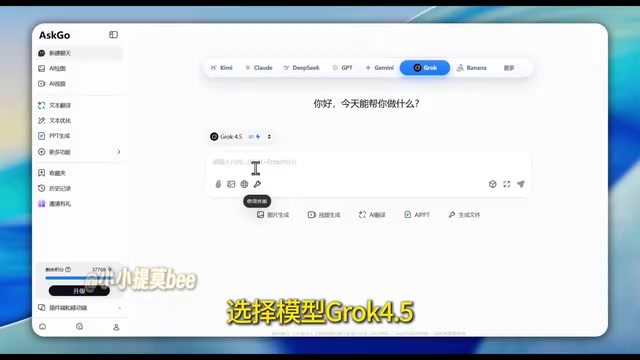
对于国内用户来说,直接访问Grok往往面临一定门槛。近期兴起的AI聚合平台,让开发者和研究者可以在同一界面下调用Grok 4.5、Gemini全系列及GPT最新版本,大幅降低了体验前沿AI的成本。
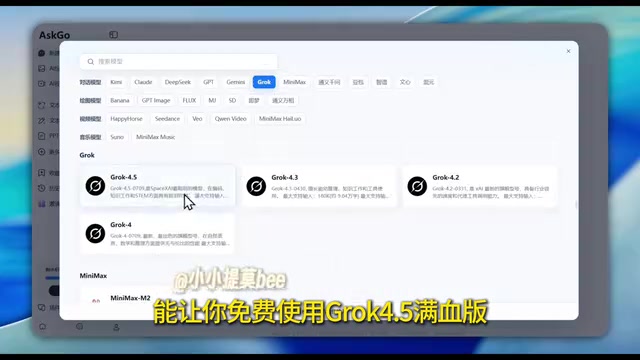
AI聚合平台的技术实现原理:这类平台的技术核心是统一API网关(Unified API Gateway)架构。平台在后端维护与各大模型官方API的连接,对外暴露统一的调用接口,用户的请求经由平台路由至对应模型服务商的端点。这类平台通常还会实现负载均衡、请求缓存与流式响应(Streaming Response)的统一封装,以改善用户体验。然而这种架构也意味着用户的输入数据会经过第三方服务器中转——这与直接调用官方API存在本质区别,是评估数据安全风险时需要重点考量的技术事实。这类聚合平台的核心价值在于"一站式":无需分别注册多个海外账号、维护多套订阅,即可在网页端、浏览器插件、手机与电脑之间无缝切换。便利之余,也需关注数据安全与合规性,优先选择可信度较高的服务方。
实测一:网页开发与代码生成能力
测试中,向Grok 4.5输入一段网页开发提示词后,模型在短暂等待后输出了结构完整、注释清晰的代码。
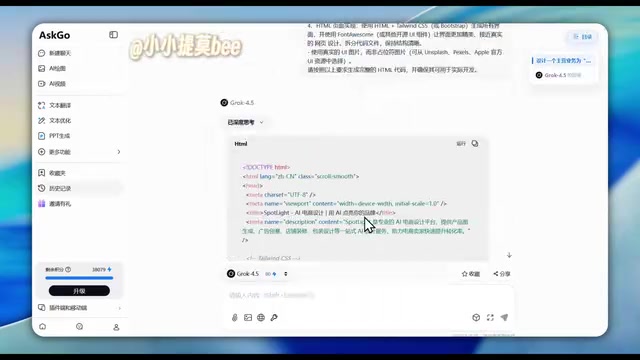
点击运行后,生成页面在视觉审美与交互质感上表现亮眼。从演示效果来看,Grok 4.5对现代前端设计规范——包括布局层次、配色搭配与交互细节——的理解已相当成熟,能够一次性产出接近可用状态的页面。
大模型代码生成的技术原理:这一能力源于模型在海量代码语料(包括GitHub开源代码库、技术文档、Stack Overflow问答等)上的预训练,结合指令微调(Instruction Fine-tuning)和RLHF(基于人类反馈的强化学习)优化输出质量。前端代码生成任务之所以成为模型能力的重要评测维度,是因为其同时考验自然语言理解、结构化逻辑生成与视觉美学表达三种能力的协同。但值得注意的是,大模型生成的代码存在"幻觉式漏洞"风险——代码在语法层面完全正确,却可能包含过时的API调用、潜在的XSS注入漏洞,或在边缘用例下出现逻辑错误,这些问题难以通过肉眼代码审查发现,必须依赖完整的测试覆盖体系加以验证。
对前端工作流的实际意义
对前端开发者而言,Grok 4.5的实用价值主要体现在三个方面:快速原型搭建、样板代码生成、设计灵感辅助。它能显著压缩从需求到初版页面的时间成本。但若要投入生产环境,仍需人工审查代码质量、可维护性与安全性。Grok 4.5更适合定位为"效率放大器",而非替代开发者判断的工具。
实测二:文献理解与科研绘图能力
第二个测试更具专业性:上传一篇学术文献,让Grok 4.5根据内容生成科研配图的提示词,再将其传入图像生成模型,选择合适比例后提交。
结果颇为意外——生成图像达到了接近顶刊插图的质感。这一流程清晰展示了大模型在科研工作流中的潜力:语言模型负责理解文献语境、生成精准绘图描述,图像模型负责渲染输出,形成"文本理解+视觉生成"的高效协作链路。
科研图像生成的技术链路解析:这种"语言模型理解文献→生成绘图提示词→图像模型渲染输出"的流程,本质上是一种典型的AI智能体(AI Agent)工作流,即通过工具调用(Tool Use)将多个专业模型串联成任务流水线。其中提示词工程(Prompt Engineering)是连接两个模型的关键环节——语言模型需要将文献中的数据关系、可视化意图精确转化为图像生成模型能够理解的视觉描述语言。当前主流的科研图像生成通常使用Stable Diffusion系列或DALL·E等扩散模型(Diffusion Model)作为渲染后端,这类模型擅长生成视觉美观的概念图,但在精确数据可视化(如坐标轴刻度、误差棒表示)方面存在先天局限,这正是"需人工核验"的技术根源。
需要理性看待的局限性
尽管演示效果亮眼,科研配图对准确性与严谨性的要求极高。AI生成的图表在美观度上表现出色,但可能在数据准确性、单位标注和逻辑关系上出现偏差。在正式发表场景中,研究者应将其视为草图或灵感来源,而非可直接使用的成品,必要的人工核验环节不可省略。
多模型聚合平台:机遇与理性并重
从本次实测可以看出,聚合平台确实让普通用户以更低门槛体验到了Grok 4.5、Gemini、GPT等顶级模型的完整能力。对于开发者提效和科研人员辅助创作来说,这类工具的吸引力大家都看得到。
不过,以下几点值得保持清醒认知:
- 合规与数据安全:第三方聚合平台涉及数据转发,处理敏感信息时应格外谨慎,避免上传涉密或隐私内容。
- 服务稳定性:部分平台的低价供给依赖非官方渠道,存在服务中断或随时下线的风险。
- 能力真实性:各平台对"满血版"的定义参差不齐,实际体验与官方版本可能存在差距,使用前建议交叉验证。
小结:善用工具,保持判断
Grok 4.5的发布再次印证了大模型能力的快速迭代——顶级模型之间的差距持续收窄,多模型聚合趋势也赋予用户"货比三家"的自由。对开发者与研究者而言,善用这些工具能带来切实的效率提升。但在拥抱便利的同时,对合规性、数据安全和结果可靠性保持清醒判断同样重要。真正可持续的生产力,来自"AI辅助+人工把关"的协作模式,而非对工具的盲目依赖。
核心要点
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。