Grok 4.7实测解析:马斯克的追赶战打得如何?

Grok 4.7以持平上代的低价主打性价比,基准接近但未超越前沿,agentic编程仍是明显短板。
xAI发布的Grok 4.7定位为其编程与知识工作领域最强模型,维持与上代相同的低价(输入2美元/百万token),在竞品售价高出两至五倍的背景下主打性价比。多项基准测试显示其"接近前沿一步":DeepSuite得分71%、法律工作领域领先同类,但Terminal Bench仅38%,agentic编程能力明显落后于Fable 5.1和Astra。马斯克"超越所有模型"的预测落空,实测约在Fable 5水平,"与Opus持平"的说法则基本成立。此外,500k的上下文窗口限制与更高的任务token消耗,也是不可忽视的实际短板。整体而言,Grok 4.7是一个在价格曲线上极具竞争力的选项,但尚未成为新的前沿标杆。
Grok 4.7发布:一次性价比优先的迭代
Grok 4.7正式上线,被xAI定位为其在编程和知识工作领域最强的模型。官方博客的描述很直接:它能在困难任务上工作更久、更仔细地核查自己的输出,并配备了迄今为止校准最好的安全防护机制。关键是,价格与上一代Grok 4.6完全相同——每百万输入token收费2美元,每百万输出token收费6美元。
这个定价才是理解Grok 4.7的核心。它不是最前沿的模型,但胜在离前沿只差一步,且价格远低于竞品。作为对比,GPT 5.6 Sol的价格是它的两倍多,Fable 5.1超过五倍,GPT 6 Astra也达到五倍。用视频作者的话说,很多行业愿意为最好的答案多付几倍钱,但同样有大量行业只想把知识工作自动化完成,并不追求那零点几个百分点的极致表现。
值得留意的一个背景:xAI囤积了海量算力,前期过度投资却迟迟没能造出能拉动需求的前沿模型。这种供大于求的局面,反而让它有底气把价格压得更低。
马斯克的预测兑现了吗?
本次讨论的一个有趣切入点,是马斯克此前的公开预测。大约一周前他发推称,Grok 4.7应该大致与Opus 5.0持平(而非5.1)。更早在更激进的表态中,他甚至说Grok 4.7将"超越当前所有模型"。
从实测结果看,马斯克那句"与Opus持平"的预测相对靠谱,但"超越所有模型"则明显落空。视频作者的判断是:Grok 4.7大致接近Fable 5的水平,但绝对到不了Fable 5.1。这种"激进时间表加激进预测"是典型的马斯克风格,尽管这次没完全兑现,但作者也坦言"长期而言不会押注他失败"。
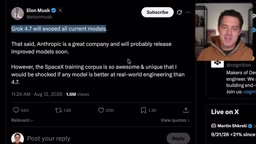
延期本身也有故事。Grok 4.7原计划提前约一周半发布,马斯克解释说"还需要多烤几天",因为模型在惩罚机制上"可能做得太过或者别的什么",仍存在过早放弃本可完成的难题、自我核查不够严谨的问题。让模型多打磨一段时间,这一点作者是认可的。
基准测试:接近前沿,但并非全面领先
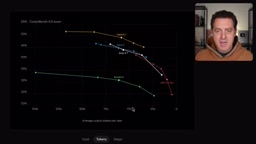
Grok 4.7在多个基准上表现出明显的"接近但未登顶"特征。在CursorBench 4.0上(注意Cursor现由xAI拥有,存在利益关联),最高思考强度下Grok 4.7得分46.3%,略逊于Opus,但运行同一测试的成本仅为对方的约一半。一个显著细节是:从低思考强度的33%到超高强度的46.3%,分差巨大,这是除GPT 5.6 Sol外最陡峭的曲线之一。
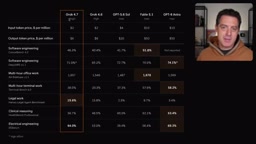
在被视为最贴近工程师真实生产体验的DeepSuite上,Grok 4.7拿到71%,GPT 5.6 Sol为72.7%,Fable 5.1为70%。这里作者点出一个问题:博客的这张对比表刻意没放Astra——而Astra在其他图表里却出现了,显得有些取巧。作者干脆让Astra自己重建了这张表,结果Astra Max以74.1%登顶。
分领域来看差异更明显。Terminal Bench 4.0(衡量agentic编程能力的关键指标)上Grok 4.7只有38%,远落后于Fable 5.1的57.9%和Astra的58.2%。但在法律工作基准上,Grok 4.7以19.6%碾压其他所有模型——不过真正的黑马是MuseSpark 1.2,以25.42%成为该项冠军。此外在GDP Val这个OpenAI自家的真实知识工作基准上,Grok 4.7以16.95 ELO表现亮眼,仅次于Fable 5.1的17.35。
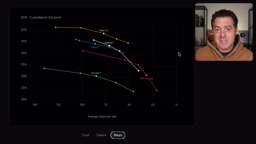
CursorBench、DeepSuite、Terminal Bench是当前AI编程能力评测体系中几个各有侧重的基准。CursorBench由代码编辑器Cursor设计,模拟真实的多步骤编程任务,且支持不同"思考强度"档位,适合衡量模型在算力资源充裕时的上限表现。DeepSuite则更贴近软件工程师的实际日常——涵盖代码生成、调试、重构等典型场景,被认为比纯粹的算法题更能反映生产可用性。Terminal Bench则专注于衡量agentic编程能力,即模型自主在终端环境中规划、执行并验证多步骤任务的能力,这正是当前"AI程序员"方向最核心的能力维度之一。Grok 4.7在Terminal Bench仅38%的表现,意味着它在需要自主完成长链路工程任务的场景下仍有明显短板,而这恰恰是Fable 5.1(57.9%)和Astra(58.2%)的优势所在。
成本、开源趋势与端侧格局
在Artificial Analysis的智能指数中,Grok 4.7(超高思考强度)目前排在第五位,得分46。前四名分别是Fable 5.1、Astra、Cloud Opus 5,以及有些出人意料的MuseSpark 1.3 Max。你可能没注意到,MuseSpark 1.3、GLM 5.3 Max、Kimi K3等排在Grok前后的多个高分模型都是开源开放权重模型。
作者引用Gavin Baker的观点指出一个趋势:企业侧的总token用量正在向开放权重模型倾斜,目前开源占62%、闭源占38%,因为开源更高效、更可控、更便宜、更注重隐私。但真正的价值仍然集中流向OpenAI和Anthropic两家——你无法在没有绝对最优答案的前提下,收取绝对前沿的价格。
Grok 4.7还有两个实际短板需要留意。其一是Artificial Analysis指出它的性能提升伴随着更高的token消耗,因此"每完成一个任务的成本"会相应上升;其二是它的上下文窗口只有500k,而几乎所有其他前沿模型都做到了100万token。对普通用户这未必是问题,但做高上下文的专业工作时会成为限制。
**开放权重模型(Open-weight models)**与通常意义上的"开源"略有区别:前者公开模型权重供下载和本地部署,但不一定公开训练代码或数据集,后者则指代码与权重均完整开放。文中提到的MuseSpark 1.3、GLM 5.3 Max、Kimi K3等均属于开放权重阵营。企业采用开放权重模型的核心动机包括:数据不出本地(隐私合规)、推理成本可自控、可针对私有数据进行微调,以及避免被单一API供应商锁定。Gavin Baker所指出的"62%开源占比"这一趋势,反映的正是企业级用量在规模化后向这类模型迁移的结构性转变,而非普通消费者层面的偏好。然而,在需要绝对最优输出质量的高价值决策场景中,OpenAI与Anthropic的闭源前沿模型仍保有溢价能力。
结论:一个足够好的性价比选项
Grok 4.7不是新的前沿之王,马斯克"超越所有模型"的预言也没实现。但它在离前沿一步之遥的位置上,提供了极具竞争力的价格。马斯克本人的反应也颇具他一贯的好胜——称Grok 4.7让xAI在agentic编程上排到Anthropic和OpenAI之后的第三位。
对终端用户而言,这种竞争本身就是好事。作者的期望是Grok在4.8或4.9版本真正触及前沿。至于现在,用一句话概括就是:足够接近,且极具成本效益。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。