谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全

谷歌发布Gemini 4 Carbon,综合排名居首但优势微弱,主打网络安全并优先开放给防守方。
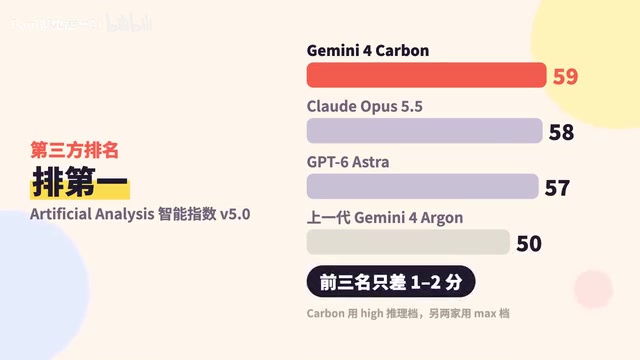
谷歌发布Gemini 4 Carbon,官方称其为迄今最强模型,距上个模型Argon仅两周。它在Artificial Analysis综合排名以59分居首,但领先Cloud Opus 5.5和GPT-6 Astra仅一两分,说明综合榜单已难拉开代际差距。差异化落在网络安全:自测找漏洞八成八、验证可利用性五成五、打补丁七成,并称可连续运行数天排查深层bug。首发仅开放给部分网络安全防守方,开发者和普通用户时间未定。定价与Argon持平,每百万Token输入2美元、输出10美元。幻觉问题出现两套口径:谷歌自测无根据说法减半,第三方测不会硬编比例从4%升至11%,但仍为第二低。
谷歌刚刚发布了Gemini 4 Carbon,官方称这是其迄今为止最强的模型。距离上一个模型Argon发布仅过去两周,这种迭代节奏本身就是一个信号:大模型竞赛已经进入白热化阶段,而谷歌选择了一条与以往不同的路线——把最强能力优先交付给网络安全防守方。
排名第一,但优势微弱
在第三方机构Artificial Analysis的综合排名中,Gemini 4 Carbon拿到59分位列第一。这个成绩值得肯定,但差距并不悬殊:第二名Cloud Opus 5.5是58分,GPT-6 Astra是57分。头部模型之间的分差只有一两分,说明单看综合榜单已经很难拉开代际差距,真正的差异化要落到具体场景里。
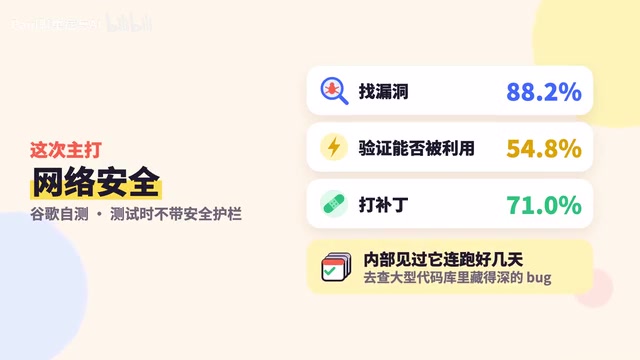
Gemini 4 Carbon这次的差异化抓手是网络安全。谷歌公布的自测数据显示,模型在找漏洞任务上得分八成八,验证漏洞能否被利用为五成五,打补丁为七成。三项能力对应的是安全工作的完整链路:发现问题、判断威胁真实性、给出修复方案。前两项的分数落差也说明,验证漏洞可利用性比单纯发现漏洞要难得多。
连续跑几天查深藏bug:能力展示还是真实需求?
谷歌提到,内部见过这个模型连续运行好几天,去排查大型代码库里藏得很深的bug。这个描述值得琢磨。传统安全审计受限于人力,很难对超大规模代码库做长时间、持续性的深度扫描,而模型如果能稳定运行数天并保持上下文连贯,确实对应了一类此前难以自动化的工作。
当然,这类案例来自谷歌内部观察,属于单一来源的能力声明,外部还缺少独立复现。它的实际价值要等安全团队真正用起来才能验证。
长时程自主运行指的是模型在无人持续干预的情况下,长时间连续执行任务并保持目标、上下文和中间状态的一致性。它与普通对话式调用的关键差别在于:需要抵抗上下文漂移、错误累积和早期判断的固化,还要具备自我检查与回溯能力。在代码安全审计中,这意味着模型能反复追踪调用链、逐个排除假设,而不是一次性给出猜测性结论。这类能力对记忆管理、工具调用稳定性和成本控制都提出很高要求,也是当前评测体系较少覆盖的维度,因此外部很难仅凭榜单分数判断其真实水平。
先用不了:分阶段开放的逻辑
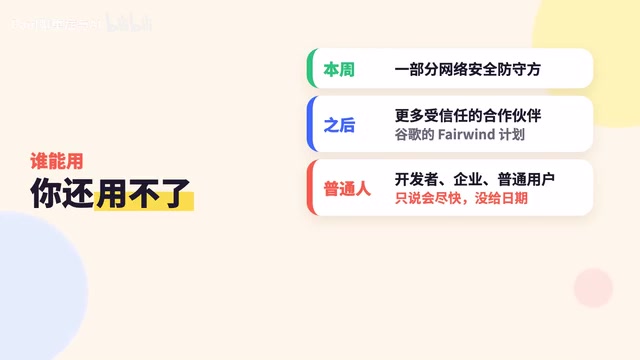
目前普通用户和开发者还无法使用Gemini 4 Carbon。这周只开放给一部分网络安全防守方,之后再逐步放给受信任的合作伙伴、开发者和普通用户,谷歌只说“尽快”,没有给出具体日期。
把最强模型优先交给防守方,是一个有意的策略选择。安全领域的攻防不对称性极强,攻击方只需找到一个入口,防守方却要覆盖所有面。让防守方先用上更强的检测与修复能力,在伦理和公共安全叙事上都站得住脚。但从产品角度看,这种“看得到吃不到”的状态也难免让开发者和普通用户觉得吊胃口。稳妥与掉胃口之间,谷歌显然选择了前者。
**分阶段放量(staged rollout)**是大模型厂商近年常用的交付方式:先向特定高风险或高价值场景的受信任用户开放,收集真实环境下的滥用模式、失败案例和安全事件,再逐级扩大范围。对网络安全这类双用途能力尤其如此——同一套漏洞发现与利用验证能力,既能用于防御,也可能被用于攻击。因此厂商往往需要配套身份核验、使用监控和滥用检测机制。这种节奏会拉长开发者等待周期,但也是能力越强、治理成本越高的直接体现。
定价持平,幻觉问题两套说法
价格方面,Gemini 4 Carbon的首发价与Argon一致:每百万Token输入2美元,输出10美元。在能力提升的前提下维持原价,对准备接入的企业客户算是友好信号。
围绕幻觉问题,出现了两套并不完全一致的测试结论。谷歌自测显示,模型没根据的说法比Argon少了一半,进步明显。但第三方测试给出了另一个角度:模型在不会的问题上强行编造答案的比例从4%涨到11%。不过即便上升,这个比例在所有模型中仍是第二低。
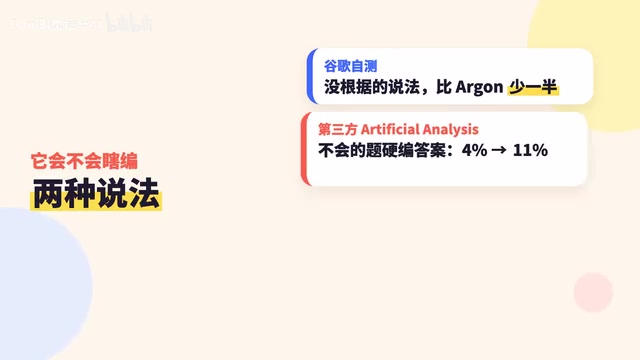
两组数据并不矛盾,只是衡量口径不同:一个看的是整体无根据陈述的减少,一个看的是“不会硬编”这一特定行为的比例。对实际使用者来说,后者的参考价值更直接——模型在能力边界之外是否诚实,往往比平均幻觉率更影响信任。比例上升但仍处低位,说明这个问题在可控范围内,并非可以忽略。
幻觉率的口径差异是解读这类数据时最容易踩坑的地方。整体无根据陈述比例统计的是模型所有输出中与事实不符或缺乏依据的内容占比;而“不会硬编”比例只聚焦模型遇到超出知识或能力边界的问题时,选择编造而非承认不确定的比率。前者会被任务难度、提问分布显著影响,后者更接近一种行为倾向指标。两者可以同时出现“整体变好、边界行为变差”的组合,因此把自测与第三方结果并置阅读,比单独引用任一数字更能反映模型在真实使用中的可信度。
值得关注的三个判断
第一,头部模型的综合分差已经压缩到一两分,榜单排名的参考价值在下降,场景化能力才是接下来的竞争焦点。第二,安全优先的发布策略意味着模型能力越强,交付节奏越可能受信任与合规约束,开发者需要习惯这种分层放量。第三,幻觉指标的解读要看清口径,自测与第三方测试的结论需要并置来看,单一数字容易误导。
Gemini 4 Carbon能否兑现“最强”标签,最终取决于安全团队的真实使用反馈,以及后续向开发者开放后的表现。
相关推荐

大模型应用开发:普通人的高薪入行指南
大模型应用开发岗位应届生薪资高达3万5,SP Offer可达60万,且不看出身。本文解析这一高薪岗位的核心能力、入行方法,并分享普通人如何通过“干中学”抓住AI时代机遇。

告别AI网红脸:零基础漫剧视觉资产制作全攻略
B站UP主分享零基础AI漫剧视觉资产制作全流程:用豆包工作skill通过剧本先行、视觉参考、注入活人感三种方法摆脱AI网红脸,再用资产版排版、武器细节图、场景九宫格和电影色版锁定角色与场景一致性。

好视频背后的AI制作流程:从调研到智能体验证
AI视频制作不只是模型竞赛。本文拆解一套可迁移的四步流水线:调研专业流程、整理技能清单、配置智能体、实验验证,并说明如何用DeepSeek等通用大模型替代付费工具跑通全流程。