谷歌发布前沿模型Gemini 4 Argon:先向政府与网络防御者开放

谷歌发布前沿模型Gemini 4 Argon,率先通过Fairwind Program向政府与网络防御者开放,体现"防御先行"的安全发布策略。
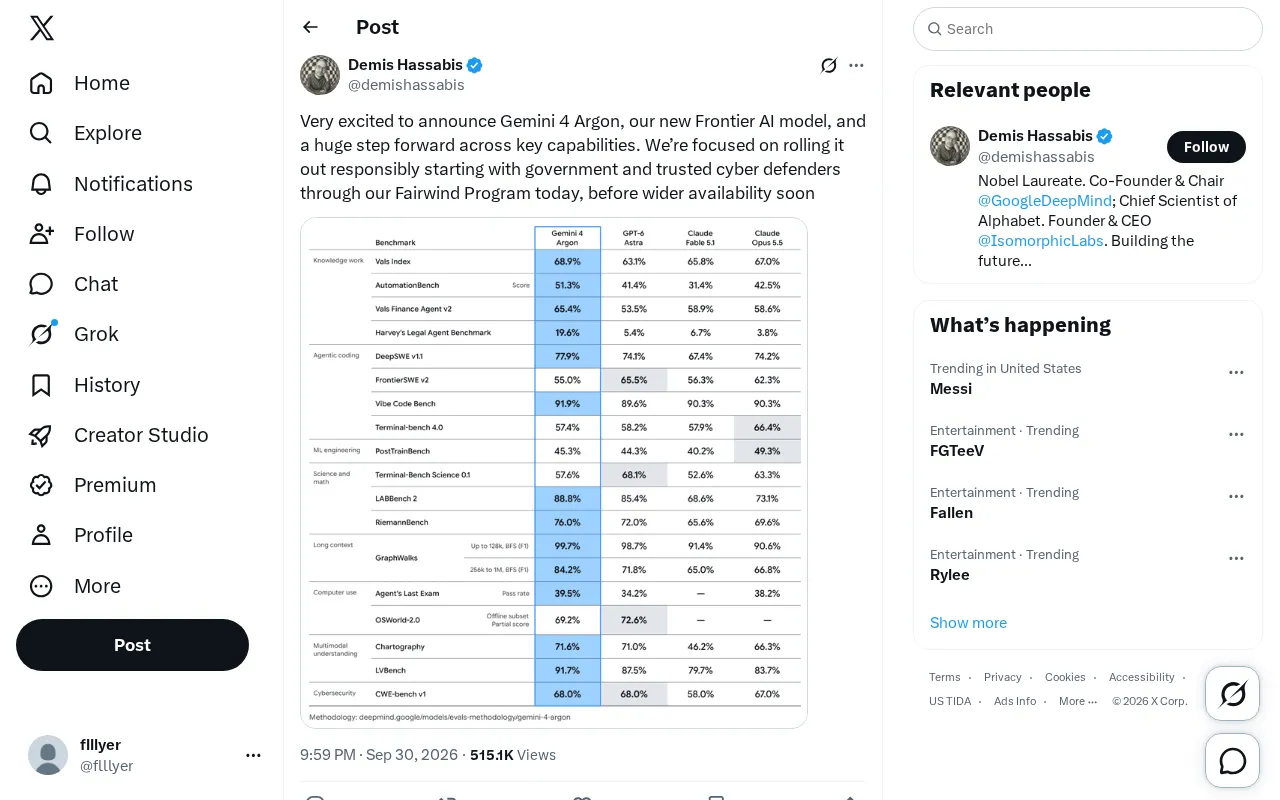
谷歌宣布推出新一代前沿AI模型Gemini 4 Argon,声称在多项关键能力上实现大幅提升。与以往直接面向开发者开放的做法不同,该模型将首先通过Fairwind Program面向政府机构和"受信任的网络防御者"定向开放,之后才会扩大至更广泛的用户群体。谷歌将这一策略定位为"负责任地推出",其核心逻辑是:让守方率先掌握更先进的AI工具,在能力扩散前建立防御优势。目前官方尚未披露具体的基准测试成绩、参数规模或与前代模型的量化对比,外界对其实际能力的判断仍需等待更多技术细节与第三方评测。
谷歌宣布Gemini 4 Argon
谷歌在社交平台上宣布推出全新前沿AI模型 Gemini 4 Argon,称其在多项关键能力上实现了"巨大飞跃"。官方强调这是继 Gemini 系列后又一次重要的能力升级,定位为"Frontier AI model"(前沿级AI模型),意味着它代表了谷歌当前模型能力的最高水平。
从公开信息来看,谷歌这次选择了一条相对谨慎的发布路径。与以往新模型直接面向开发者或消费者开放不同,Gemini 4 Argon 将优先通过名为 Fairwind Program 的计划,面向政府机构和"受信任的网络防御者"(trusted cyber defenders)开放,之后才会逐步扩大可用范围。
为什么优先面向政府和网络防御者
谷歌在声明中反复强调"负责任地推出"(rolling it out responsibly)这一理念。选择政府机构和网络安全防御者作为首批用户,释放出几个值得关注的信号。
一方面,前沿模型能力越强,潜在的滥用风险也越高。尤其在网络安全领域,强大的AI既可以用于防御,也可能被用于攻击。谷歌通过 Fairwind Program 先向可信的防御方开放,实际上是在构建一道"防御先行"的护城河——让守方先掌握更先进的工具,再逐步放开给更广泛的群体。
另一方面,这种分阶段、分人群的发布策略,也反映了当前头部AI厂商在安全治理上的普遍趋势:在模型达到新的能力阈值时,先进行有限范围的受控部署,观察实际表现与风险,再决定是否大规模推广。
在网络安全领域,AI能力的"攻防不对称"问题长期存在:攻击者只需找到一个漏洞即可得手,而防御者需要覆盖所有可能的攻击面。强大的AI模型可以辅助防御方完成漏洞扫描、威胁情报分析、恶意代码识别等高强度任务,显著降低人力成本;但同样的能力若被恶意行为者掌握,也可自动化生成钓鱼内容、编写漏洞利用代码或绕过安全检测。这正是谷歌等前沿实验室在安全评估框架中通常单独列出"网络攻击能力"(Cyber Offense Capability)作为高风险维度的原因。让守方率先获得工具,在理论上有助于在新模型能力扩散之前,先建立起相应的防御基础设施与检测机制。
Fairwind Program 的意义
虽然官方信息中对 Fairwind Program 的具体机制着墨不多,但从命名和定位可以推断,这是谷歌为前沿模型设计的一套受控准入框架。它把"网络防御者"这一群体明确列为优先对象,说明谷歌希望把 Gemini 4 Argon 的首批价值锚定在安全防护场景。
这种做法与行业内关于"AI安全与能力平衡"的讨论高度契合。当模型能力逼近或突破某些临界点时,如何在释放商业与社会价值的同时控制风险,成为所有前沿实验室必须回答的问题。谷歌用 Fairwind 给出的答案是:先给可信的防御方,再谈普及。
类似的受控准入机制在AI行业并非孤例。OpenAI曾为GPT-4等高能力模型设立"红队测试"(Red Teaming)阶段,邀请安全研究人员在公开发布前进行对抗性评估;Anthropic则通过"负责任扩展政策"(Responsible Scaling Policy)设定能力阈值,规定模型达到特定危险能力时必须触发更严格的部署限制。谷歌的Fairwind Program在逻辑上与这些机制相似,但它更明确地将"首批用户"界定为政府与网络防御者,而非内部研究人员或第三方安全专家,这一定位使其兼具风险评估与实战部署的双重属性。值得注意的是,"Fairwind"(顺风)这一命名本身带有航海隐喻,暗示谷歌希望为受信任方提供一种"有利条件优先"的通道,这与其一贯的企业级安全合作叙事逻辑一致。
对行业的潜在影响
从产品节奏看,Gemini 4 Argon 的发布意味着谷歌在前沿模型竞赛中继续加码。命名上以"4"标识代际跃迁,以"Argon"作为代号,暗示这可能是一个独立的高能力变体,而非简单的小版本迭代。
对企业和开发者而言,更值得关注的是"wider availability soon"(即将更广泛开放)这一表述。它意味着普通用户和开发者需要等待受控阶段结束后才能接触到这一模型。短期内,这款模型的实际能力表现主要由政府和安全机构验证,外界较难获得第一手评测。
需要说明的是,目前公开的信息量相对有限,官方并未披露具体的基准测试成绩、参数规模或与前代模型的量化对比。关于"关键能力的巨大飞跃"究竟体现在哪些维度——是推理、代码、多模态还是安全对齐——仍有待后续更详细的技术说明。
小结
Gemini 4 Argon 代表了谷歌在前沿AI能力上的又一次推进,但更具标志性的是其发布方式:以安全和负责任为核心,优先服务政府与网络防御者,再逐步向大众开放。这种"防御先行、分阶段放开"的策略,可能会成为未来高能力模型发布的一种范式。在更完整的技术细节与第三方评测出现之前,对其具体能力的判断还需保持审慎。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。