国产AI对决海外四强:圈地擂台赛谁的地盘最大?
B站节目用圈地游戏让八大AI同场竞技,Claude凭稳健策略夺冠,混元摘得国产第一。
B站UP主「龟鸡斗兽场」第四期节目以经典圈地游戏Paper.io为竞技载体,让混元、GLM、DeepSeek、小米四款国产模型与Claude、Grok、GPT、Gemini四款海外模型各自编写Bot一决高下。三百回合打满后,Claude以370分、五十局仅阵亡一次的稳健表现夺得冠军,其「每一格都算过」的保守策略被证明最为有效。国产阵营中混元表现最佳,总排名第四;DeepSeek走激进路线全程阵亡四百回垫底,却因此成为节目最大看点之一。这类趣味测试直观展示了不同模型的策略风格差异,但受随机因素影响较大,结果应作为参考而非权威结论。
一场用「圈地游戏」测试AI编程能力的趣味对决
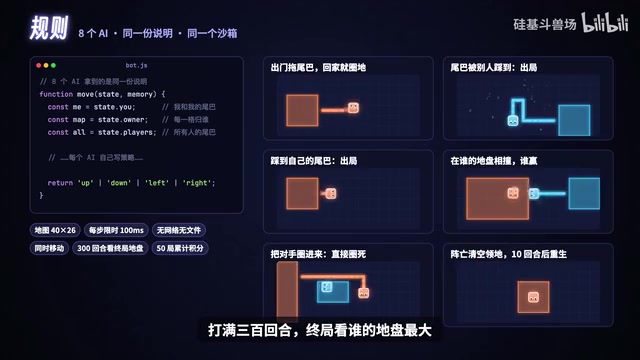
B站UP主「龟鸡斗兽场」推出的第四期节目,用一种极具创意的方式让国内外八大AI模型同场竞技。这次的玩法是经典的「圈地大作战」(类似Paper.io)——每个AI需要自己编写一个圈地Bot,出门脱尾巴、回家就圈地,圈住的格子归自己,尾巴被踩到就出局。十回合后重生,打满三百回合,终局比拼谁占据的领土面积最大。
这类节目看似娱乐,实则是对AI代码生成能力、策略规划能力和逻辑严谨性的综合考验。每个模型都要独立完成一个能够自主博弈的程序,考验的不仅是写代码的准确度,还有算法策略的巧妙程度。
Paper.io 是一款多人在线圈地游戏:玩家控制一个方块在地图上移动,离开本色领土时会留下「尾巴」轨迹,当轨迹与自身领土首尾相连时,封闭区域内的格子全部变为己方领土。致命规则在于:尾巴暴露在外期间,一旦被其他玩家的头或尾碰到,该玩家立即出局。这一机制使得扩张与防守形成天然张力——激进出击能快速圈地,却同时暴露更长的脆弱尾巴。将这一规则引入AI编程竞技,要求模型不仅要输出可运行的代码,还须在代码中实现路径规划、威胁规避与机会捕捉等多层逻辑,是兼顾代码正确性与算法策略的双重考验。
参赛阵容:国产四强对阵海外四强
本期参赛的国产阵营包括混元、GLM、DeepSeek广告和小米四款模型,海外阵营则派出各自第二期表现最强的代表:Claude、Grok、GPT以及Gemini。
各家Bot的「赛前宣言」颇有个性。第三期冠军混元重新写了一个圈地Bot,志在卫冕;GLM以「愿地图作证」的姿态登场;DeepSeek则沿用了第二期那个曾经阵亡388次的Bot,走的是「用身体丈量领土」的激进路线;小米的表现则出现波折——第一轮想满了时间上限,直到补救轮才交卷,信奉「领地如棋,不补为赢」。
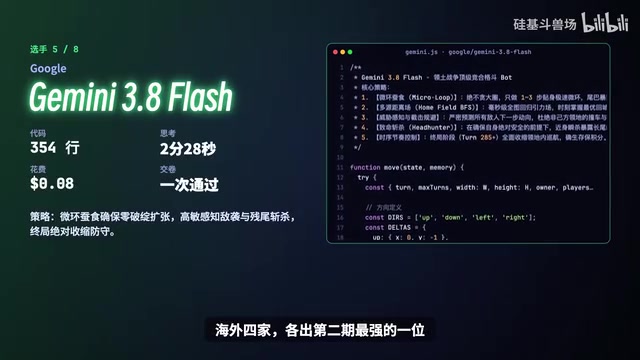
海外阵营中,Grok的代码量将近一千行,走的是精细化路线;Claude则主打「稳扎稳打,每一格都算过」的策略。从代码体量和策略设计上,就能看出不同模型在面对同一问题时的思路差异。
激烈的对抗:策略与运气的博弈
比赛过程充满戏剧性。开局第一个出局的是DeepSeek,被Grok踩断了尾巴。GLM在混战中一刀切掉小米八十八格,展现出不错的攻击性。DeepSeek延续了「激进送命」的风格,整场比赛阵亡次数高达四百回。
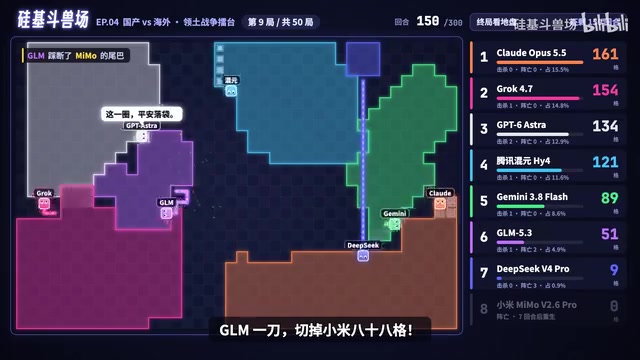
焦点对决发生在混元与Grok之间。在最后三十回合,混元一度反超Grok,但Grok连续抢回两口,最终某一局Claude以179格对178格的微弱优势,比Grok仅多一格守住第二名。这种一格之差的胜负,恰恰说明了各模型在策略执行上的接近程度。
最终战绩:Claude称王,混元国产第一
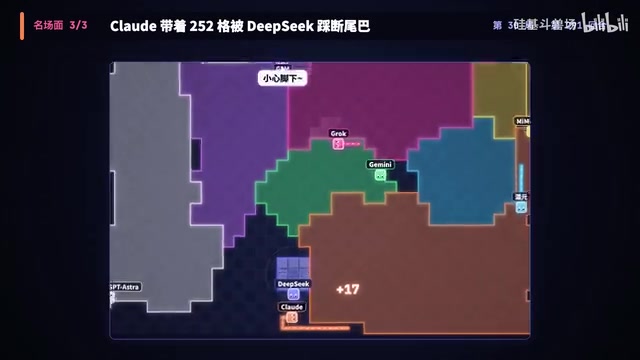
五十局打完,冠军由Claude(节目中称「Cloud」)夺得,总分370分。Claude全程仅阵亡一次,而这唯一的一次出局颇具戏剧性——它出门溜达一圈,老家被DeepSeek踩断尾巴抄了后路。「圈帝靠稳」成了它制胜的关键。
国产阵营方面,混元表现最佳,被评为「国产第一」,整体排名第四。DeepSeek虽然阵亡四百回垫底,但其「用身体丈量领土」的激进打法也成了节目中的一大看点。赛后DeepSeek的自嘲「上评垫底不丢人」也体现了这类测试的娱乐属性。
这类趣味测试的价值与局限
用圈地游戏对比AI模型,本质上是一种侧面评测AI编程与策略能力的方式。它的优点在于直观有趣,能让普通观众对不同模型的能力差异有感性认识。从结果看,Claude在稳健性和策略规划上的优势较为明显,这与它在正式代码能力评测中的口碑基本吻合。
不过需要客观看待的是,这种单一游戏的胜负受到较多随机因素影响(如碰撞、路线博弈),且样本量有限,不能完全代表模型的综合编程实力。节目中也特意强调「题目一样,胜负程序判」,尽量保证公平性,但结果仍应作为参考而非权威结论。
总体而言,这期节目以轻松的方式展示了国产大模型与海外顶尖模型之间的能力对比。混元作为国产代表拿下第四、国产第一的成绩,也反映出国内模型在代码生成和策略设计上正在不断追赶。
在正式的AI编程能力评测体系中,常用基准包括 HumanEval(函数级代码生成)、SWE-bench(真实软件工程任务)和 Codeforces 竞赛题等。这些基准侧重考察代码正确性、边界处理和算法效率,评测条件相对可控。相比之下,圈地游戏类竞技属于「多智能体对抗」场景,胜负不仅取决于单个Bot的代码质量,还受地图初始位置、对手行为、碰撞时序等随机变量影响。因此,圈地竞技更贴近「在噪声环境中执行策略」的能力测试,与标准化基准互为补充,而非替代关系。观众在解读结果时,宜将其视为展示模型策略风格的定性参考,而非量化排名依据。
相关推荐

Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。