国内用户实战:用DeepSeek驱动Codex的完整配置指南

OpenAI Codex国内使用指南:用DeepSeek替代ChatGPT的完整配置方案
OpenAI的Codex被越来越多开发者视为AI编程的必备工具。作为基于GPT系列模型专门针对代码生成场景深度微调的AI系统,Codex底层经过数十亿行开源代码的训练,覆盖Python、JavaScript、Go、Rust等数十种编程语言,能够将「用自然语言描述的需求」直接转化为可运行代码。
Codex的技术演进背景:Codex最初基于GPT-3架构,通过在GitHub上超过540万个公开代码仓库(约1540亿token的代码数据)上进行专项微调,使模型对编程语法、API调用模式和算法逻辑产生了远超通用语言模型的理解能力。这一微调过程的关键在于数据配比策略:研究团队将代码数据与自然语言数据按特定比例混合训练,既保留了模型理解自然语言需求描述的能力,又强化了对编程语言结构的掌握——这种「双语能力」正是Codex能够将自然语言转化为代码的根本原因。2023年后,随着GPT-4系列的发布,Codex的推理能力得到大幅跃升。GPT-4相比GPT-3在架构上引入了多模态感知能力和更长的上下文窗口(最高支持128K token),使其能够同时「看懂」更大规模的代码库,理解跨文件的依赖关系。与此同时,OpenAI逐步引入了「工具调用(Tool Use)」和「函数调用(Function Calling)」机制,使其从单纯的代码生成器进化为能够调用终端、读写文件、执行测试的自主代理。它最早以GitHub Copilot核心引擎的身份亮相,后演进为能够自主分解任务、执行终端命令、迭代修复错误的「自主编程代理(Coding Agent)」形态。
从「代码补全」到「自主编程代理」的跃升,背后是AI工程化能力的系统性突破。早期的GitHub Copilot本质上是一个「下一token预测」系统,根据上下文代码预测最可能的续写内容。而现代Coding Agent引入了ReAct(Reasoning + Acting)框架——这一框架由谷歌研究团队(Yao等人)于2022年在论文《ReAct: Synergizing Reasoning and Acting in Language Models》中正式提出,其学术贡献在于证明了将「推理轨迹」与「外部工具调用」交织执行能够显著减少幻觉并提升任务完成率。ReAct的核心思想是让模型在「思考(Thought)→行动(Action)→观察(Observation)」三个步骤之间循环迭代,每一步的输出都作为下一步的输入。在工程实现层面,「行动」步骤通常通过上文提到的「函数调用(Function Calling)」机制落地:模型输出一个结构化的JSON指令,外部执行器(如终端、文件系统、浏览器)解析并执行该指令,再将结果以文本形式返回给模型作为「观察」内容。在编程场景中,这意味着模型可以运行代码、观察报错信息、分析错误原因、修改代码、再次运行——形成真正意义上的「试错→修正」闭环,使AI能够处理涉及多文件修改、测试运行、错误调试的完整软件工程任务,而非仅仅生成片段代码。
SWE-bench(Software Engineering Benchmark)等评测集专门用于衡量模型在真实GitHub issue修复场景中的自主能力,已成为评估Coding Agent水平的核心基准。SWE-bench由普林斯顿大学和卡内基梅隆大学研究团队于2023年联合发布,其设计理念刻意回避了「手工构造」的测试题目,转而从Django、Flask、Scikit-learn等真实知名开源项目中抽取历史Issue和对应的修复Pull Request,确保每个测试用例都有明确的「正确答案」(即通过全部测试用例)且无法被模型「背题」。SWE-bench Verified是其精心人工标注的高质量子集,评测结果更具可信度,已被学界和工业界广泛采用为Coding Agent能力的标准度量衡。SWE-bench的测试用例来自真实的开源项目Issue,模型需要自主定位问题、修改代码、通过测试用例验证修复效果,与真实开发场景高度吻合。截至2025年,顶尖模型在SWE-bench Verified子集上的解决率已超过50%,而一年前这一数字还不到5%,折射出Coding Agent能力的爆炸式提升速度。
然而对国内用户而言,它有一道明显的门槛:官方默认需要ChatGPT Plus账号登录,网络环境和会员费用都成为障碍。本文将系统梳理一套「非官方但有效」的解决方案——借助第三方管理工具,用国产大模型DeepSeek广告作为Codex的底座,让没有ChatGPT账号的用户也能顺利上手。
两条路径:官方登录 vs 国产替代
在开始之前,需要明确两条完全不同的使用路径。
如果你已经拥有ChatGPT Plus账号,且网络环境允许,那么最简单的方式就是直接下载官方Codex,用ChatGPT账号登录即可,无需任何额外配置。这条路径最省心,海外用户或已有会员的用户建议直接采用。
但对大多数国内用户来说,账号、会员、网络三重限制往往同时存在。此时的替代方案是:安装原生Codex后,通过一个名为「Codex++管理工具」的第三方软件,修改其登录方式,将DeepSeek(或豆包等国产模型)配置为底层模型。
需要强调的是,这类第三方工具并不修改Codex的核心功能,仅仅改变了它的登录与模型接入方式。因此在功能体验上,与官方版本基本一致。
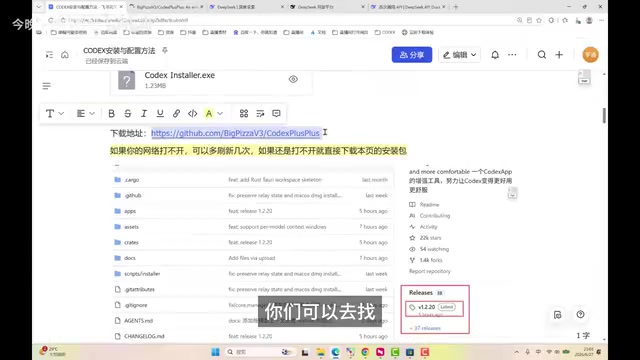
第一步:安装Codex与管理工具
整个流程需要下载两个软件。
第一个是原生Codex安装包。Windows用户可以直接打开系统「商店」,搜索「Codex」,找到应用后点击免费下载安装;Mac用户在App Store中操作方式相同。这是一个标准的在线安装过程,与安装其他软件无异。
关键提醒:安装完成后,千万不要直接打开Codex。 因为直接打开会默认要求使用ChatGPT登录,而这正是我们要绕开的环节。
第二个软件是「Codex++管理工具」。安装完成后,系统里会出现三个相关程序:Codex、Codex++、Codex++管理工具。这里必须选对——我们要打开的是「Codex++管理工具」,其他两个此阶段用不到。
Codex++管理工具的本质是一个「API代理层」,它在本地拦截Codex发出的网络请求,将原本指向OpenAI服务器的流量重定向到用户自定义的API端点。从技术实现角度看,这类工具通常以本地反向代理(Local Reverse Proxy)的形式运行:在本机监听一个固定端口,修改Codex的环境变量或配置文件,使其将API请求发往本地代理而非OpenAI官方地址;代理层再根据用户配置将请求转发至目标模型服务商,并在必要时对请求头(如Authorization字段中的API Key)进行替换。这类工具在技术社区中并不罕见,Ollama、LM Studio等工具也采用类似思路,让本地或第三方模型「伪装」成OpenAI兼容接口供其他软件调用。
关于OpenAI兼容协议:OpenAI兼容协议(OpenAI-compatible API)是当前AI生态中事实上的行业标准接口规范。该协议最初伴随2020年GPT-3 API公测而确立,其设计遵循RESTful架构风格,以简洁的HTTP请求封装了复杂的模型推理过程。协议定义了一套标准化的HTTP REST接口,包括/v1/chat/completions(对话补全)、/v1/completions(文本补全)、/v1/embeddings(向量嵌入)等核心端点,以及统一的请求/响应JSON格式——其中流式响应(Server-Sent Events)的设计使得模型输出能够实时逐字呈现,而非等待全部生成完毕后一次性返回,显著提升了用户体验。DeepSeek、通义千问广告、智谱AI、豆包等国产大模型均宣布兼容该协议,意味着所有基于OpenAI SDK开发的应用,只需更换Base URL和API Key,即可无缝切换到不同模型提供商,无需修改任何代码逻辑。
值得从更宏观的产业视角理解这一协议的影响:它形成了类似USB接口之于硬件生态的效应,上层应用只需对接一套标准,下层模型提供商通过兼容该协议即可获得海量应用的即时接入能力。对于新进入者而言,兼容OpenAI协议意味着无需说服开发者专门适配——从这个角度看,OpenAI真正的护城河或许不是模型本身,而是它率先确立的这套接口标准。这种协议标准化趋势极大降低了开发者的迁移成本,也是本文方案得以实现的根本技术前提。
使用时需注意:建议从官方渠道或开源仓库获取工具以确保来源可信,并定期轮换API Key防止泄露。
打开管理工具后界面功能繁多,但我们只需要用到其中一项:模型供应商配置。
第二步:配置DeepSeek作为底座模型
在管理工具左侧点击「模型供应商」或「供应商配置」,初始状态下通常只有一个默认项。接下来点击「添加供应商」,逐项填写以下信息:
基本信息填写
- 名称:可自定义,仅供自己识别,比如「我的DeepSeek」。
- 接入模式:务必选择「纯API」。这是整个配置的核心逻辑——API(Application Programming Interface,应用程序接口)是软件系统之间通信的标准协议。选择「纯API」意味着Codex不再通过账号体系向OpenAI请求算力,而是转向DeepSeek的API端点获取模型推理结果。理解这一逻辑后,用户面对任何支持OpenAI兼容协议的模型(如通义千问、豆包等)都可以用同样方式接入,学会一次举一反三。
- Base URL:填写
api.deepseek.com。Base URL是API请求的基础地址,相当于「服务器的门牌号」,建议直接复制粘贴,避免手动输入出错。
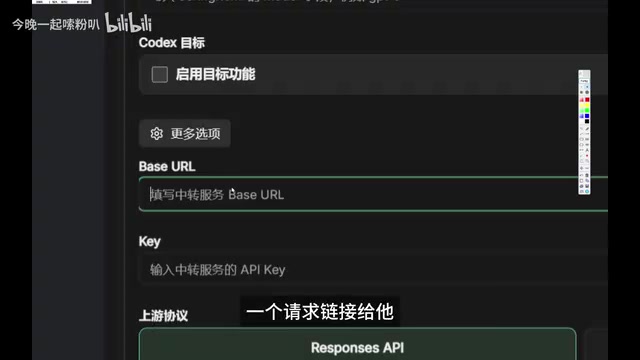
获取并填写DeepSeek API Key
API Key是身份令牌,相当于你DeepSeek账号的唯一身份标识,它证明是「你」在调用DeepSeek服务,相应的token消耗也计入你的账户。
API Key的安全管理:API Key的安全管理是开发者经常忽视但至关重要的环节。GitHub安全团队数据显示,每天有数以万计的密钥通过代码提交意外暴露在公开仓库中。从密钥泄露的典型途径看,最常见的是开发者在本地调试时将密钥硬编码写入源代码,随后不慎将其推送至公开仓库;另一类场景是将密钥写入日志文件,而日志文件被纳入版本控制。API Key本质上是一串随机生成的字符串令牌,与账号密码等价,一旦泄露,他人可直接以你的身份消耗账户余额。值得注意的是,GitHub等平台已部署自动密钥扫描机制(Secret Scanning),能够在检测到已知格式的API Key被推送时自动通知对应服务商——部分服务商在收到通知后会立即吊销泄露的密钥,但这一保护机制并非所有平台都支持。业界推荐的最佳实践包括:使用环境变量(.env文件)而非硬编码方式存储密钥;在代码仓库中配置.gitignore排除密钥文件;为API Key绑定IP白名单,限制只有特定IP才能使用该密钥;以及使用pre-commit钩子通过git-secrets等工具在提交前自动扫描密钥模式字符串。对于个人用户而言,至少应养成「一个项目一个密钥」和「设置消费上限」两个基本习惯,DeepSeek等平台均支持在创建密钥时同步配置每日或每月的消费上限,作为安全兜底措施。
在具体选择DeepSeek作为底座模型,除了接入便利性,还有一个核心理由:性价比。DeepSeek由幻方科技旗下团队发布,其V3版本采用混合专家架构(MoE),推理时只激活部分参数,大幅降低计算成本,API调用价格约为同级别GPT-4o的十分之一。
MoE架构解析:混合专家架构(Mixture of Experts,MoE)是近年来大语言模型领域的重要技术突破,其思想可追溯到1991年Jacobs等人提出的「专家混合」神经网络,但直到Google Brain团队2017年在《Outrageously Large Neural Networks》论文中将其与Transformer结合,才真正开启了MoE在现代大模型中的实用化进程。MoE的核心优势在于实现了「模型容量」与「推理计算量」的解耦:传统密集模型(Dense Model)在推理时会激活全部参数,而MoE架构将模型参数划分为多个「专家网络」(通常为独立的前馈神经网络FFN层),每次推理时由路由器(Router)动态选择少数几个专家参与计算,通常仅激活总参数量的10%-20%。路由器的训练目标是让不同专家自发形成功能专业化分工——例如某些专家擅长处理数学推理,另一些专家更擅长代码生成——尽管这种分工是隐性涌现的而非显式设计的。DeepSeek-V3拥有约6710亿总参数,但每次推理仅激活约370亿参数,在保持模型容量的同时大幅降低了单次推理的算力消耗。DeepSeek还在工程层面对专家负载均衡算法进行了深度优化,引入辅助损失函数约束路由器的选择行为,避免了早期MoE模型中部分专家过载、部分专家闲置的「专家坍塌」问题。类似的MoE思路也被Mistral(Mixtral系列)和Google(Gemini 1.5)所采用,代表着当前大模型效率优化的主流方向。
与此同时,DeepSeek在HumanEval、SWE-bench等主流编程能力评测集上的表现优异,是目前国内开放API中综合性价比最高的选择之一。
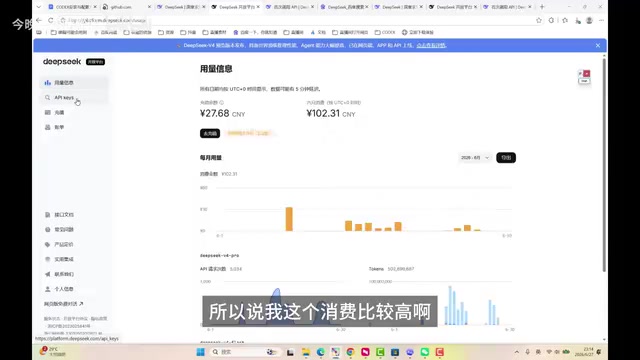
获取API Key的方式:打开DeepSeek官网,进入「API开放平台」,在「API Keys」页面点击「创建」。特别注意:新创建的密钥只会完整显示一次,务必立即复制保存到本地文件或记事本中。 一旦关闭页面,就无法再次查看,只能重新创建。
将复制好的API Key粘贴到管理工具对应字段,协议选项选择右侧默认选项,然后点击「从上游获取」。如果配置正确,系统会自动抓取到DeepSeek当前开放的模型列表。
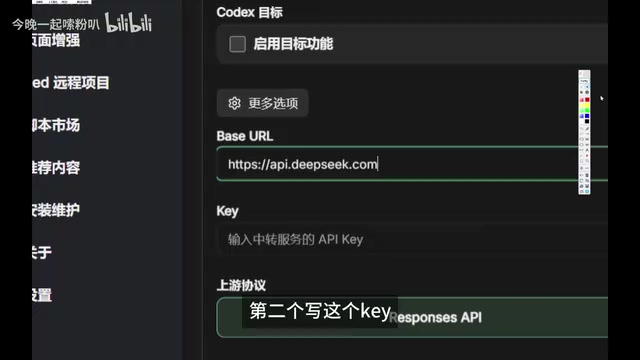
能成功抓取到模型列表,就说明Base URL和API Key均配置正确。此时向上滚动找到「保存」按钮并保存。保存后供应商列表中会出现你刚才添加的项,将鼠标移到右侧点击「使用」,状态显示「使用中」即代表切换成功。
第三步:账户充值与启动Codex
配置完成不代表可以立即运行,还需要确保DeepSeek账户里有余额,否则模型无法真正调用。
在DeepSeek的充值页面充值即可。根据实际使用经验,DeepSeek的调用价格极为亲民——即便全天高频运行多个任务,一个月费用也仅在百元左右。对于普通学习者而言,充值10元基本足够完成大部分入门练习。理解DeepSeek定价的底层逻辑有助于合理规划预算:其API按token计费,输入token(即你发送给模型的内容,包括代码上下文和指令)和输出token(模型生成的回复内容)分别计价,其中输出token单价通常高于输入token。Coding Agent场景下,由于模型需要多轮迭代(每轮都要重新发送完整上下文),实际消耗的token量可能远超单次对话,这也是建议设置消费上限的重要原因。
通过管理工具正确启动Codex
充值完成后,回到管理工具右上角,点击「重启Codex++」。再次强调:一定要通过管理工具启动,而不是直接打开Codex本体,只有这样才能使模型替换配置生效。
启动后会弹出登录选项:
- 第一个选项是「使用ChatGPT登录」——不要选;
- 第二个选项是「使用其他方式登录」——选这个。
点击后,界面会要求输入OpenAI的API Key,此处将你之前保存的DeepSeek API Key粘贴进去,点击「继续」即可。首次登录需要稍等片刻。
进入主界面后,检查右下角的模型选择菜单,确认能选中你配置的DeepSeek模型(如DeepSeek V3 Pro)。建议优先选择Pro版本,综合效果更佳。至此,整套配置正式完成。
值得关注的趋势与思考
这套方案本质上是一种「桥接」方案——用OpenAI工具的外壳,套上国产模型的内核。它切实解决了国内用户当下面临的现实痛点,但也存在依赖第三方工具稳定性的潜在风险:若上游Codex版本更新导致接口变化,工具可能出现短暂兼容性问题,这是使用任何第三方桥接工具都需要接受的现实。
从更宏观的视角看,这套方案也折射出AI编程工具的行业演进趋势。从GitHub Copilot到Cursor、Windsurf、Codex,编程工具在2023-2025年间经历了从「代码补全」到「自主编程代理」的代际跃升。值得注意的是,这场跃升背后存在明显的「工具层竞争」逻辑:在底层模型能力趋于同质化的背景下,工具层的差异化竞争愈发重要——Cursor凭借对话式代码编辑体验、Windsurf凭借「代码库感知」能力、Codex凭借与OpenAI生态的深度整合,各自形成了差异化定位。与此同时,多模型生态的形成推动工具层逐渐走向「模型无关化」——工具本身专注提供工作流和交互界面,底层模型由用户自由选配。这一趋势的技术基础,正是OpenAI兼容协议的广泛普及:当DeepSeek、豆包、通义千问等国产模型全面兼容同一套接口标准后,工具与模型之间的耦合被彻底解开,用户得以像更换电池一样自由切换底层引擎。
Codex官方团队已释放出后续将原生支持第三方大模型接入的信号,正是顺应这一趋势的必然选择。一旦官方落地这一功能,用户将无需借助Codex++等工具,即可直接配置DeepSeek、豆包等国产模型,国内用户的使用门槛将进一步降低。
对于非开发者而言,这套流程最大的价值在于——它证明了AI编程工具的使用门槛正在快速下降。掌握「API接入」这一核心逻辑后,无论后续想接入哪家模型、更换哪个工具,方法都是相通的。学会一次,便能举一反三。
核心要点
- 两条路径:有ChatGPT Plus账号直接用官方版;无账号则通过Codex++管理工具接入DeepSeek
- 核心逻辑:OpenAI兼容协议让不同模型可以无缝替换,只需更换Base URL和API Key
- DeepSeek优势:MoE架构大幅降低推理成本,API价格约为GPT-4o的十分之一,编程评测表现优异
- 安全提醒:API Key仅显示一次,需立即保存;建议设置消费上限并考虑绑定IP白名单防止意外超支
- 启动顺序:必须通过Codex++管理工具启动,切勿直接打开Codex本体
相关推荐

Anthropic IPO招股书拆解:163亿营收与807亿亏损的真相
Anthropic IPO招股书显示半年营收163亿美元、净亏损807亿美元,但其中724亿为会计调整,核心经营亏损仅6.93亿美元且同比收窄。本文拆解算力承诺、创始人控制权等三大关键事实。

Anthropic IPO招股书拆解:807亿亏损背后的真相与锁定期陷阱
Anthropic 递交 S-1 拟登陆纳斯达克,六个月净亏损 807 亿美元背后约 720 亿为会计费用。本文拆解招股书五个必读章节、稀释机制、发行价如何确定,以及锁定期到期为何可能砸盘。

Anthropic递交IPO申请:163亿美元营收与807亿亏损真相
Anthropic向SEC提交S-1文件申请纳斯达克上市,代码ANT。半年营收163亿美元同比增长约1300%,807亿净亏损中约724亿为非现金费用。解读这份IPO文件背后的真实经营状况。