海盗式抢救:拯救濒临删除的开源LLM模型
开源LLM模型面临被删除的风险,社区"海盗式抢救"行为折射出数字保存与版权合规之间的深层张力。
本文围绕Hacker News上一则关于"海盗式抢救即将被删除LLM模型"的帖子展开讨论,揭示了开源AI生态中一个日益紧迫的问题:托管在Hugging Face等平台上的开源大语言模型权重,可能因版权争议、许可证变更或发布者主动清理而永久消失。由于重新训练等价模型的成本极高,社区中自发形成了在模型下架前抢先镜像与再分发的"数字保存"行为,精神上与互联网档案馆一脉相承,但却游走在许可证与版权的灰色地带。文章指出,这一现象背后是"知识可及性"诉求与版权合规之间的结构性矛盾,并建议开发者建立本地备份、审慎对待许可证条款,同时关注基于IPFS等技术的去中心化归档方案,以应对单一平台托管带来的单点故障风险。
一场关于开源模型存续的讨论
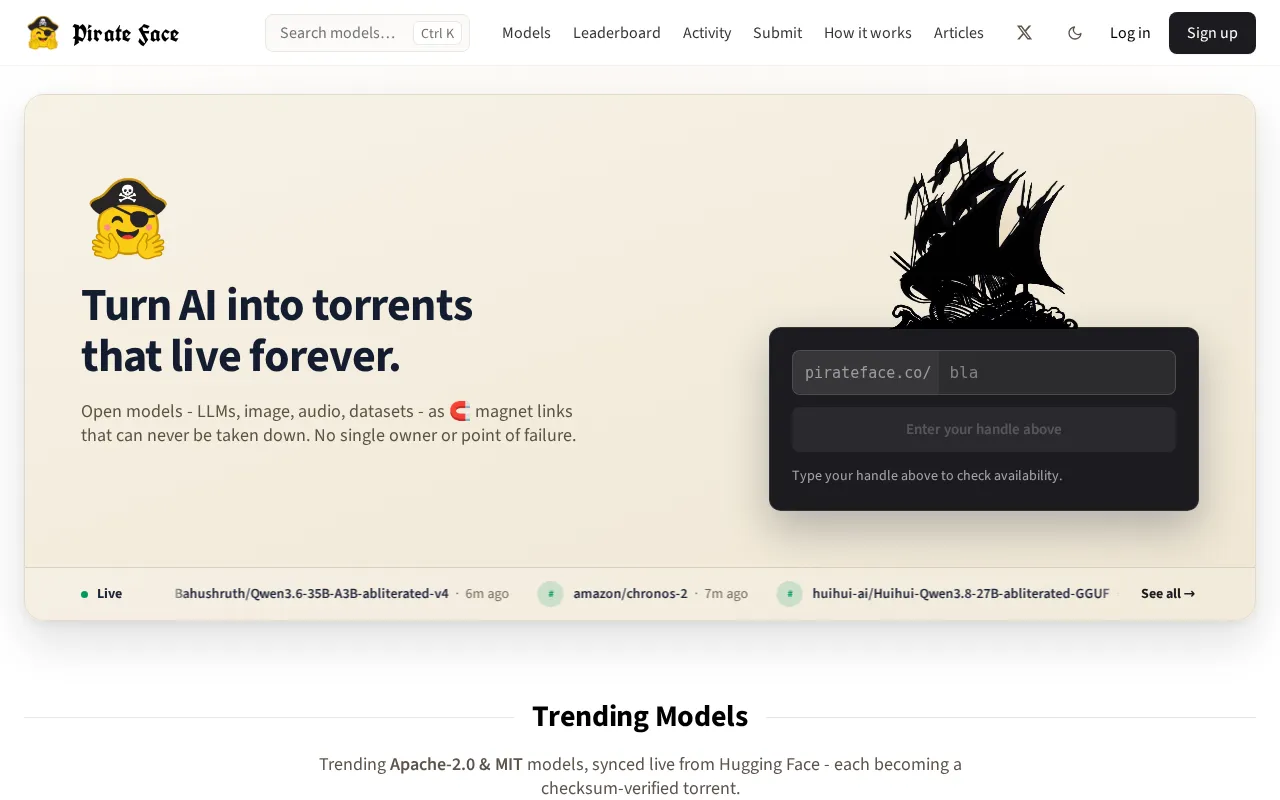
近期在 Hacker News 上出现了一个引人关注的话题——《Pirate Face Rescues LLM Models from Deletion》(海盗式抢救即将被删除的LLM模型)。尽管这条帖子目前的讨论量有限(9个点赞、1条评论),但它触及了一个在AI开源社区日益重要的议题:当托管平台上的模型面临下架或删除时,我们该如何保存这些公共知识资产?
开源大语言模型(LLM)近年来呈爆发式增长,Hugging Face 等平台成为模型分发的主要枢纽。然而,模型并非永久存在——发布者可能因合规、版权、许可争议或单纯的存储成本考量而删除已发布的权重文件。一旦删除,依赖这些模型的研究者、开发者和下游应用便可能陷入困境。
为什么模型会被删除
开源模型下架的原因多种多样。部分模型因训练数据涉及版权争议被要求撤下;部分因许可证条款变更而无法继续公开分发;还有一些则是发布者主动清理旧版本或整个账户注销所致。
对于社区而言,这带来了一个现实问题:已经被广泛引用、微调和部署的模型,一旦消失便难以复现。 训练一个大模型的成本极高,普通用户几乎不可能重新训练出等价的权重。因此,及时的镜像与归档就显得尤为关键。
从技术层面看,大语言模型的"权重文件"(weights)是模型训练结果的核心载体,通常以数十GB甚至数百GB的二进制文件形式存储。以LLaMA 2(70B参数版本)为例,其完整权重约达130GB;Stable Diffusion等多模态模型的权重同样动辄数GB。Hugging Face 作为目前最主流的模型托管平台,为发布者提供免费存储空间,但随着模型数量爆炸式增长,存储成本压力日益凸显。对于没有持续维护意愿的个人发布者或小型团队,注销账号或清理仓库是极为普遍的操作。与代码仓库不同,模型权重无法像源代码那样被轻松"重新编译"还原——训练一个同等规模的替代模型,往往需要数百万美元的算力投入,这使得"删除即永久丢失"的风险比软件领域严重得多。
"海盗式抢救"意味着什么
帖子标题中的"Pirate Face"(海盗形象)带有一定的调侃意味,指的是社区中自发形成的、类似数字保存运动的行为——在模型被正式删除之前,将其权重文件下载、镜像并重新分发到其他存储渠道。
这种做法在精神上与互联网档案馆(Internet Archive)以及各类数据保存项目一脉相承:面对可能永久消失的公共数字资产,社区选择主动介入进行备份。 只是在LLM语境下,这类抢救往往游走在许可证与版权的灰色地带,因而被冠以"海盗"之名。
值得探讨的是,这类行为背后反映的是开源社区对"知识可及性"的强烈诉求。当一个模型已经成为学术论文的复现基准或商业产品的底层组件,它的突然消失会造成连锁影响。
归档与版权之间的张力
这一话题真正的复杂性在于保存与合规之间的矛盾。一方面,从数字保存的角度看,抢救即将消失的模型有其正当性——这与图书馆保存绝版书籍的逻辑类似。另一方面,如果模型因版权或合规原因被删除,重新分发可能构成对原始限制的规避。
对开源社区来说,这提出了几个需要长期思考的问题:
- 谁应该负责维护开源模型的长期可用性?
- 分布式、去中心化的模型存储是否是一种可行的解决方案?
- 在尊重许可证的前提下,如何建立正规的模型归档机制?
现行的模型许可证体系加剧了这一矛盾。Meta的LLaMA系列采用自定义社区许可证,明确禁止未授权的再分发;Mistral、Falcon等模型则采用Apache 2.0或MIT等宽松许可证,允许修改和再分发。然而,即便是宽松许可证下的模型,其训练数据若涉及受版权保护的内容,权重文件本身是否构成"衍生作品"仍是法律上的未解问题。美国版权法对此尚无明确判例,欧盟AI法案亦未直接规范模型归档行为。互联网档案馆(Internet Archive)在保存网页内容时已多次面临版权诉讼,这一前车之鉴使得LLM归档项目在法律层面更加谨慎。部分社区项目(如TheBloke在Hugging Face上的大规模模型镜像工作)通过仅托管许可证明确允许再分发的模型来规避风险,但这一做法无法覆盖所有面临删除威胁的模型。
对开发者的启示
对于依赖开源模型的团队而言,这个话题提供了几点实用提醒:
不要假设线上模型永远可用。 对于生产环境中关键依赖的模型权重,应当建立本地备份或私有镜像,避免因上游删除而中断服务。
关注许可证条款。 在使用和再分发模型前,明确其许可范围,避免在"抢救"过程中引入法律风险。
支持去中心化存储的探索。 随着模型数量增长,单一平台的中心化托管存在单点故障风险,社区级的分布式归档方案值得关注。
在去中心化存储方向上,目前已有若干技术方案进入实践阶段。IPFS(星际文件系统)通过内容寻址和分布式节点存储文件,理论上可实现模型权重的去中心化托管;Filecoin则在IPFS基础上引入经济激励机制,鼓励节点长期保存数据。针对AI模型的专项归档项目也已出现,例如 eye.ai 等平台尝试建立模型的持久化存档。然而,受限于大文件传输速度、节点激励可持续性以及内容审核缺失等问题,这些方案目前尚未成为主流。对于企业级用户,更务实的选择是结合对象存储服务(如AWS S3、Cloudflare R2)建立私有镜像仓库,并将模型哈希值(如SHA-256)记录在案,以便日后验证完整性。
结语
虽然这条 Hacker News 帖子本身讨论有限,但它折射出开源AI生态中一个真实且日益紧迫的问题:在快速迭代的模型世界里,如何确保有价值的公共资产不会悄然消失。 "海盗式抢救"或许只是权宜之计,但它提醒我们,构建更加健壮、合规且去中心化的模型保存机制,已经成为开源社区无法回避的课题。
相关推荐
Claude Agent SDK实战:一步步搭建你的首个AI代理
基于Claude Agent SDK的完整实战教程:从环境配置、代理循环原理、权限模式选择到自定义工具与MCP集成,并用三层防护(最小权限、deny规则、pre-tool-use hook)挡住提示注入,最后设置轮次与预算上限控制成本。
MCP协议详解:从N×M到N+M的AI集成革命
MCP(Model Context Protocol)是什么?本文用USB-C类比讲清MCP协议原理,拆解Host/Client/Server架构、Tools/Resources/Prompts三大构建块、stdio与SSE传输方式,并对比Function Calling与LangChain Tool,附Python实现与生产实践建议。
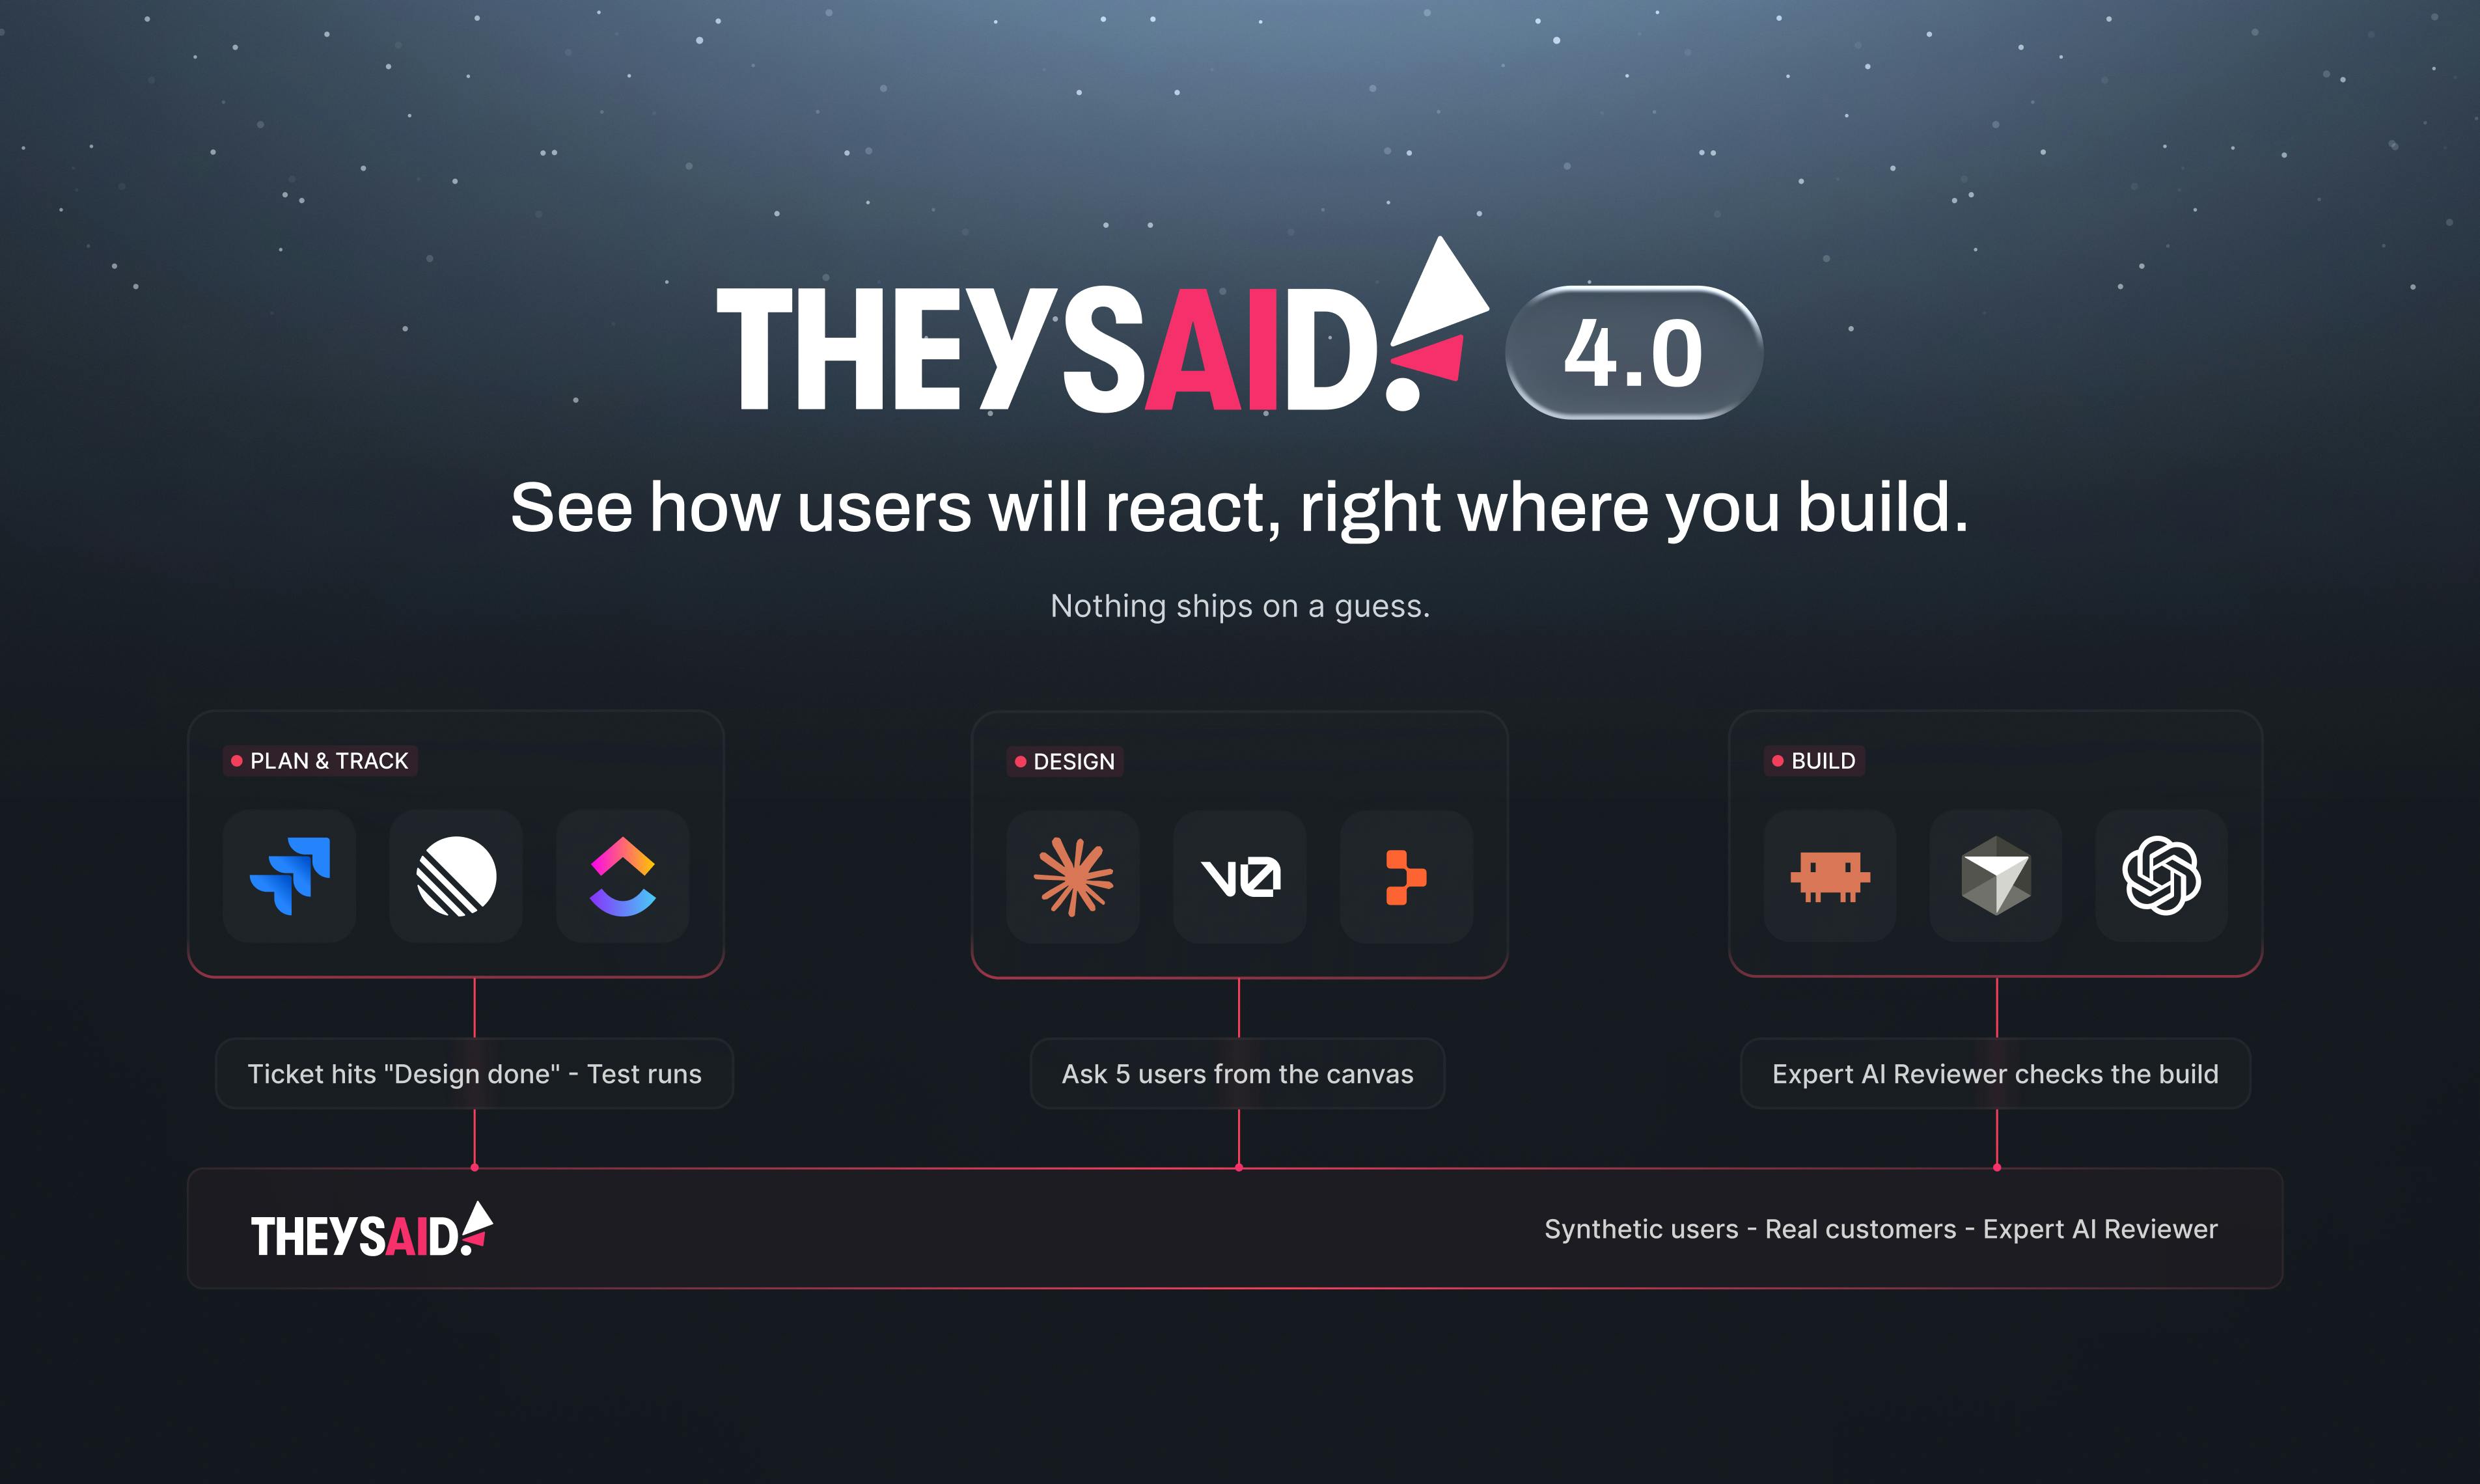
TheySaid 4.0:在开发工具中预判用户反应
TheySaid 4.0 让你在 Claude、Cursor、Jira 中直接获取真实或合成用户的反馈,几分钟内预判用户反应,不再靠猜发布产品。Product Hunt 排名第一。