海外博主实测:DeepSeek已媲美Opus,开发者不必苦等新模型
开源低价的DeepSeek能力逼近顶级闭源模型,一线开发者认为工具已够用,应停止等待更强模型而立即动手构建产品。
一位海外开发者博主通过亲身产品实践提出:DeepSeek V4 Pro的实际表现已接近甚至超过Anthropic Opus 4.8,且因开源免费,正在动摇Claude Code作为AI编程首选工具的地位。他的核心论点是,许多开发者陷入了「等待更强模型」的误区,而当前模型的能力早已足够构建月入万美元的SaaS产品。针对DeepSeek在网页抓取上的短板,他推荐接入BrightData Scraper Studio来弥补,让模型获取高质量的互联网数据以完成SEO分析等任务。成本层面,DeepSeek加BrightData的组合仅需几美分即可完成Claude Code每月200美元方案能做的工作。博主坦承自己生产环境仍在使用Claude Code,但已明确表示若预算有限,它不再是必选项,反映出开源模型对闭源商业产品的实质性挑战。
一位海外开发者兼YouTube博主在自己的婚前派对前录了一段视频,抛出了一个可能让不少AI编程用户重新审视工具选择的观点:DeepSeek如今的表现,已经足以媲美Anthropic的Opus级别模型。而更关键的是,它开源、便宜,并且能实实在在地用来构建产品。
「别再等下一个模型」才是核心洞察
这位博主的观点并非单纯吹捧某个模型,而是想纠正很多开发者的一个误区——总是在等待下一个更强的模型发布,认为只有到那时才拥有足够的"智能"去做自己真正想做的东西。
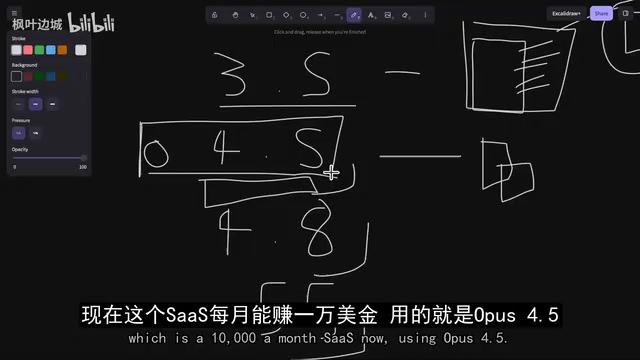
他用自己的产品Harbor做例证。Harbor最初只是他用Sonnet 3.5搭出来的一个基础工具,供团队为客户生成内容。后来交给开发团队做成了SaaS产品,他自己又在Next.js和Convex上用Opus 4.5重建了整个系统。如今,这个产品已经是一个月入1万美元的SaaS。
他强调的重点是:这一切都是用Opus 4.5就能完成的。"你已经拥有构建任何东西所需要的工具了。"换句话说,模型的能力早已越过了做出成熟产品所需的门槛,真正卡住开发者的往往不是模型智能,而是行动力。
DeepSeek的定位:不必更强,够用即可
博主的逻辑很清晰:DeepSeek不需要比Opus 5或所谓的Fable 5更强。只要它能落在Opus 4.5到4.8这个区间附近,甚至"沾边"就值得用。
他甚至认为,最近两周发布的DeepSeek V4 Pro版本,可能已经优于Opus 4.8。虽然他坦言自己"不太确定具体的benchmark数据",这更多是基于实际使用体验的判断,但结论很直接——你现在拥有了一个免费、开源的编程harness(工作框架)。
他在终端里配置好之后,只需输入DeepSeek,系统就会检查更新并启动web服务器,配上在platform.deepseek.com申请的API key就能直接用。他形容整个体验"极其便宜、极其高效"。
所谓「编程harness」(工作框架),是指围绕某个语言模型搭建的一套本地化工具链,通常包括CLI入口、上下文管理、工具调用接口和会话状态维护等模块。它的作用是将原始模型的API封装成开发者友好的工作环境,使模型能直接操作文件系统、执行终端命令、读写代码库。Claude Code本质上也是类似的harness,区别在于它是Anthropic官方提供的闭源产品,而DeepSeek的harness因为开源,开发者可以自行阅读、修改甚至扩展其工具调用逻辑,这也是博主强调「控制权」的根本原因。
用BrightData给模型「装上眼睛」
博主也没有回避DeepSeek的短板。他明确指出,DeepSeek在"正确抓取网页内容"方面存在不足,这是它目前与Claude Code等成熟工具的一个差距。
他的解决方案是接入BrightData的Scraper Studio技能。他强调这个工具的价值在于让模型能"正确读取整个互联网",而不是只拿到质量很差的文本。有了它,模型可以获取SERP(搜索引擎结果页)数据,从而完成SEO分析这类任务。
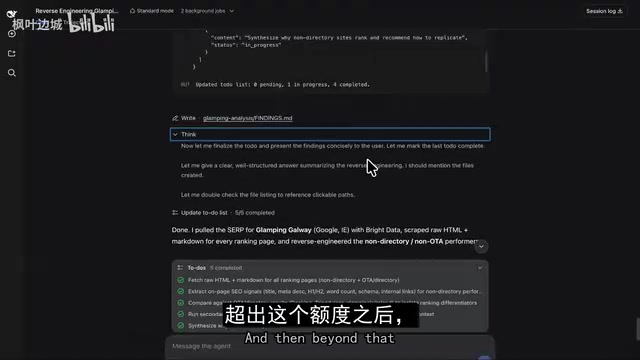
他现场演示了一个例子:让模型查找"glamping Galway"(爱尔兰高尔威的豪华露营)的搜索结果,并反向拆解那些非目录类网站的排名策略。模型给出的分析涉及Google商家资料、EEAT信任信号、真实地址电话、本地内容的话题权威度等,还得出了"页面层面的优化不是决定性因素,信任度往往比on-page信号更重要"的结论——这与SEO行业的普遍经验相当吻合。
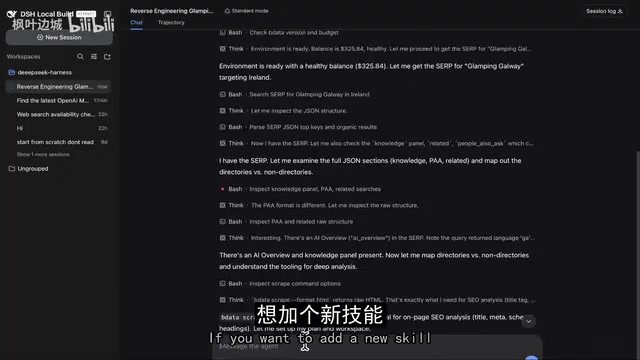
值得一提的是,DeepSeek这套harness的模块化能力也是他看重的地方。想加新技能、新功能,都可以自己写代码接进去,因为开源,他感觉"对自己做的事情拥有更多控制权"。
EEAT是Google在评估网页质量时使用的核心框架,代表Experience(经验)、Expertise(专业性)、Authoritativeness(权威性)和Trustworthiness(可信度)。这一标准在2022年被Google正式加入《搜索质量评估指南》,对本地服务类、医疗类、金融类等「Your Money or Your Life」高影响力页面尤为重要。博主提到模型分析出「信任度比on-page信号更重要」,正是EEAT逻辑的体现——对于本地搜索结果,Google商家资料的完整性、真实地址电话的一致性等信任信号,往往比关键词密度和页面结构优化对排名的影响更大。这也说明BrightData赋予模型的能力不只是「读取页面文本」,而是能提取用于判断竞争态势的结构化SEO信号。
成本账:从每月200美元到「几美分」
博主算了一笔非常直白的经济账。BrightData对新用户提供25美元免费额度(使用其折扣码可获得),这大约够抓取1万到2万个页面,而超出后大致是每千次抓取1美元的水平。
对比之下,Claude Code每月订阅约200美元。他坦承,出于生产环境的可靠性考虑,自己仍会继续为Claude Code付费——"我们负担得起,如果这意味着能用上最好的模型"。
但他的核心结论是:Claude Code不再是100%必需的。"如果我预算有限,我大概不会再付Claude Code的钱了。"这是他两周前还不会说出口的话。对预算敏感的独立开发者和小团队来说,DeepSeek加BrightData的组合,能以"几美分"的成本做到接近"200美元"方案的效果。
值得了解的背景是,Claude Code采用的是基于Token消耗的按量计费模式,其每月200美元的费用来自Anthropic为高频用户提供的订阅套餐(Max Plan),包含更高的速率限制和优先访问权。对于大量依赖多轮代码生成、大文件上下文理解的重度用户,这一费用可能远不止200美元。相比之下,DeepSeek API的价格在主流编程任务场景下极低,其R1和V3系列模型的输入/输出费用约为每百万Token 0.14至0.28美元,比Claude 3.5 Sonnet便宜约20到40倍。这种量级的价格差异,使得成本对于个人开发者和Bootstrapped初创团队而言成为真实的决策变量,而非可以忽略的细节。
一点保留:略显啰嗦,但结果导向
博主也提到DeepSeek的一个使用体感问题——它"稍微有点啰嗦",会做过多的研究工作。不过他补充说,如果最终研究结果足够好,那这个过程冗长与否其实并不那么重要。
他还表示有信心DeepSeek能独立构建一个完整的SaaS,并承诺后续会再做测试来验证。
写在最后
这段视频的价值不在于给出精确的benchmark对比,而在于它反映了一线开发者的真实心态转变:当开源模型的能力逼近顶级闭源模型,成本却相差数百倍时,工具选择的天平开始倾斜。
对开发者而言,博主传递的最实用信息或许是那句反复强调的话——不要总在等待更强的模型才开始动手。你手上的工具,很可能早就够用了。当然,这终究是单一博主基于个人体验的判断,具体是否适合自己的项目,仍需读者结合实际需求和更严谨的评测来验证。
相关推荐
微软官宣10月7日Windows与Surface发布会:本地AI成主角
微软宣布将于10月7日在旧金山举办Windows与Surface发布会,时隔两年再度重磅亮相,核心议题聚焦本地AI如何塑造Windows的未来,或深化AI PC产品形态。
Meta 推出 WhatsApp Business MCP 服务器,让 AI 代理接管繁琐配置
Meta 推出全新 WhatsApp Business MCP 服务器,让开发者可借助 Claude、Cursor、Codex、ChatGPT 等 AI 编程代理自动处理平台配置、消息模板、测试与故障排查,大幅降低接入门槛。
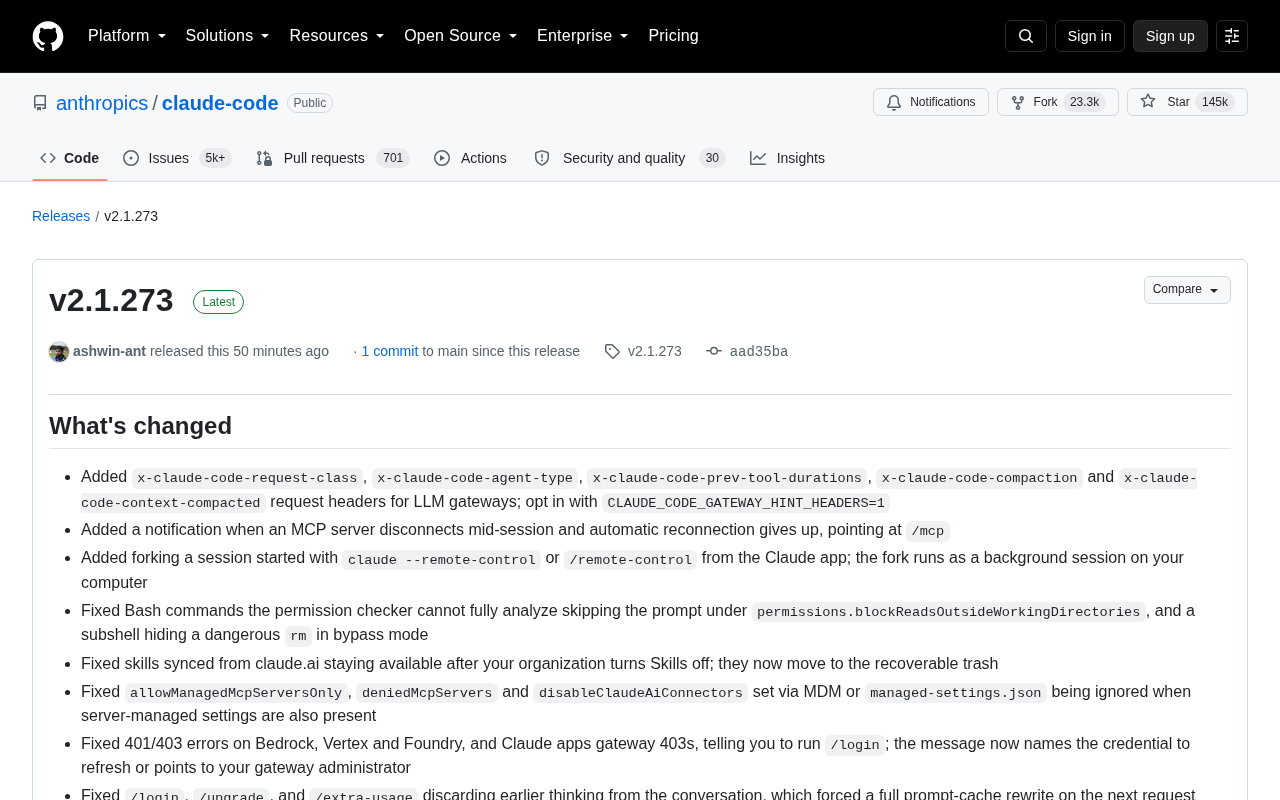
Claude Code v2.1.273更新详解:修复权限漏洞与远程控制增强
Claude Code v2.1.273 版本更新详解,涵盖权限检查安全修复、远程控制会话分叉、MCP 重连、错误提示优化及 Slack 集成与代码审查改进,帮助开发者了解升级要点。