函数调用Schema演进:版本化与边界适配实战
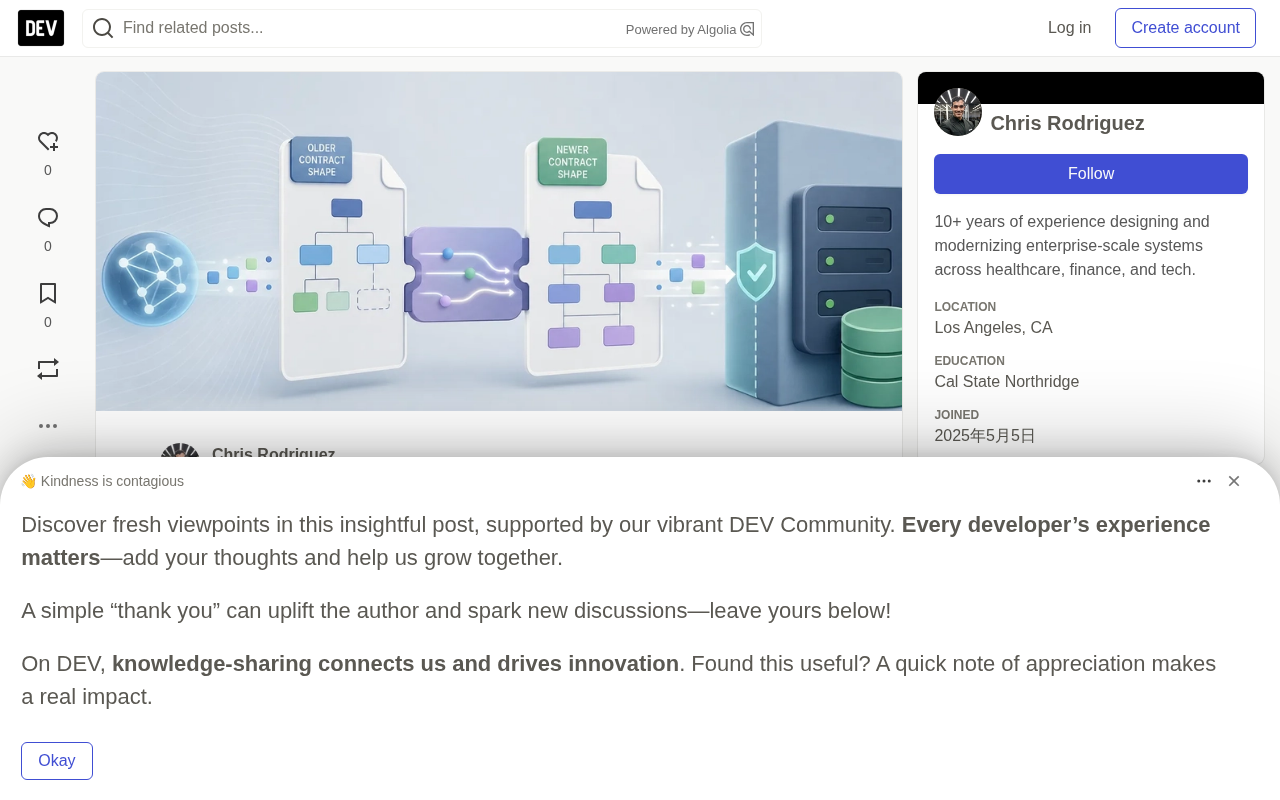
用版本化Schema加边界适配器,让模型契约演进不破坏在线对话。
文章针对 Function Calling 与 Structured Outputs 场景中 Schema 变更导致进行中对话崩溃的问题,提出「版本化 Schema + 边界适配器」的解法。核心思路是把模型侧看到的 wire schema 与应用侧消费的数据结构解耦:保留 v1、v2 等多个版本的 JSON Schema 并存,服务端用 additionalProperties: false 和 required 列表做严格校验,再由适配器把各版本形状翻译成统一的规范对象。文章强调适配器中承载了字段重命名、null 处理、默认值合成等组织决策,必须显式定义并测试,无法识别的形状应直接报错。该模式不提供无限向后兼容,需要主动管理旧版本接受窗口和适配器退役时间。
为什么Schema变更会破坏进行中的对话
当你修改一个Function Calling或Structured Outputs的Schema时,正在活跃的对话不会自动重置。旧对话轮次和回放的工具调用仍然可能发出旧版数据形状。一个简单的字段重命名,或者新增一个必填字段,就足以让下一次对话轮次崩溃。
这个问题的根源在于:模型侧看到的契约(wire schema)和应用侧消费的数据结构被耦合在了一起。一旦Schema更新,旧数据就无法通过新校验。
本文基于开发者Chris Eugene Rodriguez的实践方案,拆解如何通过「版本化Schema + 边界适配器」的模式,让Schema演进不再破坏线上对话。
核心方案:四个步骤解耦模型契约与应用逻辑
1. 对模型可见的Wire Schema进行版本化
保留v1、v2等多个版本的JSON Schema定义,而不是直接覆盖旧版。模型在新对话中被引导输出最新版本,但系统仍然持有旧版本的定义用于校验和适配。
原文示例中,v1使用orderId作为字段名,v2改为order_id,并新增了必填的priority字段(允许boolean或null)。两个版本同时存在,互不干扰。
JSON Schema 是描述 JSON 数据结构的标准规范,在 Function Calling 与 Structured Outputs 场景中,它被用来告诉模型「工具参数或输出应当长什么样」。常见关键字包括 type(数据类型)、properties(对象字段定义)、required(必填字段列表)、additionalProperties(是否允许未声明字段)等。不同模型厂商对 JSON Schema 的支持范围并不一致,Structured Outputs 通常只支持一个受限子集,例如禁止根级 anyOf、限制正则复杂度等。理解这一限制很重要:Schema 不只是文档,而是运行时参与校验和约束生成的契约,因此每一次修改都等同于一次接口变更,需要像对待 API 版本一样谨慎处理。
2. 在服务端边界做严格校验
校验策略采用additionalProperties: false加上显式的required列表。这样任何偏离Schema的输出都会立即失败,并且失败原因可以被精确定位——是模型输出了Schema之外的字段,还是缺少了该版本要求的必填字段。
原文强调:失败应该是「大声的、可解释的」。不要让不规范的payload悄悄流入下游逻辑。
additionalProperties: false 是 JSON Schema 中控制「额外字段」的关键字。默认情况下,JSON Schema 对未在 properties 中声明的字段是宽容的,模型多输出的字段会被静默忽略。将其设为 false 后,任何未声明的字段都会导致校验失败。配合显式的 required 列表,可以同时捕获「多了不该有的字段」和「少了必须有的字段」两类偏差。这种严格模式的价值在于把问题暴露在边界处,而不是让畸形数据流入下游业务逻辑,造成更难定位的故障。实践中常用 Ajv、Zod 等校验库实现,它们能返回精确的路径和原因,便于区分是模型越界还是版本不匹配。
3. 通过适配器归一化到单一规范对象
写一个适配器(adapter),识别已知的wire版本,将它们翻译成应用统一消费的规范结构(canonical object)。
以原文代码为例:adaptToCanonical函数检查输入中是否存在orderId(v1)或order_id(v2),分别处理后输出统一的{ orderId, items, priority }结构。对于v1中不存在的priority,适配器补上默认值false。
这个适配器是兼容性策略的唯一落点。
适配器模式(Adapter Pattern) 是软件工程中的经典结构型模式:在两种不兼容的接口之间插入一层翻译代码,使调用方无需感知被调用方的具体形状。在这里,适配器接收不同版本的 wire schema 数据,输出应用内部统一的规范对象(canonical object)。它的关键设计原则是「单一落点」——所有兼容性判断只在这一个函数里发生,下游代码永远只面对一种数据结构。这样做的好处是:当未来需要退役某个旧版本时,只需删除适配器中对应的分支,影响范围可控;同时测试也可以集中在适配器上,覆盖每个已知版本和无法识别的形状。
4. 把适配策略显式化
适配器里藏着所有兼容性决策:字段重命名怎么处理、null是否等同于可选、缺失数据是否要合成默认值。原文指出这些是组织层面的选择,必须显式定义并编写测试。
对于无法识别的payload形状,适配器应该抛出错误(原文代码中抛出unrecognized argument shape),而不是猜测性地处理。
预期行为与边界
系统应该做到什么
- 新对话被引导使用最新Schema,同时不立即使旧对话失效。
- 在兼容窗口期内,回放中或仍在进行中的对话发出旧版形状时,适配器能够识别并转换为规范对象。
- 无效payload在校验边界明确失败,错误信息足以区分:是模型超出Schema的提议、该版本缺失的必填字段、还是完全无法识别的形状需要补充适配策略。
这个模式不做什么
原文明确列出了局限性:
不提供无限向后兼容。 你需要决定接受旧版本的时间窗口,以及何时移除适配逻辑。这是一个需要主动管理的技术债务。
受限于Structured Outputs的Schema能力。 官方指南限制了某些JSON Schema特性(如根级anyOf、宽松关键字)。如果兼容性需求依赖不支持的构造,应该把逻辑放进适配器而非Schema本身。
策略决策无法自动化。 重命名、null处理、默认值合成——这些是组织选择,需要显式定义并测试。
向后兼容窗口(backward compatibility window) 指的是系统在升级后仍接受旧格式输入的时间段。在 Schema 演进中,这个窗口需要被显式定义:从新版本上线开始,到旧版本适配逻辑被移除为止。窗口过短,可能打断仍在进行的用户会话或历史回放;窗口过长,则适配器代码和技术债务持续累积。工程上通常结合监控数据决定退役时机,例如统计旧版本 payload 的出现频率,当其趋近于零并持续一段时间后再移除适配分支。这与 API 版本管理中的弃用(deprecation)流程本质相同,只是对象从 HTTP 接口变成了模型输出契约。
为什么这个模式值得采用
将模型面对的契约与服务端适配器分离,下游代码可以保持简单稳定,而面向模型的Schema可以独立演进。原文总结为三个收益:发布可回滚、迁移窗口显式化、失败可操作。
从工程角度看,这本质上是把「Schema迁移」从一次性的破坏性变更,转化为一个可控的、有窗口期的渐进过程。适配器承担了翻译层的角色,让新旧两种数据形状在过渡期内共存。
对于任何在生产环境使用Function Calling或Structured Outputs的团队,这套模式提供了一个可落地的参考框架——尤其是在对话式应用中,用户会话的生命周期往往跨越多次部署。
相关推荐
Claude Duet发布:主动型智能体迈出第一步,审批卡成关键约束
Anthropic 推出研究预览版 Claude Duet,Claude 可主动推送简报、语音交办任务,并通过审批卡控制发送、付款、删除等操作。本文分析其主动交互逻辑、安全隔离设计与主动型智能体的信任挑战。
大模型价格战:OpenAI与Anthropic为何降价80%?
OpenAI和Anthropic在几个月内将LLM价格下调高达80%,本文分析价格战背后的竞争、技术成本、商业模式转变及行业影响。
看多计算机却做空AI基建:一位投资者的逆向逻辑
一位投资者在Hacker News提出看多计算机长期需求、却做空AI基建热潮的反直觉立场。本文拆解其逻辑:技术趋势的确定性与资本开支回报的不确定性为何是两回事。