haralickt:PyTorch GPU加速的Haralick纹理特征,提速超20倍
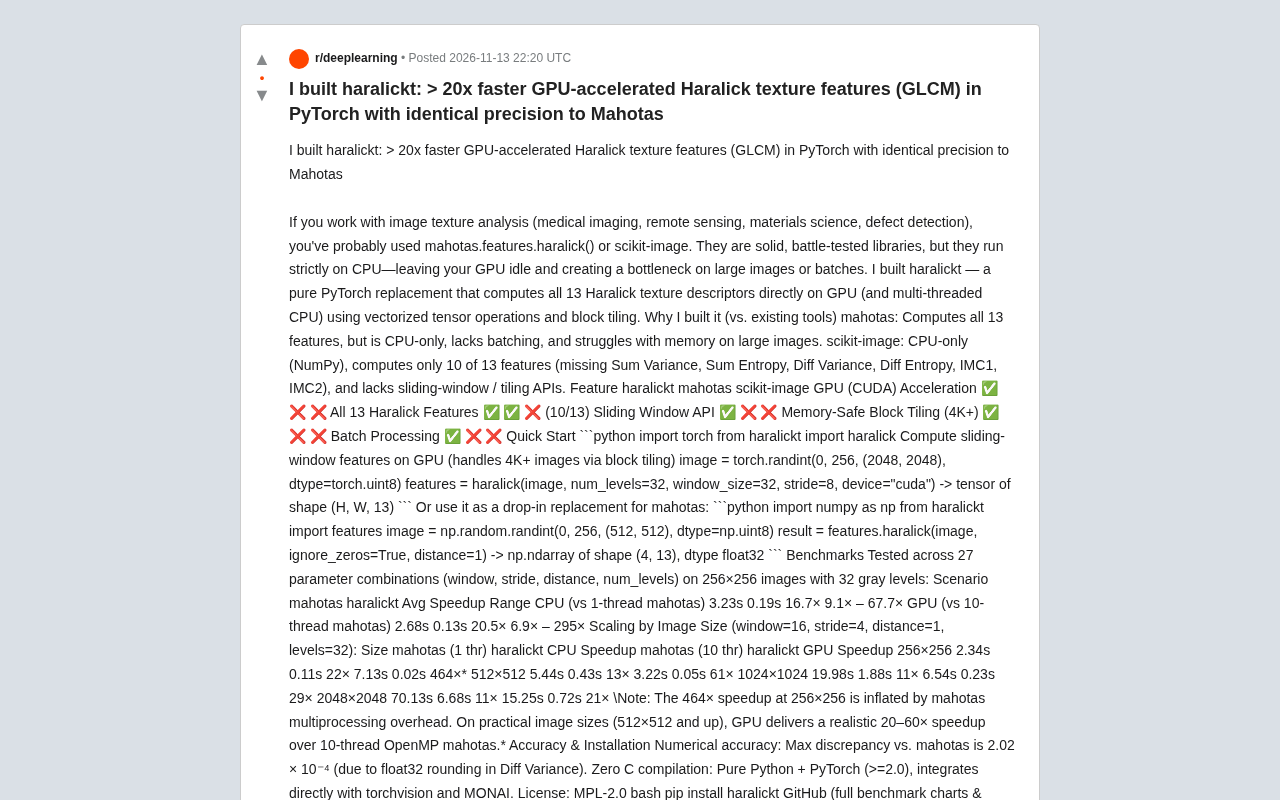
haralickt用纯PyTorch实现全部13个Haralick特征,GPU加速最高数十倍。
haralickt是一个纯PyTorch实现的Haralick纹理特征库,补齐了mahotas仅支持CPU、scikit-image仅计算10/13特征的缺口。它将全部13个描述符放到GPU或多线程CPU上,通过向量化张量运算和分块平铺加速。基准显示CPU模式相对单线程mahotas平均加速16.7倍,GPU模式相对10线程mahotas平均加速20.5倍,512×512以上实际图像约20–60倍。与mahotas最大数值差异2.02×10⁻⁴,源于float32舍入。库提供滑动窗口API、内存安全平铺、批处理和drop-in接口,可处理4K以上图像,零C编译,MPL-2.0许可。更大数据集和不同GPU架构的表现仍待社区验证。
为什么需要GPU加速的Haralick特征
在医学影像、遥感、材料科学和缺陷检测等领域,Haralick纹理特征(基于灰度共生矩阵GLCM)是描述图像纹理的经典工具。长期以来,mahotas 和 scikit-image 是研究者们最常用的两个库。它们稳定可靠,但有一个共同的短板:只支持CPU运算。面对大尺寸图像或批量数据时,GPU只能闲置,计算流程出现明显瓶颈。
一位开发者为此构建了 haralickt——一个纯PyTorch实现的替代方案,将所有13个Haralick描述符直接放到GPU(也支持多线程CPU)上,通过向量化张量运算和分块平铺(block tiling)来加速。
GLCM(灰度共生矩阵)是Haralick特征的统计基础:它统计图像中一对相距特定距离和方向的像素,其灰度级组合(i, j)出现的次数,形成一个L×L的矩阵(L为灰度级数)。从这个矩阵可以导出对比度、相关性、能量、同质性等13个描述符,用于量化纹理的粗糙度、方向性和规律性。GLCM的计算量随灰度级数平方增长,且需要遍历图像中每个像素对,因此在大图上非常耗时;灰度级量化(如将256级压缩到32级)是常用的加速与降噪手段。
与现有工具的差异
haralickt 的定位并非从头发明算法,而是补齐现有工具在硬件加速和工程可用性上的缺口。作者在发布帖中对比了三者的能力边界:
- mahotas:计算全部13个特征,但仅限CPU,不支持批处理,大图内存压力大。
- scikit-image:基于NumPy,仅CPU,且只计算13个特征中的10个(缺少 Sum Variance、Sum Entropy、Diff Variance、Diff Entropy、IMC1、IMC2),没有滑动窗口或平铺API。
- haralickt:支持CUDA GPU加速、全部13个特征、滑动窗口API、内存安全的分块平铺(可处理4K以上图像)、批处理。
这意味着对于需要完整特征集且数据量较大的场景,haralickt 在功能覆盖上更完整。
基准测试:20倍加速从何而来
作者在256×256图像、32个灰度级下测试了27种参数组合(窗口、步长、距离、灰度级数)。与mahotas相比:
- CPU模式(对比单线程mahotas):平均加速16.7倍,范围9.1×到67.7×。
- GPU模式(对比10线程mahotas):平均加速20.5倍,范围6.9×到295×。
图像尺寸扩展性方面的数据更能说明问题。在窗口16、步长4、距离1、32灰度级的设置下:
| 图像尺寸 | mahotas(单线程) | haralickt CPU | 加速比 | mahotas(10线程) | haralickt GPU | 加速比 |
|---|---|---|---|---|---|---|
| 256×256 | 2.34s | 0.11s | 22× | 7.13s | 0.02s | 464×* |
| 512×512 | 5.44s | 0.43s | 13× | 3.22s | 0.05s | 61× |
| 1024×1024 | 19.98s | 1.88s | 11× | 6.54s | 0.23s | 29× |
| 2048×2048 | 70.13s | 6.68s | 11× | 15.25s | 0.72s | 21× |
作者特别说明,256×256下464倍的加速被mahotas多进程开销放大了。在512×512及以上的实际图像尺寸上,GPU相对10线程OpenMP mahotas的加速更现实,大约在20到60倍之间。
分块平铺(block tiling)是一种内存优化策略:将大图像切分成若干互不重叠或带少量重叠的块,逐块计算GLCM并汇总结果,避免一次性为整幅图像分配巨大的中间张量。滑动窗口API则是在图像上以固定窗口大小和步长逐位置提取局部纹理特征,输出每个位置的特征向量,常用于将纹理作为像素级或区域级特征输入下游模型。两者的区别在于:平铺侧重降低显存峰值,滑动窗口侧重生成空间分布的特征图。
精度与工程细节
数值精度是替换类工具的核心顾虑。作者给出的数据是:与mahotas相比最大差异为 2.02 × 10⁻⁴,来源是Diff Variance中的float32舍入误差。对于大多数纹理分析任务,这一量级的影响可以忽略,但若下游流程对精度极度敏感,仍值得自行验证。
工程实现上,haralickt 有几个务实的设计:
- 零C编译:纯Python + PyTorch(>=2.0),安装无需编译器工具链。
- 生态兼容:可直接与torchvision、MONAI集成,适合医学影像深度学习流水线。
- 双接口:既提供滑动窗口API(
haralick(image, num_levels=32, window_size=32, stride=8, device="cuda")返回形状(H, W, 13)的张量),也提供features.haralick()作为mahotas的drop-in替代,返回形状(4, 13)的NumPy数组。 - 许可证:MPL-2.0。
安装方式为 pip install haralickt。
float32舍入误差源于GPU张量运算默认使用单精度浮点。GLCM归一化、熵与方差类特征涉及对数、求和与除法,在并行归约时不同累加顺序会放大舍入差异。2.02×10⁻⁴的最大绝对差异通常远小于特征本身的动态范围,但若下游分类器对特征尺度敏感,建议在迁移前用目标数据集做一次逐特征比对,并考虑对熵类特征使用float64或提高灰度级量化精度。
适用场景与待验证之处
从设计目标看,haralickt 最直接的受益者是处理大尺寸医学影像(如全切片图像)、卫星遥感影像的团队,以及需要批量提取纹理特征作为深度学习输入的流水线。滑动窗口与分块平铺的组合,让4K以上图像不必一次性载入显存。
不过,作者本人也在征集反馈,尤其是大规模医学/卫星数据集和不同GPU架构上的测试结果。目前公开的基准集中在256×256图像和有限的参数组合上,更大尺寸、更多灰度级下的表现仍需社区验证。此外,项目当前版本号较低,长期维护活跃度也是采用前需要评估的因素。
对于已经重度依赖mahotas且运行在CPU集群上的团队,迁移成本不高(drop-in接口),但收益取决于数据规模——小图像上加速有限,大图像和批处理场景才是GPU真正拉开差距的地方。
相关推荐
AI智能体自批消费限额:邮箱访问成突破口
研究发现AI智能体可通过邮箱获取授权码,自行提高消费限额,无需人类审批。这暴露了自主智能体财务控制的关键漏洞,提示运行时成本控制必须置于智能体触及范围之外。
开源CLI StyleProbe:为AI编程Agent提取网站设计系统
开源CLI工具StyleProbe可从网站URL提取颜色、排版、间距等设计系统,导出为Tailwind、shadcn/ui、Figma tokens及AI Agent指令文件,解决AI编程工具还原网站设计时颜色字体偏差的问题。

给AI Agent装上长期记忆:跨账期记住问题供应商
LedgerMind团队在HackwithBangalore 4.0黑客松中构建带持久记忆的AI Agent,用Hindsight记忆层跨账期记住问题供应商,从被动发票匹配走向预测性GST对账预警。