Hermes Agent实战指南:对比OpenClaude的全能AI框架
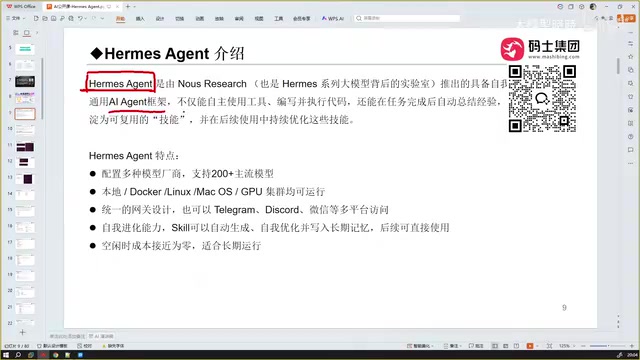
Hermes Agent是什么:不止是另一个AI Agent框架
如果你已经接触过AI Agent领域,理解Hermes Agent会非常简单——它本质上是一个Agent框架。
AI Agent框架的技术演进背景
AI Agent框架的兴起源于2022年底大语言模型能力的质变。传统的聊天机器人基于规则引擎或检索式对话,只能完成预定义的任务流程。而基于GPT-3.5/GPT-4等大模型的Agent则具备了推理、规划和工具使用能力——这得益于模型在预训练阶段涌现出的Chain-of-Thought(思维链)和Few-shot Learning(少样本学习)能力。Chain-of-Thought是指模型在生成最终答案前,先输出中间推理步骤的能力,这使得Agent能够将复杂任务拆解为可执行的子步骤;Few-shot Learning则让Agent仅通过少量示例就能理解新任务的模式,无需大量标注数据。2023年3月,斯坦福和Google联合发表的论文《Generative Agents》证明了LLM可以作为Agent的「大脑」来模拟人类行为,这标志着Agent范式从学术走向工程化。随后,ReAct(Reasoning and Acting)框架的提出进一步确立了「观察-思考-行动」的Agent工作循环模式——Agent先观察环境状态和用户输入,然后通过内部推理决定下一步策略,最后执行具体动作(如调用API或运行代码),并将执行结果作为新的观察输入,形成闭环迭代。这一模式成为当前主流Agent框架的理论基础。
所谓AI Agent框架,是指为构建自主智能体提供底层架构和工具链的软件系统。与传统的聊天机器人不同,Agent不仅能对话,还能自主规划任务、调用外部工具、执行多步骤操作。从技术架构上看,一个完整的Agent框架通常包含四个核心模块:感知层(接收用户输入和环境信息)、规划层(任务分解与策略选择)、执行层(工具调用与动作执行)和记忆层(上下文管理与知识存储)。近两年,随着大语言模型能力的飞速提升,Agent框架赛道涌现出大量竞争者,包括LangChain、AutoGPT、CrewAI、OpenClaude等。你可以把Hermes Agent类比为很多人用过的OpenClaude(俗称"小龙虾"),但从实际体验来看,Hermes Agent在多个维度上都更胜一筹。
Hermes是"爱马仕"的意思,圈内也有人戏称它为"爱马仕Agent"。名字听听就好,关键在于它的定位:一个可以帮你完成几乎任何任务的AI Agent框架。有人认为它相当于Claude Code + OpenClaude的集成体,这个说法并不夸张。经过实际搭建和使用后,可以明显感受到它在模型调教、框架编写上的深度优化——响应更准确、速度更快。
Hermes Agent能做什么:编程与工具集全覆盖
内置Claude Code与Codex,编程能力拉满
在代码编写这一核心场景上,Hermes Agent的表现相当亮眼。OpenClaude在写代码方面支持得并不算完善,而Hermes Agent内置了Claude Code和Codex,直接用它编写代码完全没有问题。
这里有必要解释一下这两个核心组件的背景:Claude Code是Anthropic推出的基于Claude模型的命令行编程工具,擅长在终端环境中理解代码库、编写代码、执行调试等操作,被视为AI辅助编程的标杆产品之一。它的核心优势在于深度代码库感知能力——通过递归式文件读取和语义索引,Claude Code能够理解整个项目的架构、依赖关系和代码风格,从而生成与现有代码高度一致的新代码。Codex则源自OpenAI,是专门针对代码生成和理解进行优化的模型系列,GitHub Copilot的早期版本即基于Codex构建。Codex的训练数据包含了来自GitHub的数十亿行公开代码,覆盖数十种编程语言,使其在代码补全、函数生成和Bug修复等任务上具有极高的准确率。将这两大编程AI能力同时内置到一个框架中,意味着开发者可以根据任务特性灵活选择最优的代码生成引擎——例如,对于需要深度理解上下文的重构任务选择Claude Code,对于快速生成标准化代码片段的场景选择Codex——而无需在不同工具之间来回切换。无论是简单脚本还是复杂项目,开发者都可以借助它高效完成编码工作。
丰富的内置工具集
除了编程能力,Hermes Agent还内置了大量实用工具集。以浏览器操作为例,它不需要像OpenClaude那样真正打开一个浏览器窗口,而是在内部通过工具集访问网页、抓取内容、读取信息。这种"无头"(Headless)式的网页操作方式,效率更高也更省资源。
无头浏览器技术深入解析
所谓无头浏览器技术,是指在没有图形界面的情况下通过程序化方式控制浏览器引擎。常见的实现方案包括Puppeteer(基于Chromium,由Google维护)和Playwright(微软开源,支持Chromium、Firefox和WebKit三大浏览器内核)。两者各有优势:Puppeteer与Chrome生态深度绑定,API成熟度高;Playwright则提供了更好的跨浏览器兼容性和自动等待机制。相比传统的打开可视化浏览器窗口进行操作,无头模式不需要渲染页面的视觉元素(CSS布局、图片解码、GPU合成等),因此CPU和内存占用显著降低——在实际测试中,无头模式的内存占用通常仅为可视模式的30-50%,页面加载速度提升40-60%。更重要的是,无头模式天然支持并发操作,一台普通服务器可以同时运行数十个无头浏览器实例进行数据采集,而可视模式受限于GPU和显示资源几乎无法实现同等规模的并发。这种方式在网页抓取、自动化测试、数据采集等场景中被广泛应用。
简单来说,OpenClaude能做的事,Hermes Agent几乎全都能做,而且它还额外提供了Web工具以及用户自定义Skill的能力。
三大核心亮点:记忆、进化与兼容性
分层记忆机制:长对话不再"失忆"
在长时间实测中,Hermes Agent最让人印象深刻的特性之一就是它的记忆分层做得非常出色。这让它在处理多轮、长周期的复杂任务时能够保持上下文的连贯性,而不会像一些AI框架那样越聊越"失忆"。
AI Agent的记忆管理一直是业界公认的技术难题。大语言模型本身存在上下文窗口的长度限制——即便是支持128K甚至200K Token的模型,在超长对话中也会出现信息丢失和注意力衰减(研究表明,当上下文超过模型训练时的典型长度后,位于中间位置的信息最容易被"遗忘",这被称为"Lost in the Middle"问题)。分层记忆机制借鉴了人类记忆的"感觉记忆-短期记忆-长期记忆"分层模型:短期记忆保存当前对话的即时上下文,通常直接作为Prompt的一部分传入模型;长期记忆则将关键信息持久化存储到向量数据库或结构化存储中,在需要时通过检索增强生成(RAG)技术召回相关内容。此外,还有一种"工作记忆"层,用于保存当前任务的中间状态和执行计划,类似于人类解决复杂问题时在纸上列出的步骤清单。
向量数据库与RAG技术在记忆系统中的应用
向量数据库是专门用于存储和检索高维向量的数据库系统,目前业界的主流选择包括Pinecone(云托管,开箱即用)、Weaviate(支持混合搜索)、Milvus(高性能开源方案)以及ChromaDB(轻量级,适合本地部署)等。在Agent记忆系统中,文本信息首先通过Embedding模型(如OpenAI的text-embedding-3-large或开源的BGE-M3系列)转换为768维或1536维的向量表示。Embedding模型的核心能力是将语义相近的文本映射到向量空间中的邻近位置——这意味着"今天天气很好"和"今日气候宜人"会被编码为距离相近的向量,尽管它们的字面表述完全不同。当需要回忆历史信息时,系统将当前查询同样编码为向量,然后在向量数据库中执行近似最近邻搜索(ANN)。常用的ANN算法包括HNSW(Hierarchical Navigable Small World)和IVF(Inverted File Index),它们通过构建索引结构将搜索复杂度从O(n)降低到O(log n),能在数毫秒内从数百万条记录中找出语义最相关的Top-K条历史记录。这种检索增强生成(RAG)技术突破了LLM上下文窗口的物理限制,使Agent能够访问几乎无限的历史知识。相比传统的关键词检索,向量检索能够理解"汽车"和"车辆"的语义等价性,检索准确率提升30-50%。值得注意的是,高质量的RAG系统还需要合理的分块策略(Chunking Strategy)——将长文档切分为语义完整的片段,避免信息被截断导致的上下文丢失。
这种设计使Agent在跨会话、长周期的复杂任务中能够持续保持对历史信息的感知,大幅提升了多轮交互的质量。
自我进化:自动生成Skill
这是Hermes Agent最具想象力的能力。所谓Skill就是我们常说的"技能",用户可以自己编写,也可以从网络上下载现成的技能包。但更关键的是——Hermes Agent能够自我进化。
在你与它反复对话、完成某类任务的过程中,如果它发现有重复性、规律性的操作(比如"第一步做什么、第二步做什么、第三步做什么"),它会自动为你生成一个Skill。后续再遇到类似需求时,它会直接调用自己生成的Skill来完成任务。
程序合成与神经符号推理
这种能力的技术根基来源于程序合成(Program Synthesis)——一种从高层规范自动生成可执行代码的技术,其历史可追溯到1960年代的LISP语言时代。早期的程序合成依赖于形式化规约和定理证明,效率极低。现代神经程序合成结合了深度学习与符号推理,形成了一种混合架构:Agent首先用LLM理解用户的自然语言描述,提取出输入输出样例、约束条件等结构化信息;然后通过神经网络搜索程序空间,生成候选代码片段;最后利用符号执行引擎验证代码的正确性,确保生成的程序在各种边界条件下都能正确运行。这种方法在Codex、AlphaCode(DeepMind的竞赛级编程系统)等系统中被广泛应用。Hermes Agent的Skill自动生成机制可视为一种轻量级的程序合成:它不是从零生成完整程序,而是将用户的操作序列抽象为参数化的工作流模板,通过模式匹配识别重复模式,再通过模板实例化来实现代码复用。这种方法在效率和泛化性之间取得了良好平衡。
Skill自动生成的核心思想还与元学习(Meta-Learning)领域紧密相关。元学习,也被称为"学会学习",其核心理念是让系统不只学习如何解决单个任务,而是学习如何快速掌握新任务的通用策略。当Agent检测到用户反复执行相似的工作流时,它会将这些操作步骤抽象为可复用的函数或工作流模板,并以Skill的形式固化下来。这与软件工程中的"设计模式"理念异曲同工——从重复性实践中提炼出通用解决方案。类似的思路在Voyager(基于GPT-4的Minecraft Agent,由NVIDIA等机构联合开发)等研究项目中已经得到验证:Voyager通过不断积累技能库(最终积累了超过60个技能),在游戏中探索的地图面积是无技能积累Agent的3.3倍,实现了能力的持续增长,而非每次都从零开始推理。这种"用得越多、越聪明"的机制,极大地降低了长期使用的成本和学习门槛,也是Hermes Agent区别于传统"无状态"Agent的核心竞争力所在。
支持200+模型与全平台部署
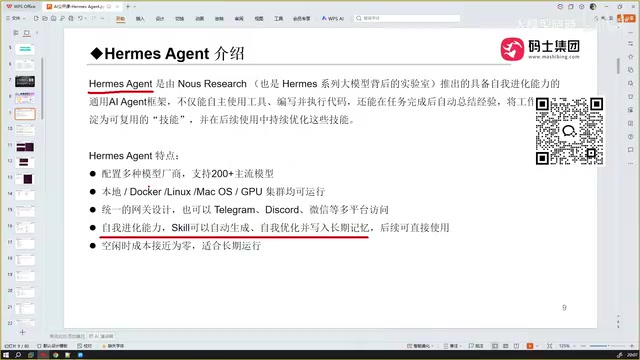
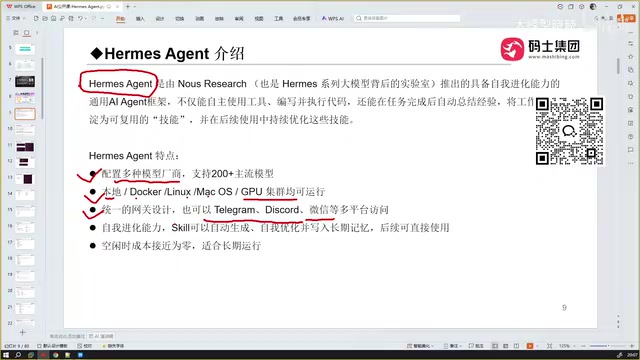
Hermes Agent在兼容性上几乎没有短板:
- 模型支持超过200个:市面上主流的模型供应商,它基本都支持。这种广泛的模型兼容性得益于对OpenAI兼容API格式的支持——目前绝大多数模型供应商(包括Anthropic、Google、Mistral、国内的智谱、DeepSeek、通义千问等)都提供了与OpenAI API格式兼容的接口,使得框架只需实现一套API调用逻辑即可覆盖大量模型。
- 部署方式灵活:支持本地部署,兼容Windows、Docker、Linux、macOS,甚至集群环境都没问题。Docker容器化部署是目前最推荐的方式,它通过将应用及其所有依赖打包为一个轻量级容器镜像,实现了"一次构建,到处运行"的目标,极大简化了环境配置和依赖管理的复杂度。
无缝集成聊天平台:微信扫码即用
和OpenClaude能集成微信、飞书类似,Hermes Agent同样可以接入几乎任意的聊天软件或平台——国内的微信、企业微信、钉钉,国外的Telegram、Discord等,支持种类非常丰富。
这种跨平台集成能力通常基于两种技术路径:一是通过各平台的官方Bot API(如Telegram Bot API、Discord Bot API、企业微信的Webhook)进行标准化对接;二是通过协议逆向工程实现对个人版即时通讯软件(如微信)的接入。后者在技术上更具挑战性,通常需要使用iPad协议、Windows Hook或Web协议等方式模拟客户端登录。Hermes Agent能够实现"扫码即用"的便捷体验,很可能封装了成熟的协议层中间件,将底层复杂的协议对接抽象为简单的用户操作。
更值得一提的是配置的简便性。相比OpenClaude繁琐的接入流程,Hermes Agent往往只需要扫个码就能完成绑定,大幅降低了使用门槛。
这种集成带来了一个非常实用的使用场景:假设你把Hermes Agent静默运行在家里的Windows电脑上,并绑定了微信。那么在外出时,你完全可以通过手机微信对话来远程操作你的电脑,让它帮你完成各种任务。相当于把整台电脑变成了你随身携带的AI助手。从技术实现上看,这本质上是一种基于自然语言的远程过程调用(RPC):用户的微信消息经由Agent解析为具体的操作指令,Agent在本地执行后将结果通过微信回传,整个过程对用户而言就像在和一个懂技术的朋友聊天一样自然。
Token消耗对比:远低于OpenClaude的经济之选
对于AI Agent的重度用户来说,Token消耗一直是绕不开的痛点。
这里先解释一下背景:Token是大语言模型计费和处理文本的基本单位。模型不直接处理文字,而是先通过分词器(Tokenizer)将文本拆分为Token——英文中一个Token大约对应4个字符或0.75个单词,而一个中文字大约对应1.5-2个Token(因为中文字符在BPE分词算法中通常需要更多字节来编码)。在Agent场景中,Token消耗远高于普通聊天——每一次工具调用需要将工具定义和调用参数编码为Token,每一轮思考链(Chain of Thought)的中间推理过程会产生大量输出Token,每一次上下文拼接都需要将历史对话完整发送给模型。以Claude 3.5 Sonnet为例,输入Token价格为3美元/百万Token,输出为15美元/百万Token。一个复杂的多轮Agent任务轻松就能消耗数万乃至数十万Token,费用可达数美元甚至更高。因此,Agent框架在Token效率上的优化直接关系到用户的实际使用成本。
Token经济学与缓存优化策略
Token经济学是理解Agent成本结构的关键。以一次典型的Agent任务为例:系统提示词(System Prompt,定义Agent的角色、能力和行为规范)通常占用1000-3000 Token;历史对话上下文可能达到10000-50000 Token;每次工具调用的请求和响应又会增加500-2000 Token。在没有优化的情况下,一个10轮的复杂对话可能消耗20万Token,按Claude 3.5 Sonnet定价计算约3-6美元。Hermes Agent采用的优化策略可能包括以下几种:
- 提示词压缩(Prompt Compression):通过蒸馏技术将冗长的系统指令浓缩为更短的等效形式,或使用LLMLingua等工具在保留核心语义的前提下去除冗余表述,通常可将Prompt长度压缩40-60%。
- KV缓存复用(KV Cache Reuse):在Transformer架构中,每个Token的处理都会生成Key-Value对。对于重复出现的上下文片段(如不变的系统提示词),直接复用之前计算的键值对可避免重复推理,大幅降低计算成本。
- 智能上下文裁剪:通过语义重要性评分,保留关键信息,丢弃冗余细节,在不损失核心信息的前提下缩短上下文长度。
- Prompt Caching(提示词缓存):类似于Anthropic推出的Prompt Caching功能——对不变的系统提示词进行服务端缓存,后续请求只需为增量内容付费。以Anthropic的定价为例,缓存命中时输入Token的价格仅为正常价格的10%,理论上可降低70-90%的基础Token开销。
而Hermes Agent在这方面的表现令人惊喜:
- 闲置时几乎零消耗:不使用的时候,Token消耗极低。这意味着它不会像某些Agent那样在后台持续轮询或维护心跳连接而产生不必要的Token开销。
- 整体消耗远低于OpenClaude:有测试者将两者进行了长时间的多轮对话对比,结果显示Hermes Agent的总体Token消耗量远远低于OpenClaude。
这种成本优势很可能得益于更智能的上下文裁剪策略、缓存复用机制以及避免冗余工具调用的优化设计。对于那些需要频繁多轮对话、Token消耗大的Agent应用场景,Hermes Agent是一个更经济实惠的选择。
总结:谁适合用Hermes Agent
综合来看,Hermes Agent是一款定位清晰、能力全面的AI Agent框架。它在编程能力(内置Claude Code/Codex)、工具生态、记忆分层、自我进化以及跨平台集成方面都展现出了较强的实力,同时在Token成本上保持了明显优势。
MCP协议的标准化意义
值得一提的是,Hermes Agent也支持MCP(Model Context Protocol,模型上下文协议)配置。MCP是Anthropic在2024年11月推出的开放标准,旨在解决AI模型与外部工具集成的碎片化问题。在MCP之前,每个Agent框架都有自己的工具调用格式——LangChain使用Tools抽象层、OpenAI使用Function Calling、Anthropic使用Tools API,开发者需要为每个平台编写不同的适配代码,维护成本极高。
MCP定义了统一的服务器-客户端架构:工具提供方实现MCP Server,暴露标准化的三类接口——资源(Resources,用于数据访问)、工具(Tools,用于执行操作)和提示词(Prompts,用于预设交互模板);Agent框架作为MCP Client,通过JSON-RPC 2.0协议(一种轻量级的远程过程调用协议,使用JSON格式传递参数和返回值)与服务器通信。这种设计理念类似于LSP(Language Server Protocol)在代码编辑器领域的革命性作用——微软最初为VS Code设计了LSP,使得一个语言服务器(如TypeScript Server)可以同时被VS Code、Vim、Emacs等所有支持LSP的编辑器使用。MCP追求同样的效果:开发者编写的MCP Server可以无缝接入Claude Desktop、Zed Editor、Cursor、Hermes Agent等所有支持MCP的客户端,真正实现"一次编写,到处运行"。
截至2025年初,MCP生态已有超过数百个官方和社区服务器,覆盖数据库查询(PostgreSQL、MySQL)、文件系统操作、网络爬虫、代码仓库管理(GitHub、GitLab)、云服务控制(AWS、GCP)等丰富场景。这个统一的"插口"标准大幅降低了工具集成的复杂度,也为Hermes Agent等框架快速扩展能力边界提供了坚实基础。
以下几类用户尤其值得尝试:
- 开发者:需要一个内置编程能力的Agent框架来提升开发效率。
- OpenClaude老用户:觉得OpenClaude配置繁琐或Token消耗过高,想找更好的替代方案。
- 远程办公需求者:希望通过微信等聊天工具远程操控电脑完成任务。
无论是本地部署、MCP配置,还是通过微信、Telegram等平台远程调用,Hermes Agent都提供了相对友好的上手体验。如果你之前用过OpenClaude并感到不够好用,那么Hermes Agent值得一试。
核心要点
相关推荐

让AI审查自己的文档:验证CLAUDE.md真伪的开源工具包
RAG Techniques仓库作者开源了一套工具,用于验证AI Agent读取的CLAUDE.md和项目文档中哪些是猜测、哪些被代码证伪。文章解析其置信度标注机制、与Claude Code /init的对比及局限性。

谷歌又一AI安全研究员离职:警告"我们可能都要死"
谷歌又一位AI安全研究员离职并发出"人类可能面临灭绝"的极端警告,本文解析此类离职背后的行业张力、存在性风险争论以及AI治理的深层挑战。

19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。