Hermes AI Agent 自动化渗透测试实战:Skills、Memory 与 Cron Jobs 全解析

用 Hermes Agent 把持久化 Memory、结构化 Skill 与定时自动化串成完整的漏洞挖掘流水线
本文介绍了一套面向漏洞赏金和授权渗透测试场景的 AI Agent 自动化方案,核心工具为 Hermes Agent。与 Claude Code 等通用助手相比,其最大差异在于持久化 Memory 机制——Agent 能随使用者成长、记住工作方法论,避免长会话遗忘。方案基于云端 VPS 部署,通过 Telegram Bot 远程操控,并围绕 Skills 构建结构化指令集:支持对话生成、手动粘贴和爬取高质量技术资料三种方式。XSS 等漏洞的检测遵循"先验证 Content-Type → 测反射 → 注 HTML → 升级为 XSS"的分层流程,并采用弱模型发现、强模型验证的双模型分工降低误报。最终通过 Cron Jobs 实现 7×24 小时自动监控新子域,抢占漏洞赏金的时间窗口,所有发现自动生成 PoC 并推送告警。
针对渗透测试和漏洞赏金场景的 AI Agent 自动化方案,一直缺少系统性的实操教程。这篇来自 bilibili 转载的 Hermes Agent 实战内容,填补了"如何把 AI 智能体改造成一个专属黑客助手"的空白——从云端部署、Telegram 对接,到构建自定义 Skills、训练持久化 Memory,再到用 Cron Jobs 实现 7×24 小时自动资产监控。
需要先说明:下文涉及的所有技术均应用于授权的渗透测试、漏洞赏金或自有靶场,任何未经授权的扫描与攻击都属于违法行为。
为什么选 Hermes Agent 而不是通用 Chatbot
作者将 Hermes Agent 与 Claude Code、Codex 这类通用编码助手做了直接对比,核心差异落在记忆(Memory)机制上。
通用大模型在长时间会话中会出现明显的"遗忘"——用作者的说法,"Claude Code 在第 30 天不会和第 1 天一样",上下文窗口的限制让它逐渐丢失早期约定的规则。Hermes Agent 的设计思路是让 Agent 随使用者一起成长:当你告诉它"我叫 Zach",它会显示 updating memory 并把信息写入持久化记忆层。随着使用天数增加,它会逐渐学习你的提问习惯、工作流和漏洞挖掘方法论,减少每次都要重新喂指令的成本。
这一点对渗透测试尤其关键。漏洞挖掘往往是一个长期积累方法论的过程,一个能记住你偏好、能复用你历史战术的 Agent,比每次从零开始的对话窗口更有生产力价值。
环境搭建:从 VPS 到 Telegram 对接
整套方案的基础设施并不复杂,但有几个关键节点值得关注。
部署到云端 VPS
作者选用 VPS 作为 Agent 的"居所"——因为 Agent 需要一个常驻、能执行命令的环境。演示中使用的配置为 2 vCPU、100GB 存储、Ubuntu 系统,这对运行 Hermes Agent 来说已经足够。部署流程是常规操作:购买 VPS → 复制 IP → 通过 SSH(ssh root@<IP>)连接 → 从 Hermes 官网复制安装命令一键执行。
配置 LLM 后端
模型接入提供了两种路径:一是使用 Hermes 官方门户(NewResearch)充值后用统一 API Key 调用多个模型;二是接入第三方聚合服务(如 OpenRouter 类平台),好处是能切换 DeepSeek广告、Opus、OpenAI 等多种模型,甚至包含部分免费模型。
作者的实际配置是用 DeepSeek V4 Flash 做漏洞发现、用更强的模型做验证——这个分工后面会详细展开。需要提醒的是,免费模型不建议用于严肃的渗透任务。
对接 Telegram 远程操控
Hermes 支持 Telegram、Discord、WhatsApp 等多种聊天接口,作者偏好 Telegram。手动对接流程是:在 Telegram 找到 BotFather → 创建 new bot → 复制生成的 API Key → 填入 Hermes → 再绑定自己的用户 ID 以限定控制权限。
这里有一个安全提醒非常重要:Bot 的 API Key 等同于你 VPS 的密码,任何拿到它的人都能接管你的 Agent,必须严格保密。
Telegram Bot 的工作原理是通过 Telegram 的 Bot API 进行长轮询(long polling)或 Webhook 接收消息。BotFather 是 Telegram 官方提供的机器人管理入口,所有机器人的创建、Token 颁发和权限配置均通过它完成。生成的 Bot Token 格式类似 110201543:AAHdqTcvCH1vGWJxfSeofSs4tq09sFDoje,前半段是 Bot ID,后半段是密钥——泄露后攻击者可以通过 sendMessage 等 API 接口直接控制机器人行为。绑定"用户 ID 白名单"的意义在于:Telegram Bot 默认对任何用户可见,若不加限制,任何知道 Bot 用户名的人都能发送指令。用户 ID 可通过 @userinfobot 等工具查询,是一串纯数字,与用户名不同且不可伪造,因此是有效的访问控制手段。
核心能力:Skills 的构建与学习
Skills 是整套方案的"大脑",本质上是你给 Agent 下达的结构化指令集。作者提供了三种构建 Skills 的方式。
三种构建路径
第一种是对话式生成:直接把你的 HackerOne API Key 交给 Agent,让它抓取你历史提交的 XSS 或越权报告,自动总结并生成专属 Skill——相当于把你的实战方法论沉淀成可复用的能力。
第二种是手动粘贴:如果你之前在 Codex 或 Claude Code 里积累了 Skill,可直接复制到 New Skill 里。
第三种是作者最推崇的 Learn Skill 功能:喂给 Agent 高质量的技术博客、HackTricks 页面或 HackerOne 公开报告 URL,点击 Learn,它会爬取这些页面并自动提炼出一份完整的技能文档。作者特别提醒,不要用 Medium 这类文章,"它们有时会撒谎或过于泛泛",要选真正高质量的漏洞技术资料。
Learn Skill 功能的底层是对目标 URL 执行爬取与内容提炼,与检索增强生成(RAG)的理念相通:将外部非结构化文档转化为 Agent 可调用的结构化知识。HackTricks 是安全社区最常引用的渗透技术知识库,按漏洞类型和协议分类,内容经过大量实战验证;HackerOne 公开的披露报告则包含真实目标上的完整攻击链,是方法论质量最高的素材来源之一。相比之下,Medium 等内容平台缺乏同行审查机制,存在技术细节失真或夸大的情况,用其训练 Skill 可能引入错误的测试逻辑,导致 Agent 在实战中产生无效或有害的操作序列。
一个好的 XSS Skill 应该怎么写
作者用相当的篇幅批评了初学者常见的误区:拿一条 one-liner 命令(用 qsreplace 批量替换参数 + httpx 检测反射)往终端一丢就指望挖到 XSS。这种做法的问题在于——盲目注入大量 payload 会触发 WAF,导致 IP 被封,哪怕目标真有漏洞你也测不出来了。
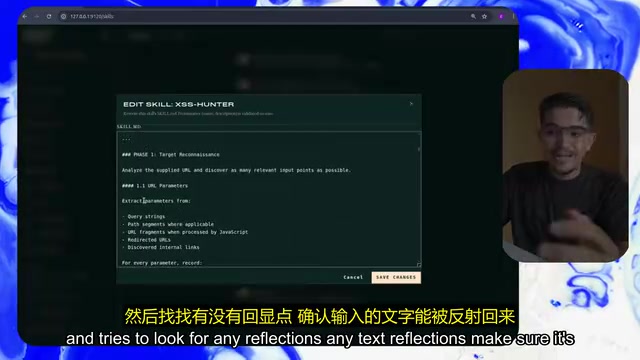
他给出的正确流程是分层递进的:
- 先检查 Content-Type 是否为 text/html——对 JSON 接口注入 HTML 毫无意义,只会白白暴露;
- 用唯一标记测试反射——注入
xyz或zac看是否被反射进 DOM; - 先注入 HTML 代码判断是否存在 HTML 注入;
- 再逐级升级为 XSS——通过添加
onerror、onhover等事件处理器触发confirm(1)。
这套"先侦察、后升级"的逻辑,正是把一份 Skill 从"能找基础 XSS"提升到"能找高级 XSS"的关键,而这些细节都需要明确写进 skills.md。
用独立模型做结果验证
AI 必然会产生误报。作者的解法是构建一个专门的验证 Skill——用不同的、更强的模型复核发现。他的组合是 DeepSeek V4 Flash 负责发现、DeepSeek V4 Pro 或 Opus 负责验证,并强调即使 AI 判定"100% 是漏洞",最终仍要人工复核。
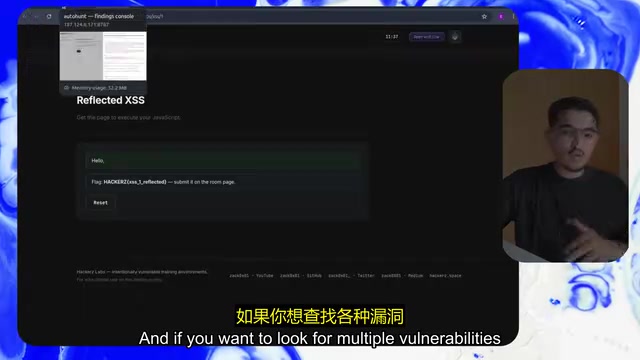
每个确认的发现都会生成结构化输出:JSON、Markdown 报告,以及最关键的 finding.html 概念验证文件。这个 PoC 可以直接发给漏洞报告的审核方(triager),对方只需打开 HTML 即可自动复现——演示中就展示了一个 POST 型 XSS 的自动提交 PoC,大大降低了双方的沟通成本。
AI 安全工具中的误报(False Positive)问题尤为突出,根本原因在于大模型依赖模式匹配而非真正理解 HTTP 上下文的语义。一个典型误报场景是:模型看到响应体中出现了注入的字符串,就判定为"反射成功",但实际上该字符串可能被 HTML 实体编码(< 变为 <)或 JavaScript 字符串转义,在浏览器中并不会执行。双模型验证的价值正在于此:第一个模型作为"侦察员"广撒网、容忍误报以保证覆盖率;第二个更强的模型作为"审判员",对候选结果做更严格的上下文推理。这种流水线设计在成本和准确率之间取得平衡——强模型推理成本更高,若全程使用则开销难以接受,而将其集中在验证环节则效费比最优。
组合与自动化:Web Scan 与 Cron Jobs
用主 Skill 调度子 Skill
当目标不止需要查 XSS,还要覆盖越权(IDOR)、SSRF、LFI、越权访问控制时,作者的做法是构建一个名为 web scan 的调度型 Skill,由它来调用 XSS、IDOR 等子 Skill。
关键在于让 Agent 按资产特征智能选择策略:抓取页面后,看到 id、email 参数就优先测越权;看到 url、redirect、file 这类参数则重点查 SSRF 或 LFI。web scan 的完整流程被拆解为 scope → surface → route → load playbook → confirm → report,并在收尾处强制加入确认环节。
Cron Jobs:抢占新资产的时间差
这是整套方案中最具实战价值的部分。漏洞赏金的核心逻辑是"钱在新资产里"——当目标上线一个新子域或新资产时,第一个动手的人才能拿到赏金。
Cron Jobs 让这件事完全自动化:你可以设定每天午夜 12 点执行一次侦察任务,让 Agent 用 recon skill(可配合 subfinder、assetfinder 或付费 API)跑一遍目标,把新发现的子域与历史子域列表(如 x.txt)比对,一旦出现新子域,就自动调用 web scan 扫描并通过已对接的 Telegram/Discord 推送告警。
对接商业客户的场景同样适用:设置为每周或每月执行安全检查,自动生成 PDF 报告,发给客户或供你审核后转交。作者本人的用法是"每 24 小时扫描指定目标 + 每天午夜检查新资产",所有发现汇总进一个统一的 Dashboard。
Cron 是 Unix/Linux 系统内置的定时任务调度器,语法由五个时间字段(分、时、日、月、周)加命令构成,例如 0 0 * * * 表示每天午夜 0 点执行。在漏洞赏金的资产发现场景中,常配合 subfinder(被动子域枚举)、assetfinder(基于证书透明度与多源 DNS 查询)等工具使用。核心逻辑是增量比对:将每次枚举结果与历史基线文件做 diff,只对新增条目触发后续扫描,而非每次全量重扫——这既节省计算资源,也避免对已知资产频繁发起请求而触发速率限制或封禁。对于漏洞赏金而言,程序方在新资产上线后的 24-72 小时内防御最为薄弱,自动化监控能系统性地抓住这一时间窗口。
实战价值与风险提示
这套 Hermes Agent 方案的真正价值,不在于某个单一功能,而在于把持久化记忆 + 结构化 Skill + 多模型验证 + 定时自动化串成了一条完整的漏洞挖掘流水线。它解决了 AI 辅助安全测试中的两个老问题:上下文遗忘,以及缺乏可复用的方法论沉淀。
但也必须冷静看待其边界:AI 的误报依然需要人工把关,作者反复强调"永远不要无条件信任 AI 的判断";自动化扫描若配置不当极易触发 WAF 封禁;更重要的是,所有操作都必须限定在授权范围内。把它当成放大个人方法论的杠杆,而不是替代专业判断的黑盒,才是正确的打开方式。
相关推荐
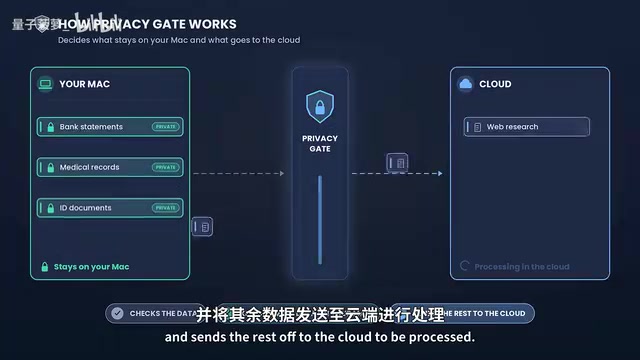
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。