HotPOT:异构物理专家如何破解PDE预训练干扰难题
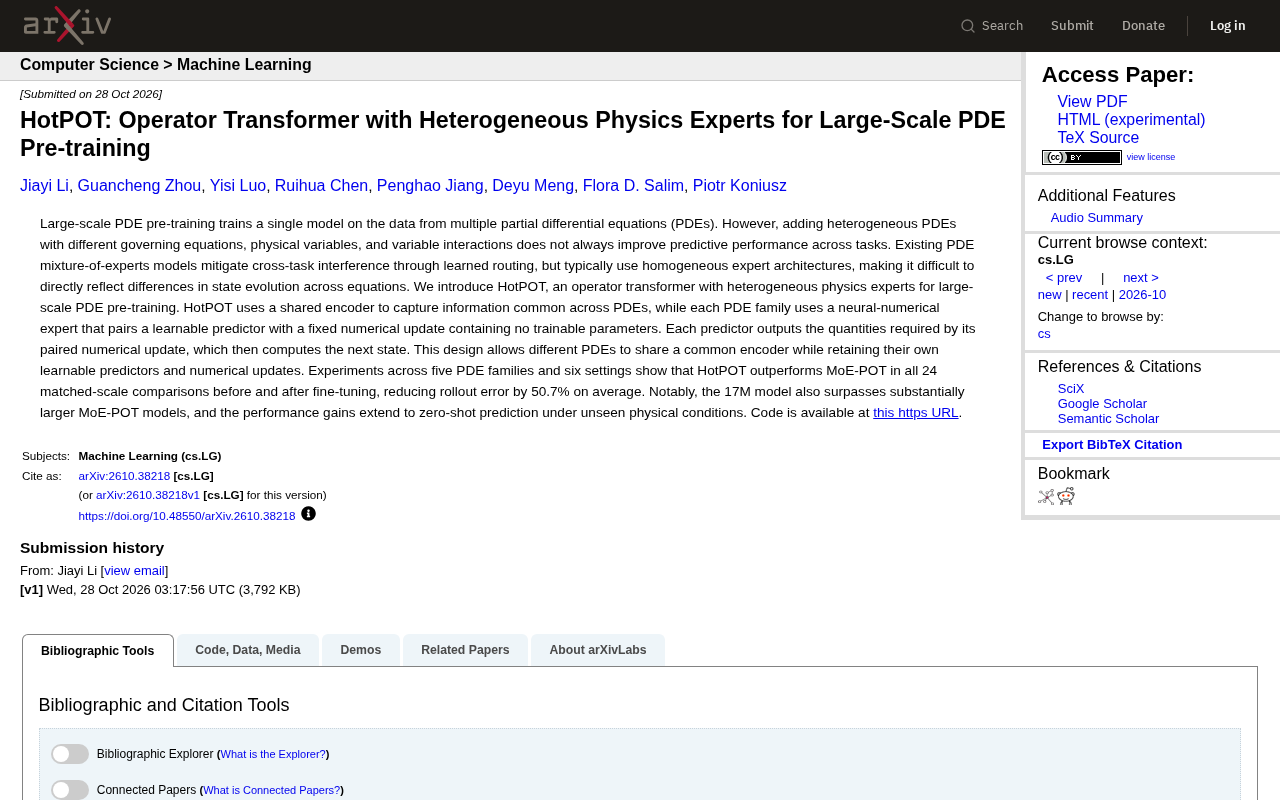
HotPOT用共享编码器加异构神经-数值专家,在24组PDE预训练对比中全部胜出。
HotPOT针对大规模PDE预训练中同构混合专家(MoE)难以体现方程结构差异的问题,提出共享编码器加异构神经-数值专家的架构。每个PDE族拥有一个由可学习预测器与固定数值更新配对的专家,将数值格式作为先验嵌入,减少隐式学习物理规律的数据压力。在五个PDE族、六种设置下,HotPOT在24组同尺度对比中全部优于MoE-POT,rollout误差平均降低50.7%,且17M参数模型超过规模更大的基线,零样本预测也展现可迁移性。该工作为PDE预训练提供了“嵌入数值结构”而非单纯堆参数的新路径。
大规模PDE预训练试图用单一模型覆盖多个偏微分方程的数据,但不同方程的控制规律、物理变量和变量间交互方式差异巨大,简单混合数据并不总能提升预测性能。现有PDE混合专家(MoE)模型通过学习路由来缓解跨任务干扰,却普遍采用同构专家架构——所有专家共享相同的网络结构,难以直接反映不同方程在状态演化上的本质区别。HotPOT的提出正是为了从架构层面回应这一问题。
同构专家的瓶颈与异构思路
混合专家模型在PDE预训练中的核心假设是:不同方程共享一部分通用表征,同时需要专家来吸收各自的特殊性。问题在于,如果所有专家都是同构的,那么“特殊性”只能通过参数差异来体现,而无法通过计算结构来体现。PDE的状态演化往往由数值更新规则决定,例如有限差分、谱方法或有限体积格式,这些规则本身就编码了方程的结构信息。同构专家只能从数据中隐式学习这些规则,效率和数据需求都更高。
HotPOT抓住的正是这个缺口:让每个PDE族拥有一个神经-数值专家,将可学习的预测器与固定的数值更新配对。固定数值更新不含可训练参数,负责按照方程已知的数值格式计算下一状态;可学习预测器则输出数值更新所需的数量。两者的分工把“学什么”和“怎么算”拆开,专家之间不再是纯参数差异,而是计算流程上的差异。
混合专家模型(MoE) 的核心思想是训练多个“专家”子网络,并通过一个路由网络决定每个输入由哪些专家处理。在PDE预训练场景中,路由通常根据方程类型或输入特征将不同方程分配给不同专家,从而减少跨任务干扰。然而,传统MoE的专家往往共享相同的网络架构(如同构的MLP或Transformer块),仅参数不同。这意味着专家之间的差异完全依赖数据驱动学习,而非结构先验。对于物理规律已知的PDE,这种同构设计无法直接利用数值格式等结构化知识,导致学习效率和数据需求较高。HotPOT的异构专家正是针对这一局限,将数值更新规则作为固定组件嵌入专家,使专家在计算流程上产生本质区别。
HotPOT的架构设计
HotPOT采用共享编码器加异构专家的整体结构。共享编码器负责捕捉跨PDE的共性信息,避免每个方程从零开始学习通用表征。每个PDE族对应一个神经-数值专家,其中可学习预测器根据编码器输出产生数值更新所需的量,固定数值更新再依据这些量计算下一时刻状态。
这一设计的直接好处是:不同PDE可以共享同一个编码器,同时保留各自的可学习预测器和数值更新。共享部分降低了预训练的数据压力,异构部分则保留了方程层面的结构差异。与纯数据驱动的同构MoE相比,HotPOT把数值格式作为先验嵌入专家内部,减少了专家需要从数据中隐式推断物理规律的空间。
神经-数值混合专家是一种将可学习的神经网络与固定的数值求解器结合的设计范式。其中,固定数值更新通常对应某种已知的离散格式(如有限差分、谱方法),它不含可训练参数,负责按照方程的结构化规则推进状态;可学习预测器则负责输出数值格式所需的中间量(如通量、源项或闭合项)。这种分工使模型能够将“已知的物理规律”与“未知的本构关系”解耦,减少神经网络从数据中隐式学习数值格式的负担。与纯数据驱动的专家相比,神经-数值专家在物理规律已知但部分项未知的场景中更具数据效率,同时也为跨方程泛化提供了结构化的归纳偏置。
实验表现:24组对比全部胜出
据论文披露,研究团队在五个PDE族、六种设置下进行了实验,覆盖微调前后共24组同尺度对比,HotPOT在所有对比中均优于MoE-POT, rollout误差平均降低50.7%。更值得关注的是模型规模与性能的关系:17M参数的HotPOT模型也超过了规模显著更大的MoE-POT模型,说明架构层面的异构设计带来的收益并未被参数量差距抵消。
性能增益还延伸到未见物理条件下的零样本预测,意味着HotPOT学到的不是对训练方程族的过拟合,而是可迁移的数值-物理表征。论文代码已在GitHub开源,仓库地址为cruiseresearchgroup/HotPOT-code。
对PDE预训练路线的启示
HotPOT的价值不只在于一组实验数字。它提示了一条与“堆参数、堆数据”不同的预训练改进路径:把方程已知的数值结构作为不可训练的固定组件嵌入专家,让可学习部分专注于数值更新无法直接给出的量。这种神经-数值混合的专家设计,天然适合物理规律已知但本构关系或闭合项未知的场景。
当然,这一路线也有其适用边界。固定数值更新要求每个PDE族有明确的数值格式可用,对于数值格式尚不成熟或方程形式不确定的问题,异构专家的构建成本会上升。此外,论文实验覆盖五个PDE族,跨更多方程类型的泛化能力仍需后续验证。但至少在跨方程干扰这一核心痛点上,HotPOT给出了一个结构清晰、可复现的解法。
相关推荐

Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。