华硕Ascent GX10开箱:1.5升桌面超算挑战大模型算力

华硕Ascent GX10以1.5升桌面机身承载GB10超级芯片,最高支持405B模型开发推理。
文章基于B站UP主开箱视频,介绍了华硕Ascent GX10迷你超级计算机。该设备体积仅1.5升、重1.6千克,采用NVIDIA公版设计语言与极简正面,便于融入办公环境。核心搭载NVIDIA GB10 Grace Blackwell超级芯片,Grace CPU与Blackwell GPU通过NVLink-C2C互连,支持双机堆叠扩展,最高可承载405B参数模型的开发与推理。软件方面预装NVIDIA AI软件栈,支持PyTorch、TensorFlow,省去复杂环境配置。其定位介于高端工作站与云端算力之间,面向赛事转播、生物医药、智能制造等需要近场算力的场景。文章同时提醒,当前信息来自单一UP主展示,实际性能与稳定性仍需独立测试验证。
当大模型参数规模持续膨胀,算力供给似乎天然与“机房”“集群”绑定。但华硕用一台体积仅1.5升的桌面设备给出了另一种可能:把超算级算力塞进迷你机箱,让开发者直接在办公桌上跑起百亿参数级模型。近期,B站UP主“极能核计算机”的开箱视频展示了这款名为Ascent GX10(视频中口播为CX-10)的迷你超级计算机,其核心卖点直指AI开发中最痛的算力门槛。
开箱:NVIDIA公版设计语言,1.5升的紧凑机身
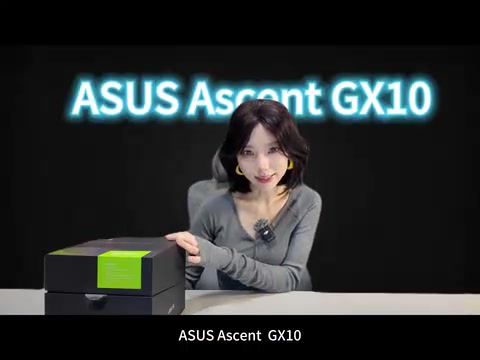
据B站UP主“极能核计算机”展示,Ascent GX10的包装延续了NVIDIA公版风格,整机重量仅1.6千克,体积比一张非公版RTX 5090显卡更紧凑。这种“小盒子”形态打破了传统工作站或服务器机箱的刻板印象。
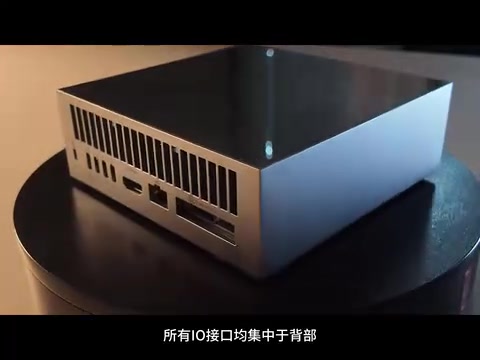
正面设计极其简洁,仅保留电源按键,所有IO接口集中于背部。这种极紧正面设计让GX10能完美融入任何办公环境,而非像传统算力设备那样必须安置在机房或专门的实验室角落。对于需要安静、整洁工作空间的算法工程师或科研人员来说,这一细节的实用价值不低。
核心配置:GB10超级芯片与双机堆叠扩展
GX10的算力来源是NVIDIA GB10 Grace Blackwell超级芯片。视频中特别提到,该设备支持双机堆叠扩展,最高可支持405B参数模型的开发与推理。这一规格意味着它并非“玩具级”边缘设备,而是能承载当前主流开源大模型(如Llama 3.1 405B级别)的桌面级平台。
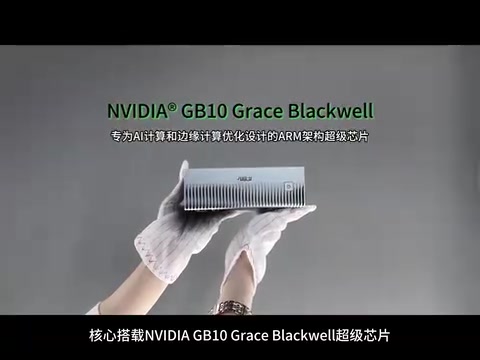
从架构上看,Grace CPU与Blackwell GPU通过NVLink-C2C互连,这种设计在能效比和内存带宽上针对AI负载做了专门优化。桌面级设备能撬动405B模型,关键在于高带宽内存与芯片间互连效率,而非单纯堆砌GPU数量。
Grace Blackwell 超级芯片是 NVIDIA 面向 AI 与高性能计算场景推出的异构 SoC 设计。其中 Grace 指基于 Arm 架构的 CPU 部分,Blackwell 指新一代 GPU 架构,二者通过 NVLink-C2C 芯片间互连总线连接,而非传统 PCIe。NVLink-C2C 的带宽远高于 PCIe,可让 CPU 与 GPU 以接近统一内存的方式共享数据,减少大规模模型推理时频繁拷贝带来的延迟与能耗开销。这种设计在能效比上针对 AI 负载做了专门取舍,也是桌面级小型设备能够承载百亿至数百亿参数模型的关键前提之一。
405B 参数模型的部署门槛值得单独说明。Llama 3.1 405B 这类模型在 FP16 精度下仅权重就需约 800GB 显存,即便采用 FP8 或 INT4 量化,仍需数百 GB 级内存。因此单台 GX10 的原生内存容量通常不足以独立承载完整 405B 模型,所谓“最高支持 405B”往往依赖双机堆叠后内存池的聚合,以及量化、张量并行等技术的配合。理解这一点有助于客观评估设备的实际适用边界。
软件栈:开箱即用的AI开发环境
硬件之外,GX10预装了NVIDIA AI软件栈,覆盖从原型设计到部署的全流程,并支持PyTorch、TensorFlow等主流框架。视频强调“省去了复杂的环境配置过程”,这恰好击中了许多AI开发者的日常痛点——在本地复现一个可用的CUDA环境往往要耗费数小时甚至数天。
开箱即用的软件栈降低了AI开发门槛,让研究者能把时间花在模型设计和实验上,而非驱动与依赖的版本冲突上。对于高校实验室、初创团队或个人开发者,这种“通电即用”的体验可能比峰值算力数字更具吸引力。
NVIDIA AI 软件栈是一组围绕 GPU 加速计算的软件集合,通常包括 CUDA 驱动与运行时、cuDNN 等加速库、TensorRT 推理优化工具,以及 NGC 容器目录中预构建的框架镜像。对 Grace Blackwell 这类 Arm CPU + GPU 的异构平台,软件栈还需提供适配 Arm 架构的编译工具链与预编译包,否则开发者自行从源码编译 PyTorch 等框架会非常繁琐。预装软件栈的价值正在于此:它把驱动、CUDA 版本、框架二进制包之间的兼容性组合固定下来,减少“版本地狱”式的环境调试成本。
应用场景与市场定位
UP主列举了赛事转播、建模渲染、生物医药、智能制造等场景。这些场景的共同点是对实时推理或中等规模训练有需求,但又不具备自建机房的条件。GX10的定位介于高端工作站和云端算力之间:比云端更私密、延迟更低,比传统工作站更紧凑、更易部署。
需要注意的是,视频内容来自单一UP主的开箱展示,405B模型的实际推理性能、双机堆叠的具体效率以及长时间运行的稳定性,仍需更多独立测试验证。对于考虑采购的团队,建议关注后续的基准测试数据,尤其是内存带宽和实际token生成速度。
小结
华硕Ascent GX10把Grace Blackwell平台压缩到1.5升体积,用桌面形态承接大模型开发需求,方向值得关注。它未必能替代机房集群,但为算力焦虑提供了一条“近场”解法——把算力放到离开发者更近的地方。至于这台小盒子能否真正撬动大规模AI模型的日常开发,答案将在更多实测数据中揭晓。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
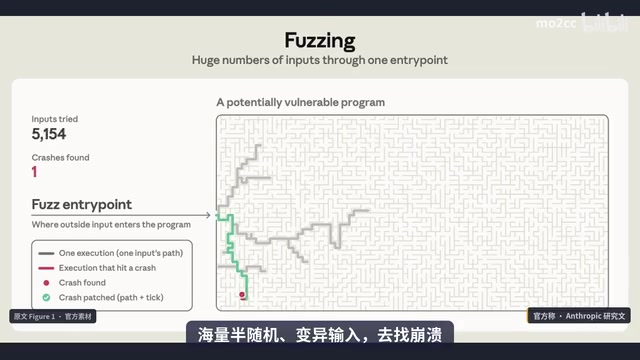
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。