Hugging Face政策主管:嵌入式AI评估并非易事

Hugging Face政策官指出AI基准测试与嵌入式评估方法尚未成熟,分数应作参考而非结论。
Hugging Face首席政策官Irene Solaiman在TechCrunch讨论中提醒,AI基准测试虽被实验室广泛用于宣传模型优势,但其评估方法复杂且仍处早期阶段,业界对“何为好的评估”缺乏共识。她特别对企业将评估器嵌入AI系统内部的想法持谨慎态度,指出其面临利益冲突、动态环境干扰以及“谁来评估评估器”等结构性难题。Solaiman认为,基准分数应被视为参考信号而非绝对结论,评估的透明度与方法论披露比分数本身更重要。对构建AI产品的团队而言,嵌入式评估只能作为持续监控的一环,需与人工审核和真实用户反馈结合,评估体系的成熟需要行业投入与模型能力同等程度的关注。
AI实验室们将声誉押注在模型基准测试上——这套被设计用来衡量一个AI产品是否优于另一个的评估体系,号称中立且准确。然而,Hugging Face首席政策官Irene Solaiman在TechCrunch的一次讨论中指出,这些评估背后的方法相当复杂,且仍在成熟过程中。
基准测试的光环与现实
基准测试长期以来被视为AI模型能力的"公平裁判"。各大实验室在发布新模型时,几乎都会附上一组跑分数据,用以证明自家产品在推理、编程、数学等任务上的优势。这种惯例塑造了一种公众认知:分数越高,模型越强。
Solaiman的提醒打破了这种简化叙事。她认为,评估方法本身远未定型,业界对"什么才算好的评估"仍缺乏共识。当评估结果被直接用作产品宣传时,方法上的模糊性就被掩盖了。
基准测试(benchmark)在AI领域的运作方式,通常是从公开数据集或专门构建的题库中抽取任务,让模型批量作答后计算准确率、通过率等指标。常见的例子包括衡量通用知识的MMLU、考察数学推理的GSM8K、评估代码能力的HumanEval等。
这类测试的关键局限在于数据污染:如果训练语料中混入了测试题目,模型的高分可能只是记忆而非泛化。此外,基准任务往往被简化成单选题或固定格式输出,与真实使用场景的开放性差距较大。业界因此出现了“刷榜”现象——针对榜单特性优化模型,而非提升实际能力。这也是Solaiman强调评估方法尚未成熟的背景之一。
嵌入式评估为何难以落地
讨论的核心之一是企业将评估器直接嵌入AI系统内部的设想。这种做法听起来合理:让模型在运行过程中自我检查、自我打分,从而持续监控质量。但Solaiman对此持谨慎态度。
嵌入式评估面临几个结构性难题。其一是利益冲突——如果评估器由开发模型的同一团队构建,中立性如何保证?其二是动态环境的干扰——模型在真实场景中的表现受输入分布、用户行为等因素影响,静态评估难以覆盖。其三是评估器本身也可能出错,形成"谁来评估评估器"的循环。
Solaiman并未否定嵌入式评估的价值,而是强调它不会是一个"简单解决方案"。这句话的潜台词是:把评估内嵌进产品,看似省事,实则把复杂性转移到了更隐蔽的地方。
嵌入式评估在技术上常借助“模型即评审”(LLM-as-a-judge)实现,即用另一个语言模型对主模型的输出打分或排序。这种做法的吸引力在于成本低、可规模化,但已知存在若干偏差:评审模型倾向于偏好更长的回答、更接近自身风格的输出,以及对某些表述位置敏感(位置偏差)。
与人工评估相比,模型评审的可复现性较好,但在涉及事实准确性、微妙语境判断时可靠性下降。业界目前的折中方案是让多个评审模型交叉打分,或引入人工抽检校准。这恰好印证了Solaiman所说的“不是简单解决方案”——评估器自身需要被评估,形成层层嵌套的验证成本。
评估方法仍在成熟中
据Solaiman的说法,当前AI评估领域整体处于早期阶段。基准测试的设计、数据集的构建、评分标准的选择,都存在大量主观判断空间。不同评估之间结果不一致的情况并不罕见,而业界对这些差异的解释能力仍然有限。
这对依赖基准分数做采购决策的企业用户构成挑战。一个模型在某个榜单上领先,未必意味着它在特定业务场景中表现更好。Solaiman的观点提示,评估结果应当被当作参考信号而非绝对结论。
对行业实践的启示
Solaiman的发言指向一个更务实的立场:评估的透明度和方法论披露,可能比分数本身更重要。当实验室公布跑分时,配套说明评估条件、数据集来源和局限性,才能让外部观察者判断结果的可信度。
对于构建AI产品的团队而言,这意味着不能把嵌入式评估当作质量保证的终点。它更适合作为持续监控的一环,与人工审核、真实用户反馈结合使用。评估体系的成熟,需要行业在方法论上投入与模型能力同等程度的关注。
Hugging Face作为开源模型社区的重要参与者,其政策主管的表态也反映出平台方对评估话语权的谨慎。在一个基准分数被广泛用作营销工具的环境里,承认评估方法的不成熟,本身就是一种立场。
相关推荐
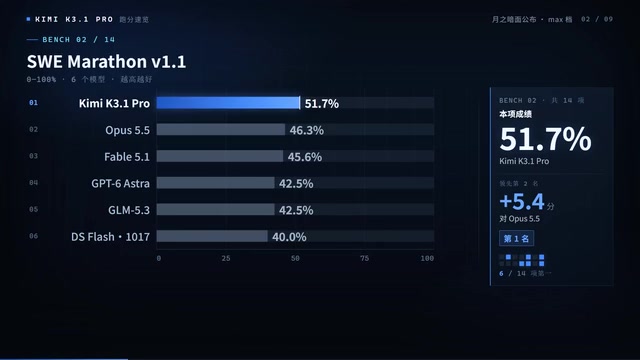
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。