混合私有MoE路由:智能体中间推理Token成本降七成
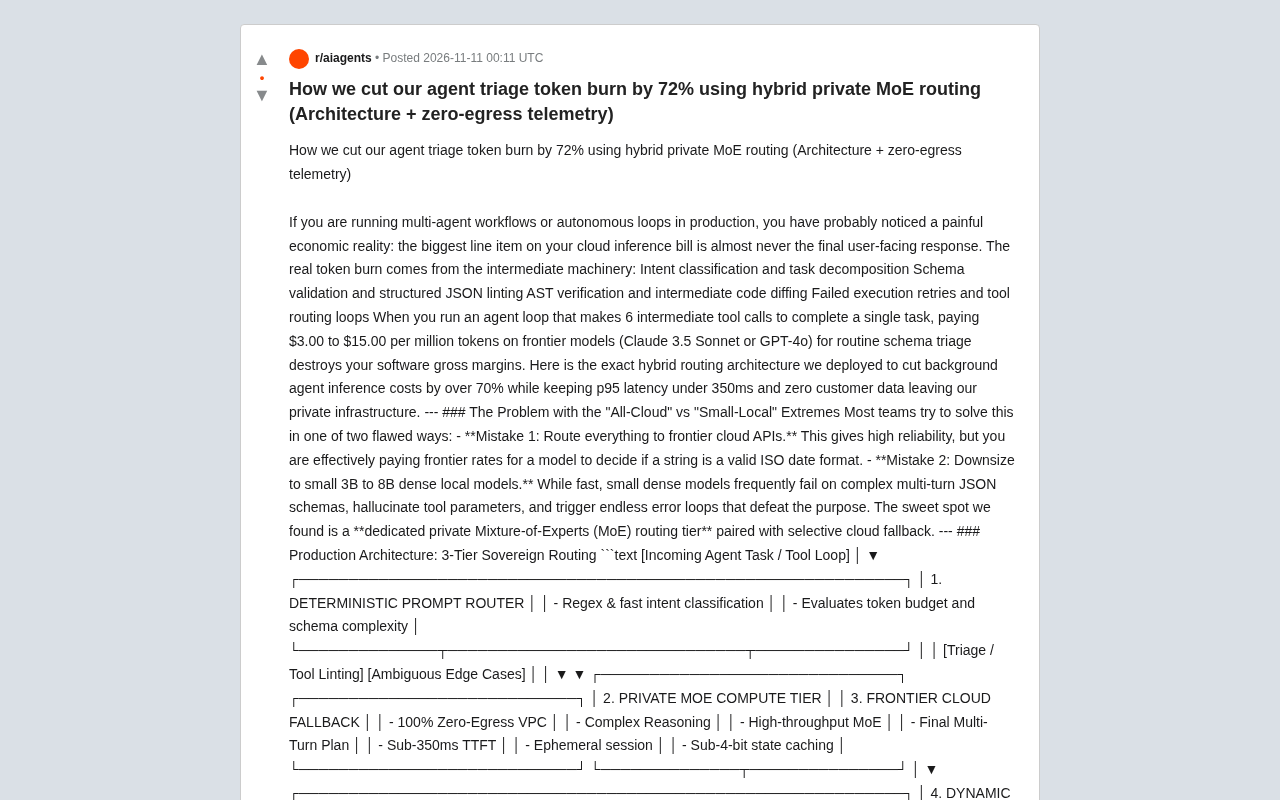
私有MoE路由层加选择性云端回退,把智能体中间推理成本降约七成。
文章指出,多智能体工作流的云推理账单大头并非最终回答,而是意图分类、Schema校验、重试循环等中间机械环节。全部走前沿云API成本结构错配,降级到稠密小模型又会因格式失败陷入重试。一支团队采用四级架构:确定性路由器初筛,私有零出口MoE承接格式类任务,云端只处理复杂推理,并以双次Schema失败为升级守卫。配合前缀缓存、亚4比特非对称量化与上下文移位,月度账单降68%至74%,首token从1200ms降至340ms,任务完成率与纯云端差距在0.5%以内。
运行多智能体工作流的生产团队往往有一个反直觉的发现:云推理账单里最大的开销,几乎从来不是最终面向用户的那次回答。真正烧钱的是中间机械环节——意图分类与任务拆解、Schema校验与结构化JSON检查、AST验证与中间代码比对、失败重试与工具路由循环。当一个智能体为完成单次任务要发起6次中间工具调用时,若每次都按前沿模型(如Claude 3.5 Sonnet或GPT-4o)每百万token 3至15美元的价格付费,软件毛利率会被直接侵蚀。
一支工程团队在Reddit上分享了他们的解法:用「私有MoE路由层+选择性云端回退」的三级架构,把后台智能体推理成本降低约七成,同时把p95延迟压在350ms以内,且客户数据零出口。
两种极端做法为何都行不通
多数团队在解决这个问题时会掉进两个坑。
其一,全部路由到前沿云API。 可靠性没问题,但等于用前沿模型的价格去判断一个字符串是否符合ISO日期格式,成本结构完全错配。
其二,降级到3B至8B的稠密本地小模型。 速度快,但小而稠密的模型在复杂多轮JSON Schema上频繁失败,会幻觉出工具参数,触发无休止的错误循环,省下的钱又被重试吃掉。
该团队找到的中间地带是:一个专用的私有MoE路由层,搭配选择性的云端回退。这个思路值得关注的地方在于,它没有在「能力」和「成本」之间二选一,而是按任务难度做了分流。
MoE(混合专家)模型与稠密模型的核心区别在于参数激活方式。稠密模型每次前向传播都会调用全部参数,而MoE在每一层设置多个“专家”子网络,通过门控机制只激活其中少数几个。这意味着总参数量可以很大(如数百亿),但单次推理的实际计算量仅相当于一个小得多的模型。对于路由层这种需要高吞吐、低延迟、同时要处理一定语义复杂度的场景,MoE能在有限算力下提供比同计算量稠密模型更好的表达能力——这也是该团队选择私有MoE而非3B至8B稠密小模型的底层原因。
三级主权路由的生产架构
架构分四层,流程如下:
- 确定性提示路由器:用正则和快速意图分类做初筛,同时评估token预算与Schema复杂度。分拣与工具检查类请求走私有算力,模糊的边界情况走云端。
- 私有MoE计算层:部署在100%零出口的VPC内,高吞吐MoE推理,首token时间低于350ms,支持亚4比特状态缓存。
- 前沿云端回退:只承接复杂推理和最终多轮规划,采用临时会话。
- 动态重试与升级守卫:私有MoE通过Schema校验就继续执行;检测到格式失败则升级到云端层。
关键设计在于分流点的判断逻辑:绝大多数中间步骤是确定性的格式工作,本就不该交给前沿模型;只有真正需要推理的部分才值得付溢价。
四项来自生产环境的技术突破
前缀缓存与状态复用(命中率90%以上)
智能体框架几乎每一步都会重放大量系统指令、OpenAPI Schema和上下文历史。团队在私有推理节点上启用了激进的前缀缓存与状态复用,消除了重复的提示词摄入开销。首token时间从云端的1200ms降至本地340ms以内。这一步对延迟的改善是数量级的。
前缀缓存(Prefix Caching) 是一种推理优化技术:当多次请求共享相同的提示词前缀时,模型只需在第一次请求时计算并缓存该前缀对应的KV(键值)状态,后续请求直接复用,跳过重复的注意力计算。智能体工作流天然适合这种优化,因为系统指令、工具Schema和对话历史在每一步都被反复重放。缓存命中率越高,节省的prefill计算就越多,首token时间(TTFT)下降越明显。需要注意的是,前缀缓存对提示词结构敏感——只有从开头完全一致的部分才能命中,因此稳定的系统提示词排版是发挥其效果的前提。
亚4比特状态量化,Schema零损失
团队测试了多种量化配置用于结构化JSON生成。标准均匀量化常常破坏标点与括号匹配,而对键值状态做非对称亚4比特缓存,在数千次自动化工具调用中保持了100%的语法合规,且没有内存膨胀。
量化指用更低比特位宽表示模型权重或激活值以节省内存和带宽。均匀量化将数值范围等距划分,实现简单,但在极低比特(如4比特以下)时对数值分布不均的键值状态误差较大,容易破坏JSON中括号、引号等对精度敏感的字符预测。非对称量化则为每个量化组单独学习零点与缩放因子,能更好拟合实际分布;键值缓存量化只压缩KV状态而非权重,可在不改变模型主体精度的前提下降低显存占用。两者结合,是低比特下仍保持结构化输出语法合规的关键。
上下文移位保护
弄崩本地推理守护进程最快的方式,就是无界的工具循环撑爆上下文长度。团队实现了动态上下文移位:把历史草稿步骤摘要成确定性检查点,既避免内存溢出导致的停顿,又保留任务连续性。
数据主权
对法律、医疗、金融类工作负载而言,把原始用户对话记录或专有代码库diff发往公共API端点,会直接触发合规问题。把中间分拣放在私有硬件上,意味着敏感载荷数据永远不经过第三方服务器。这一点对受监管行业来说,可能比成本节省更重要。
经济账与可复现的工程参数
据该团队公布的数据:月度API账单平均降低68%至74%;分拣响应中位时间从约1.1秒降至约320毫秒;在Schema校验连续两次失败即强制升级的守卫下,任务完成率与纯云端基线差距控制在0.5%以内。
需要说明的是,这些数字来自单一团队的内部工作负载与客户基准测试,并非独立第三方验证,实际收益会随任务分布而变化。不过其工程参数——前缀缓存命中率、亚4比特缓存、双次失败即升级——提供了可复现的调优方向。
对正在为智能体中间推理成本发愁的团队来说,这条路径的核心启示是:先按任务的确定性程度做分流,再谈模型选型。把格式校验交给便宜的私有算力,把真正的推理留给云端,成本结构会立刻变得健康。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。