混合物理量时间序列如何编码?Reddit热议DL模型输入策略

Reddit讨论总结混合物理量时间序列的编码策略,强调归一化与编码协同设计。
本文基于Reddit社区讨论,探讨了深度学习模型处理混合物理量时间序列时的编码挑战。针对连续物理量(如时间、速度、位置),社区共识是采用标准化后输入,但时间信息需额外编码(如时间差或周期编码)。对于绝对位置,存在绝对编码与相对编码的分歧,后者在机器人领域更受青睐。实用策略包括:对每个物理量单独归一化、使用类型嵌入帮助模型区分特征来源、以及根据任务选择早期或晚期融合。文章强调归一化与编码需协同设计,避免特征尺度不一致影响注意力权重。最后指出尚无一刀切方案,未来需针对特定领域细化策略。
在深度学习模型(尤其是基于注意力机制的模型)处理时间序列时,一个常见但棘手的问题是:输入数据包含多个不同物理量(如时间、速度、绝对位置等),如何有效编码这些混合测量值,使模型易于推理并与归一化策略兼容?近日Reddit上的一则讨论帖引发了社区对编码策略的深入探讨。
问题背景:多物理量时间序列的编码挑战
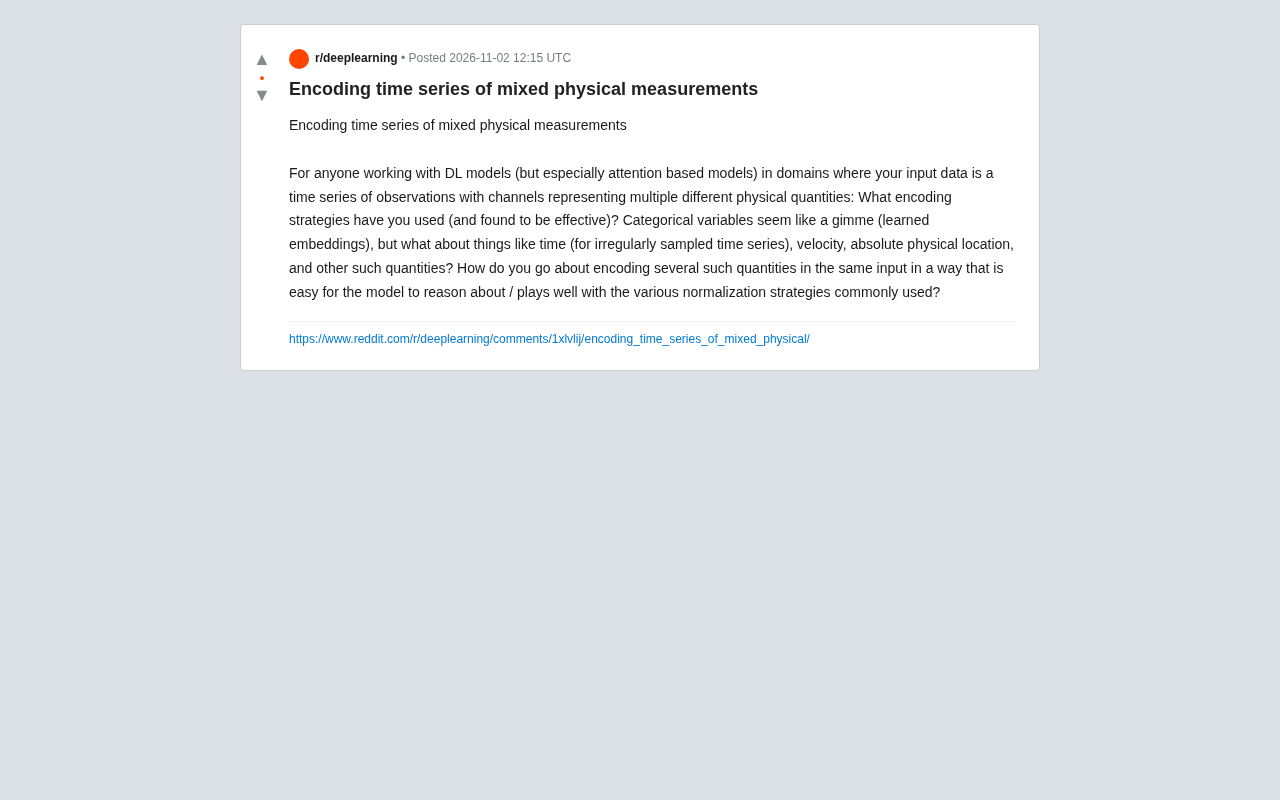
原帖作者指出,对于不规则采样的时间序列,每个通道代表不同的物理量(如时间、速度、位置等),编码策略需要同时处理类别变量和连续变量。类别变量通常使用学习到的嵌入(learned embeddings)即可,但连续物理量(如时间戳、速度、绝对位置)的编码则更具挑战性。作者特别询问了如何在同一输入中编码多种此类量,并使其与常见的归一化策略(如标准化、最小-最大缩放)良好配合。
这一问题的核心在于:不同物理量具有不同的量纲和分布,直接拼接或简单归一化可能导致模型难以捕捉它们之间的交互关系。此外,不规则采样时间序列中的时间信息本身也需要特殊处理,以反映观测之间的时间间隔。
不规则采样时间序列指观测时间点并非等间隔排列的序列,例如事件触发的传感器数据或医疗记录。处理此类数据时,模型不仅要学习观测值本身,还需理解观测之间的时间间隔所蕴含的信息。常见做法是将时间差(delta t)作为额外特征输入,或通过时间嵌入(time embedding)将连续时间映射到高维空间。时间嵌入可借鉴Transformer中的位置编码思想,但需适应连续时间域,例如使用可学习的高斯过程或周期性函数。与规则采样不同,不规则采样要求编码策略能动态反映时间间隔的变化,否则模型可能错误地假设观测是等距的,从而影响预测准确性。
社区观点:共识与分歧
据Reddit讨论中的多位从业者分享,目前较为一致的看法是:对于连续物理量,简单的归一化(如z-score标准化)后直接输入模型仍然是常见做法,但针对时间信息,需要额外编码。有观点认为,对于不规则时间序列,应将时间差(delta time)作为特征输入,或使用时间嵌入(time embedding)来捕捉周期性。
然而,关于绝对物理位置等量,存在分歧。一部分人主张直接归一化后输入,另一部分人则认为应使用相对位置编码或可学习的位置嵌入,因为绝对位置可能引入不必要的偏差。有评论提到,在机器人或物理模拟领域,相对位置编码往往更有效。
此外,有从业者强调,归一化策略需与编码方式协同设计。例如,若对速度进行归一化,应确保时间编码也处于相似的尺度范围,避免模型过度关注某一维度。
位置编码在序列建模中用于向模型提供元素顺序或位置信息。绝对位置编码为每个位置分配唯一的嵌入向量,常见于Transformer的正弦/余弦编码或可学习嵌入;相对位置编码则关注元素之间的相对距离,如Transformer-XL和Rotary Position Embedding(RoPE)中采用的方式。在混合物理量场景中,绝对位置编码可能引入与任务无关的偏差,尤其当物理位置本身具有绝对意义(如机器人全局坐标)时,模型可能过度依赖位置数值而忽略其他特征。相对位置编码则更关注元素间的空间关系,在机器人、物理模拟等领域往往更有效,因为它能更好地泛化到未见过的绝对位置。选择何种编码需结合任务是否对绝对位置敏感,以及数据分布是否可能偏移。
实用策略:来自一线的经验
综合讨论中的建议,以下策略被多次提及:
- 时间编码:对于不规则采样,使用时间差(delta t)的嵌入或将其作为连续特征输入。也可采用周期性编码(如正弦/余弦位置编码)处理绝对时间。
- 类别变量:使用学习到的嵌入层,并注意嵌入维度与连续特征维度的平衡。
- 连续物理量:标准化(z-score)是基础,但可考虑对每个物理量单独归一化,再通过线性投影映射到统一维度。
- 多量融合:早期融合(拼接)与晚期融合(分别编码后交互)各有优劣,需根据任务复杂度选择。有经验表明,对于注意力模型,将各物理量分别嵌入并添加类型标识(token type)有助于模型区分不同来源。
早期融合与晚期融合是多模态或混合特征建模的两种基本策略。早期融合指在输入层直接将不同特征拼接(concatenation)后送入模型,简单高效但可能因特征尺度差异导致模型难以学习交互;晚期融合指分别对每种特征独立编码,再在高层进行交互(如通过注意力机制或门控融合),能更好地保留各模态特性但计算开销较大。对于注意力模型,另一种有效做法是为每个物理量分配独立的嵌入层,并添加类型标识(token type embedding),使模型能区分不同来源的特征。类型标识类似于BERT中的segment embedding,可帮助注意力机制学习跨物理量的关系而不混淆语义。选择融合策略需权衡任务复杂度、数据量和计算资源。
归一化与编码的协同设计
讨论中反复提及的一个关键点是:归一化策略必须与编码方式协同设计。例如,若对速度进行最小-最大缩放,而时间差未归一化,模型可能难以平衡不同特征的贡献。有建议指出,可对每个物理量分别归一化,再通过可学习的缩放参数调整其重要性。此外,对于注意力模型,输入特征的尺度会影响注意力权重的分布,因此保持各特征尺度一致尤为重要。
注意力权重的尺度敏感性指在注意力机制中,查询(query)和键(key)的点积结果对输入特征的尺度非常敏感。若不同物理量的特征尺度差异较大(如速度归一化到[0,1]而时间差未归一化,范围在[0,100]),点积可能被大尺度特征主导,导致注意力权重分布失衡,模型过度关注某些维度。为缓解此问题,常见做法包括:对每个特征单独归一化至相近尺度;使用可学习的缩放参数调整各特征的重要性;或在计算注意力前对特征进行层归一化(LayerNorm)。此外,缩放点积注意力中的缩放因子(1/√d)仅解决维度问题,不解决特征尺度问题,因此协同设计归一化与编码至关重要。
结论与展望
混合物理量时间序列的编码尚无“一刀切”方案,但社区共识倾向于:对连续量进行归一化并辅以类型嵌入,对时间信息使用差分或周期编码,并确保归一化与编码协同。未来,随着更多领域(如机器人、气象、医疗)的应用,针对特定物理量的编码策略可能进一步细化。本文基于Reddit讨论整理,供从业者参考。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。