ICLR27数学理论论文评审引争议:理论无人问,实验遭围攻

ICLR27理论论文评审中审稿人普遍忽视数学贡献,引发对评审公平性与匹配机制的反思。
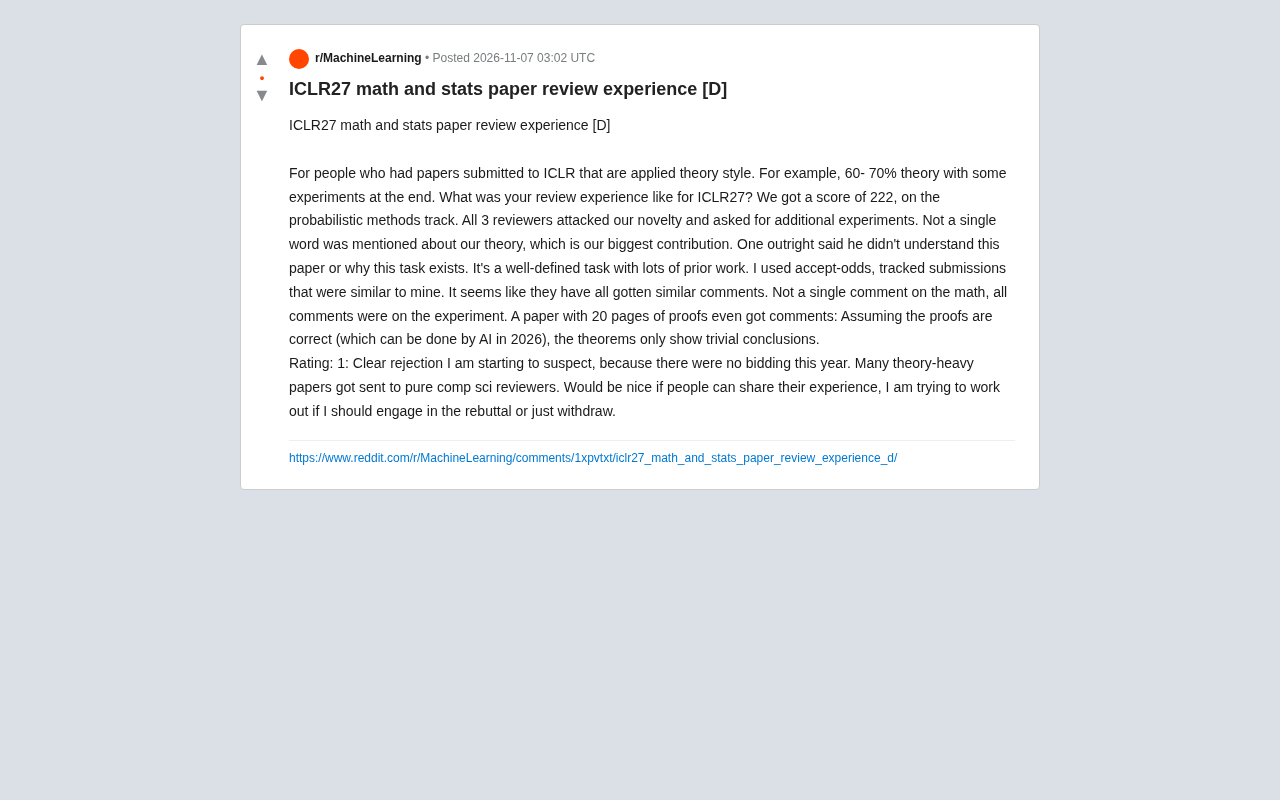
近日,Reddit上一位研究者分享其ICLR27投稿经历:一篇60-70%为理论推导的论文获得222评分,三位审稿人均攻击新颖性并要求补实验,却对核心理论贡献只字未提。该案例引发社区共鸣,多位研究者反映类似遭遇。作者推测ICLR取消bidding环节可能导致理论论文被分配给非理论背景审稿人,造成评审重心滑向实验部分。面对此类评审意见,作者陷入rebuttal或撤稿的两难。事件折射出机器学习顶会评审体系在投稿量激增下面临的结构性挑战:如何在提高分配效率的同时确保审稿人与论文领域的精准匹配,以及如何公正评价理论贡献。
引言:一场关于评审公平性的讨论
近日,Reddit上一位研究者分享了其向ICLR27投稿的亲身经历,引发了关于数学与统计类论文评审质量的广泛讨论。该论文属于应用理论风格,约60-70%为理论推导,末尾附有部分实验。最终在概率方法赛道获得了222的评分(三个审稿人均给出2分)。然而,三位审稿人无一例外地攻击了论文的新颖性并要求补充实验,却对作为核心贡献的理论部分只字未提。其中一位审稿人甚至直言“不理解这篇论文,也不明白这个任务为何存在”。
这一案例并非孤例。该研究者使用accept-odds工具追踪了多篇类似投稿,发现它们收到了相似的评论——没有任何关于数学的反馈,所有意见都集中在实验部分。更令人惊讶的是,一篇包含20页证明的论文也被评论道:“假设证明是正确的(2026年AI可以完成验证),这些定理只展示了平凡的结论。”
ICLR(International Conference on Learning Representations) 是机器学习领域的顶级会议之一,以开放评审(OpenReview)和强调表征学习著称。其审稿流程通常包括作者投稿、审稿人分配、评审打分、作者rebuttal、AC裁决等环节。近年来ICLR投稿量激增(2024年已破万),审稿人池急剧扩大,导致审稿质量参差不齐。bidding环节指审稿人在分配论文前,对候选论文表达审稿意愿的机制,有助于将论文分配给熟悉该领域的专家。取消bidding虽能提高分配效率,但可能削弱审稿人与论文的匹配度,尤其对理论性较强的论文影响显著。
评审意见的典型模式分析
理论贡献被系统性忽视
从描述来看,审稿意见呈现出高度一致的倾向:聚焦于实验设计的不足,而回避对理论深度的评价。这或许反映出审稿人知识结构的错配——当论文涉及较深数学推导时,非理论背景的审稿人倾向于将注意力转向自己更熟悉的实验环节。
上述案例中,审稿人要求补充实验,却未对理论的新颖性、正确性或重要性提出任何具体质疑。这种“避重就轻”的评审方式,使得理论贡献无法得到应有评价。
审稿人专业匹配度存疑
研究者推测,今年ICLR取消了bidding环节(审稿人主动选择熟悉领域的机制),可能导致大量理论性较强的论文被分配给纯计算机科学背景的审稿人。这一猜测虽无法证实,但确实指向了评审分配机制中可能存在的系统性问题:当审稿人与论文领域不匹配时,评审质量会显著下降。
222评分指ICLR审稿评分系统中的三个分值,通常范围是1-10分(1为强烈拒稿,10为强烈接收)。222意味着三位审稿人均给出2分,属于较低评分,通常对应“ reject”倾向。在ICLR的评审体系中,最终决定由领域主席(AC)综合审稿意见和作者rebuttal做出,但低分论文进入讨论环节的概率较低。accept-odds工具是一种基于历史审稿数据预测论文接收概率的第三方工具,作者可通过输入评分、审稿意见等特征估算最终结果,常用于投稿策略分析。
应用理论风格论文通常指介于纯理论与纯实验之间的工作:既包含严格的数学建模、定理证明和复杂度分析,又辅以实验验证理论结论或展示实际效果。此类论文的评审挑战在于,审稿人需同时具备理论功底和实验判断力。若审稿人仅熟悉实验方法,则容易将评审重心放在实验规模、基线选择等表面问题上,而无法评估定理的新颖性、证明技巧的难度或假设的合理性。这种知识结构错配是理论论文评审困境的核心原因之一。
社区反应与共性困境
该帖引发了多位研究者的共鸣。不少回复者表示,自己投往ICLR的理论论文也遭遇了类似情况:审稿意见集中在实验规模、基线选择等表面问题上,而对定理的证明思路、假设合理性等核心内容缺乏深入讨论。这种模式化的评审反馈,让作者难以从 rebuttal 中获得有价值的改进方向。
说个细节,有评论指出,即使审稿人承认“假设证明正确”,也仅将其结论定性为“平凡”。这种评价方式回避了对证明技术难度的具体分析,本质上是一种“不评价的评价”。
作者的两难:rebuttal还是撤稿?
原帖作者在文末提出了一个现实问题:面对这样的评审意见,是应该投入精力进行 rebuttal,还是直接撤稿改投?
从策略上看,rebuttal 的有效性取决于审稿人是否愿意重新审视理论贡献。如果审稿人本身缺乏相关背景,即使作者详细解释定理价值,也可能难以改变其固有判断。然而,撤稿意味着放弃本次会议的机会,并可能延误发表进度。
社区讨论中,有建议认为,作者可以在 rebuttal 中礼貌地指出审稿意见与论文核心贡献之间的错位,并请求领域主席(AC)介入,或建议引入更匹配的审稿人。但这一做法的成功率并不确定。
Rebuttal是会议评审中作者对审稿意见进行正式回应的环节,通常持续1-2周。作者可逐条反驳审稿人的质疑、澄清误解、补充实验或理论说明。在ICLR中,rebuttal后审稿人可更新评分,AC最终裁决。然而,rebuttal的效果高度依赖审稿人的开放态度和专业背景:若审稿人缺乏相关领域知识,即使作者详细解释,也可能难以改变其判断。撤稿改投则意味着放弃当前会议机会,将论文转投其他会议或期刊,可能延误发表进度,但有时能避免因审稿人不匹配而导致的不公正评价。
对评审机制的反思
这一事件折射出机器学习顶会评审体系面临的结构性挑战。随着投稿量持续增长,审稿人池的扩大不可避免,但如何确保审稿人与论文领域的精准匹配,仍是未解决的难题。取消 bidding 或许是为了提高分配效率,却可能牺牲了匹配质量。
对于理论类论文而言,评审的困境尤为突出:理论贡献的价值往往需要同行专家才能准确判断,而实验部分则相对容易评价。当审稿人缺乏理论背景时,评审重心自然滑向实验,导致理论创新被低估。
结语
ICLR27的这次分享,为学术社区提供了一个观察评审生态的窗口。它提醒我们,在追求评审效率的同时,不能忽视评审的专业性与公平性。对于作者而言,面对不匹配的评审意见,除了在 rebuttal 中积极沟通,或许也需要在投稿策略上做出更审慎的选择。
(注:文中引用的评分、审稿意见均来自原帖描述。)
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。