Infrathon基准:AI智能体长周期优化真实基础设施

Infrathon 用 24 小时长周期基准证明短周期评估会误判模型排名并低估优化收益。
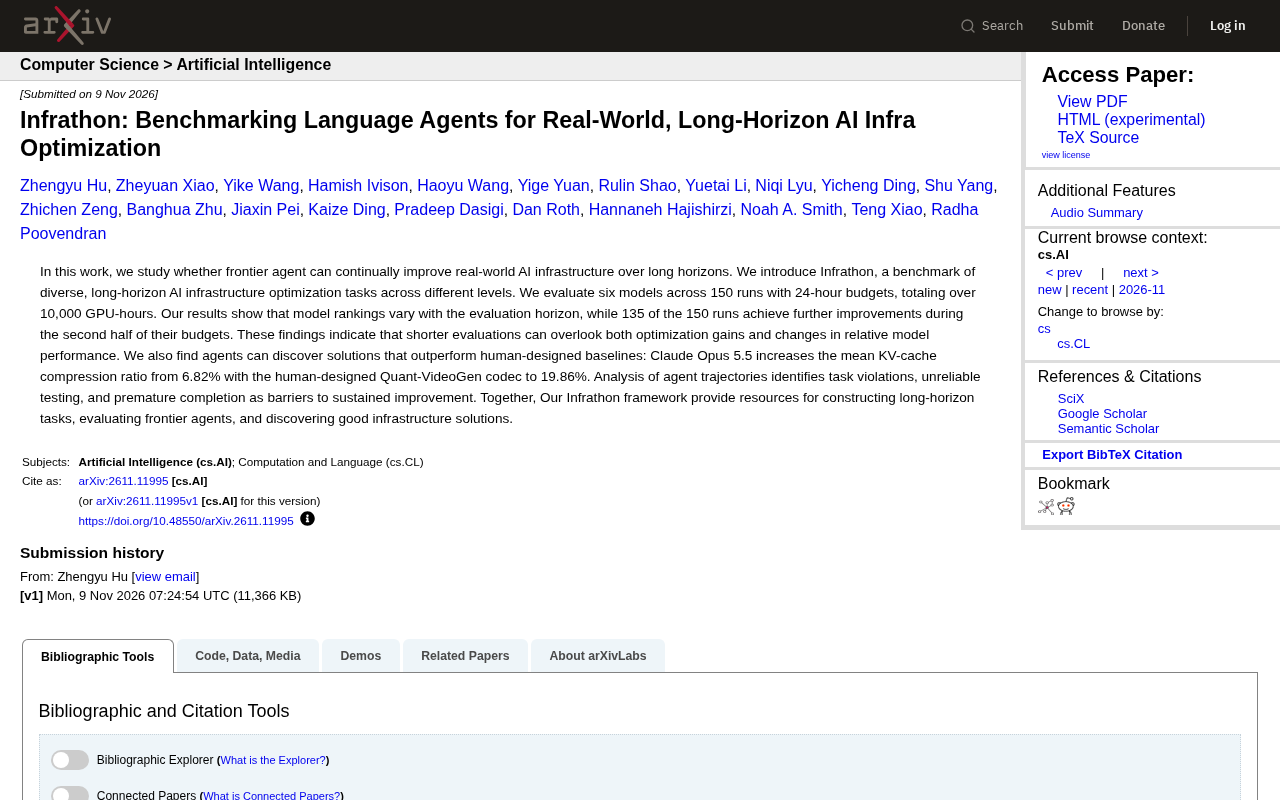
Infrathon 研究构建了面向真实 AI 基础设施优化的长周期基准,对六个前沿模型进行 150 次运行评估,每次给予 24 小时预算,总计消耗超过 10,000 GPU 小时。核心发现是模型排名会随评估周期变化,150 次运行中有 135 次在预算后半段仍取得进一步改进,说明短周期评估会同时低估优化收益和模型间相对性能差异。智能体还能超越人类设计基线,例如 Claude Opus 5.5 将 KV-cache 平均压缩率从 6.82% 提升至 19.86%。研究同时识别出任务违规、不可靠测试和过早完成三大持续改进障碍,并指出长周期真实环境评估将成为智能体能力研究的重要方向。
为什么需要长周期评估?
当前对语言模型智能体的评估大多集中在短周期任务上,例如代码生成、问答或简单工具调用。然而,真实世界的 AI 基础设施优化往往需要数小时甚至数天的持续迭代——调整编解码器参数、搜索缓存策略、平衡计算与存储开销。短周期的评测能否反映智能体在这类任务上的真实能力?一项名为 Infrathon 的新研究给出了否定的答案。
该研究构建了一个面向真实 AI 基础设施优化的长周期基准,覆盖不同层次的多样化任务,并对六个前沿模型进行了 150 次运行评估,每次运行给予 24 小时预算,总计消耗超过 10,000 GPU 小时。核心发现是:模型排名会随评估周期变化,且短周期评估会同时低估优化收益和模型间的相对性能差异。
关键发现:时间越长,格局越不同
排名并非一成不变
在 150 次运行中,有 135 次在预算的后半段仍取得了进一步改进。这意味着如果只观察前几个小时的表现,不仅会错过大量优化空间,还可能对哪个模型更强做出错误判断。研究明确指出,短周期评估会同时忽略优化增益和相对模型表现的变化。对于需要选型的工程团队而言,这提示我们:用短任务跑分来预测长周期表现存在风险。
短周期评估通常指任务在数分钟到数小时内即可完成,依赖单次或少量交互就能给出分数,例如 HumanEval 式的代码生成或单轮问答。长周期评估则要求智能体在数小时到数天的时间跨度内持续与环境交互、反复实验并累积改进。两者的关键差异不只是时间长短,而是长周期任务天然包含探索、失败、修正和再评估的闭环,智能体需要自行管理实验记录、分配预算并判断何时收敛。因此,短周期分数衡量的是单步能力上限,长周期分数衡量的是持续优化能力,二者并不必然相关,这也是该研究强调模型排名会随评估窗口变化的根本原因。
智能体可以超越人类设计
更引人注目的是,智能体能够发现优于人类设计基线的解决方案。以 KV-cache 压缩任务为例,Claude Opus 5.5 将平均压缩率从人类设计的 Quant-VideoGen 编解码器的 6.82% 提升到了 19.86%。这一结果说明,在足够长的优化周期内,前沿智能体具备探索出非直觉优化路径的潜力。
KV-cache(键值缓存)是 Transformer 推理时保存历史 token 的 Key 和 Value 向量的机制,用于避免自回归生成中重复计算注意力。随着上下文增长,KV-cache 的显存占用会线性上升,成为长上下文推理的主要瓶颈之一。压缩 KV-cache 的常见手段包括量化(降低每个元素的位宽)、低秩分解、稀疏化以及按 head 或 layer 选择性丢弃。Quant-VideoGen 是研究中作为对照的人类设计编解码器方案,6.82% 的平均压缩率代表人类专家在该任务上的基线水平。压缩率越高意味着同等显存下可支撑更长上下文或更大批量,因此从 6.82% 到 19.86% 的提升在工程上具有实际意义。
持续改进的三大障碍
通过对智能体轨迹的分析,研究识别出阻碍持续改进的三类问题:任务违规、不可靠的测试以及过早完成。任务违规指智能体偏离了任务约束;不可靠的测试意味着自建的验证手段可能给出错误信号;过早完成则是智能体在仍有优化空间时停止迭代。这些问题在短周期评估中往往被掩盖,却在长周期任务中成为性能瓶颈。
任务违规、不可靠测试与过早完成这三类障碍,本质上反映了长周期智能体缺少可靠的自我验证机制。在短任务中,智能体可以依赖外部单元测试或标准答案即时判断对错;而在基础设施优化这类开放任务中,目标函数往往需要实际跑基准才能测量,智能体不得不自行搭建验证流程。一旦验证脚本本身有 bug 或测量噪声过大,智能体就会沿着错误信号继续优化,甚至把违规操作误判为有效改进。过早完成则与智能体对剩余优化空间的估计能力有关:它倾向于在指标不再明显上升时停止,而长周期任务中的收益常常来自平台期之后的策略切换。这三类问题共同指向一个研究方向——为长周期智能体设计鲁棒的自验证与预算管理机制。
对 AI 基础设施实践的意义
Infrathon 的价值不仅在于一个排行榜。它提供了一套构建长周期任务、评估前沿智能体并发现优质基础设施方案的框架资源。对于从事推理优化、存储压缩或调度系统建设的团队,这意味着可以将智能体纳入真实的优化闭环,而不是仅用于生成代码片段。
同时,该研究也提醒我们关注评估方法论本身:当智能体的能力边界不断扩展,评测的设计必须跟上任务的时间尺度。短平快的基准仍然有用,但它们无法替代对持续优化能力的考察。
局限与展望
当前工作覆盖了六个模型和特定类型的基础设施任务,结论能否推广到更广泛的系统优化场景仍需验证。此外,如何自动检测任务违规和不可靠测试,仍是构建可靠长周期智能体系统的开放问题。但可以肯定的是,长周期、真实环境的评估将成为智能体能力研究的重要方向。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。