jcode:用Rust重写的编程Agent,内存省13倍支持多Agent协作

编程Agent的内存困境
随着AI编码助手的普及,Claude Code、Codex等工具已经成为不少开发者的日常伙伴。但这类工具有一个容易被忽视的问题——资源消耗。据B站UP主XCommand的实测数据,Claude Code 单个会话就要吃掉 386MB 内存,如果你习惯同时开多个会话来并行处理任务,内存占用会迅速膨胀。
这背后其实是技术选型的必然结果。大多数主流编程Agent基于 Node.js/TypeScript 技术栈构建,运行时本身就有较高的内存开销,再叠加上下文管理、模型交互等逻辑,单会话数百兆的占用并不意外。Node.js 基于 Google 的 V8 JavaScript 引擎运行,V8 引擎本身就需要占用一定的基础内存来维护堆空间、JIT编译器和垃圾回收器等基础设施。一个空白的 Node.js 进程通常就要消耗 30-50MB 内存,而当加载大量依赖库(如 TypeScript 编译器、HTTP 客户端、JSON Schema 验证器等)后,基线内存很容易膨胀到上百兆。此外,V8 的垃圾回收机制采用分代策略——新生代使用 Scavenge 算法(本质是 Cheney 复制算法,将新生代空间一分为二,存活对象在 From 空间和 To 空间之间复制,以空间换时间实现快速回收)进行快速回收,老生代则使用标记-清除和标记-整理算法。为了减少 GC 暂停频率和持续时间,V8 会主动保留较大的堆空间余量(通常是实际活跃对象大小的 1.5-2 倍),这进一步推高了实际内存占用。值得注意的是,V8 默认将堆上限设置为约 1.5GB(64位系统),这意味着即使应用实际只用了几百兆,GC 也会在这个范围内「宽松」地管理内存。近年来 V8 引入了增量标记(Incremental Marking)和并发标记(Concurrent Marking)等优化手段来减少主线程暂停时间,但这些优化本身也需要额外的内存开销来维护标记状态和工作队列。对于需要维护长上下文对话历史的编程 Agent 而言,每一轮对话都会产生大量字符串对象和嵌套的 JSON 数据结构,而 JavaScript 中字符串采用 UTF-16 编码(每个字符至少 2 字节,即使是纯 ASCII 文本也需要双倍存储空间),JSON 对象的属性名也会被内部化存储(V8 的 Internalized String 机制会将频繁出现的字符串去重并缓存,虽然节省了重复存储但增加了哈希表的内存开销),这些堆积使得内存压力更为显著。对于内存有限的开发机,或者需要长时间挂着多个Agent协作的场景,这就成了实实在在的痛点。
今天要聊的 jcode(G-Code) 正是瞄准这一痛点而来——它用 Rust 重写了整个编码Agent,主打「省内存」和「多Agent并行」。目前该项目已在 GitHub 上收获超过 13K star,说明社区对这个方向的认可度相当高。
安装与使用:一行命令上手,用法对齐Claude Code
jcode 的安装非常轻量,只需一行命令即可完成:
extend store jcode
装完之后直接敲入 jcode 就能进入交互式对话界面。
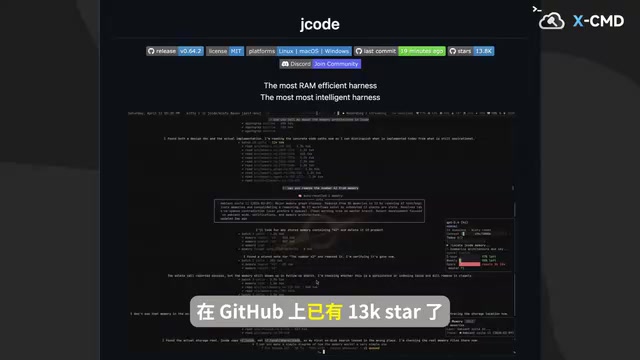
从界面设计上看,jcode 与 Claude Code 有比较明显的区别,视觉风格更贴近 Rust 生态工具的简洁质感——类似于 ripgrep、bat、fd 等现代命令行工具的设计哲学:信息密度高、色彩克制、响应迅速。这些工具有一个共同特点:它们都是用 Rust 重写了传统 Unix 工具(分别对应 grep、cat、find),在保持功能兼容的同时实现了数倍甚至数十倍的性能提升,形成了所谓的「Rust CLI 新浪潮」。但在实际用法上,两者基本一致——如果你已经熟悉 Claude Code 或 Codex 的交互逻辑,几乎可以零成本迁移到 jcode。
这种「体验对齐」的策略很聪明。它降低了用户的学习门槛,让开发者能够在保留原有工作习惯的前提下,直接享受到 Rust 带来的性能红利,而不需要重新适应一套全新的操作范式。这也符合开发者工具领域的一个重要设计原则:性能优化应该是透明的,不应以牺牲用户体验的一致性为代价。在软件设计中,这被称为「最小惊讶原则」(Principle of Least Astonishment)——用户在使用新工具时的体验应尽可能与其既有认知模型一致,减少认知负荷。
内存对比:单会话省13倍,多会话差距更悬殊
jcode 最核心的卖点,就是它在资源效率上的碾压级表现。根据实测:
- 单会话:Claude Code 占用 386MB,jcode 仅占用 27.8MB,相差约 13.9倍
- 10个会话并行:Claude Code 吃掉 2.3GB 内存,而 jcode 只需 117MB
可以看到,会话数量越多,两者的差距被拉得越大。单会话时是十几倍的差距,到了10个会话,Claude Code 已经接近吃满一台低配笔记本的内存(主流轻薄本通常只有8-16GB内存,2.3GB意味着占据了总内存的15-30%),而 jcode 依然维持在百兆出头的水平。这里还需要考虑到操作系统的内存管理机制——当物理内存不足时,系统会将不活跃的内存页交换到磁盘(Swap),导致严重的性能下降,尤其是在使用 SSD 而非 NVMe 硬盘的老旧设备上,频繁的 Swap 操作会让整个系统变得极度卡顿。
这个差距的根源在于 Rust 的语言特性——没有垃圾回收器、内存布局更紧凑、运行时开销极低。Rust 采用独特的所有权(Ownership)和借用检查(Borrow Checker)系统,在编译期就确保了内存安全,完全不需要运行时垃圾回收器。所有权系统的核心规则是:每个值在任一时刻只有一个所有者,当所有者离开作用域时值被自动释放(通过自动调用 Drop trait 实现,类似 C++ 的 RAII 模式);借用检查器则确保在任一时刻,要么存在一个可变引用,要么存在多个不可变引用,但两者不能共存。这套机制在编译时就消除了数据竞争和悬垂指针的可能性,这也是为什么 Rust 社区常说「如果你的程序能编译通过,它在内存安全方面就基本不会有问题」。这意味着 Rust 程序不会像 Java、Go 或 Node.js 那样需要额外的 GC 线程和堆空间预留——没有 GC 暂停(Stop-the-World,即垃圾回收器为了保证堆状态一致性而暂时冻结所有应用线程的操作),没有写屏障(Write Barrier,GC 用来跟踪引用关系变化的运行时检查代码,每次指针赋值都会触发),没有对象引用图的遍历开销。
Rust 的数据结构在内存中是零开销抽象的——结构体按字段紧密排列(类似 C 语言的 struct,编译器会根据目标平台的对齐要求自动填充,但开发者可以通过 #[repr(packed)] 或 #[repr(C)] 精确控制布局),枚举类型使用标签联合体(Tagged Union,只占用最大变体的空间加上一个用于区分变体的标签字节),不存在对象头、虚表指针等额外开销(除非显式使用 trait object 进行动态分发)。以一个包含字符串和整数的结构体为例,Rust 中它只占据字符串指针(8字节)+ 长度(8字节)+ 容量(8字节)+ 整数(4-8字节)的空间,而在 JavaScript 中同等数据需要 V8 对象头(至少16字节,包含 Map 指针和属性/元素存储指针)+ 隐藏类指针(V8 的 Hidden Class 机制用于优化属性访问,但每个不同「形状」的对象都需要一个独立的隐藏类实例)+ 属性存储等额外开销,实际内存消耗可能是 Rust 的 3-5 倍。编译后生成的是原生机器码二进制文件,启动时无需加载虚拟机或解释器,冷启动时间可以做到毫秒级。此外,Rust 的字符串默认使用 UTF-8 编码(String 和 &str 类型),对于以英文和代码为主的编程 Agent 场景,UTF-8 相比 JavaScript 的 UTF-16 可以节省近一半的字符串存储空间。这些特性使得 Rust 特别适合构建需要长时间运行、多实例部署的系统级工具。
对于需要长时间运行、多实例并行的Agent场景,这种内存优势会转化为实打实的成本节约和稳定性提升。你可以在一台普通开发机上同时跑更多的Agent,而不必担心内存被拖垮。在云端部署场景下,内存节约还意味着可以选择更小规格的实例,直接降低云服务账单。以 AWS 为例,从 t3.large(8GB内存,约$0.083/小时)降级到 t3.small(2GB内存,约$0.021/小时)就能节省约75%的计算成本,对于需要长期运行多个编码Agent的团队来说,这是非常可观的节约。
除了内存,jcode 的启动速度比 Copilot 快 108 倍,这同样得益于 Rust 编译后的原生二进制无需启动庞大的运行时,冷启动几乎是瞬时的。Node.js 程序启动时需要经历「加载V8引擎 → 初始化内置模块(fs、net、crypto等数十个核心模块)→ 解析并编译JavaScript源码(包括将源码转为抽象语法树AST、生成字节码、以及V8的TurboFan编译器对热点代码的即时优化编译)→ 执行模块初始化逻辑(解析 package.json、递归加载 node_modules 中的依赖树)」这一完整链路,通常需要数百毫秒甚至数秒。而 Rust 的原生二进制直接由操作系统加载到内存并跳转到入口点执行,整个过程在单位毫秒内完成。这种启动速度差异在交互式使用场景中体感明显——当你需要快速启动一个Agent处理临时任务时,瞬时启动意味着零等待,而数秒的启动延迟会显著打断工作流。
SWARM蜂群模式:让多个Agent协同作战
省内存只是基础,jcode 真正想做的是把「多Agent并行」这件事做扎实。它设计了一套 SWARM(蜂群)模式,让多个Agent能在同一个代码仓库里协作完成任务。
SWARM(蜂群)这一概念源自群体智能(Swarm Intelligence)理论,灵感来自蚂蚁、蜜蜂等社会性昆虫的集体行为模式——每个个体遵循简单规则,但群体层面涌现出复杂的协调能力。这一理论最早由 Gerardo Beni 和 Jing Wang 在1989年提出,后来在优化算法领域催生了蚁群优化(ACO)和粒子群优化(PSO)等经典算法。在多 Agent 系统中,蜂群模式强调去中心化协作:每个 Agent 拥有局部信息和自主决策能力,通过轻量级的消息传递机制实现全局协调,类似于蚁群通过信息素(Pheromone)间接通信的「stigmergy」机制——即个体通过改变环境来间接影响其他个体的行为,而非直接点对点通信。这与传统的中心化任务调度模式形成对比——后者需要一个「主控Agent」分配所有子任务,一旦主控失败整个系统瘫痪(单点故障问题)。蜂群模式的弹性更强,某个 Agent 失败不影响其他 Agent 继续工作,系统整体表现出优雅降级(Graceful Degradation)的特性。值得一提的是,OpenAI 在2024年也开源了名为 Swarm 的多Agent编排框架,可见「蜂群式」多Agent协作正在成为行业共识。
在 SWARM 模式下,各个Agent具备以下能力:
自动感知彼此的改动冲突
当多个Agent同时修改同一个仓库时,最大的风险就是改动互相覆盖或产生冲突。jcode 让Agent之间能够自动感知对方的改动,及时发现潜在冲突,避免「你改你的、我改我的」造成的混乱。
从技术实现角度来看,多 Agent 的冲突检测本质上是一个分布式系统中的并发控制问题,与数据库系统中的事务隔离(如 MVCC 多版本并发控制)和版本控制系统中的合并冲突检测属于同一类挑战。常见的实现策略包括:基于文件锁的悲观并发控制(类似数据库的排他锁,简单但可能导致 Agent 阻塞等待,降低并行效率)、基于文件系统事件监听(如 Linux 的 inotify、macOS 的 FSEvents、Windows 的 ReadDirectoryChangesW)的实时变更通知、以及类似 Git 的三路合并算法(Three-Way Merge)进行冲突判定——通过比较共同祖先版本(Base)、本地修改版本(Ours)和远端修改版本(Theirs)来精确定位冲突行,只有当两个版本相对于基线都修改了同一区域时才判定为真正的冲突。jcode 很可能结合了文件系统事件监听和内存中的变更状态共享——当一个 Agent 修改某个文件时,其他 Agent 通过共享状态或进程间通信(IPC,如 Unix Domain Socket 或共享内存映射 mmap)获知这一变更,进而判断是否与自己的待提交修改存在重叠区域。这种机制在 Rust 中实现效率极高,因为 Rust 的无锁数据结构(如基于 CAS——Compare-And-Swap 原子操作的 lock-free queue,以及 crossbeam 库提供的无锁并发原语)和零成本异步运行时(如 tokio,它基于 epoll/kqueue 实现的多路复用 I/O,单个线程就能高效处理成千上万个并发事件源)能够以极低开销处理高频的状态同步,不会因为监听文件变更而显著增加 CPU 或内存负担。
互相发消息协调
Agent 之间可以互相发送消息进行沟通协调。当某个Agent发现自己的任务与其他Agent存在依赖或冲突时,可以主动发起协商,就像一个真实的开发团队在内部同步进度一样。这种 Agent 间通信模式在学术上被称为 Agent Communication Language(ACL),早在 FIPA(Foundation for Intelligent Physical Agents,成立于1996年的IEEE计算机协会标准组织)标准中就有详细定义,包括 inform(通知)、request(请求)、propose(提议)、accept/reject(接受/拒绝)等标准化的通信行为(Communicative Acts)。不过 jcode 的实现很可能采用了更轻量的方案——基于结构化消息的点对点或广播通信,消息内容可能包含「我正在修改哪些文件」「我的任务进展到哪一步」「我需要等待谁的结果」等语义信息,让 Agent 能够基于这些上下文做出更智能的协调决策。在实际的多Agent编程场景中,常见的协调模式包括:顺序依赖(Agent B 需要等待 Agent A 完成接口定义后才能开始编写实现)、资源竞争(多个 Agent 都需要修改同一个配置文件)、以及信息聚合(一个 Agent 需要收集其他多个 Agent 的输出来生成最终报告)。
自主派生子Agent
当任务需要进一步拆分并行时,Agent 可以自主派生(spawn)出子Agent来分担工作。这意味着 jcode 不只是「多个独立Agent同时跑」,而是构建了一个能够动态扩展、自我组织的Agent协作网络。在软件工程实践中,这类似于微服务架构中的服务编排(Service Orchestration),只不过这里的「服务」是具有 AI 推理能力的自治实体,能够根据任务复杂度自主决定是否需要拆分和委派。这种模式也呼应了计算机科学中的 Actor 模型——由 Carl Hewitt 在1973年提出的并发计算模型,每个 Agent 就是一个 Actor,拥有自己的私有状态和邮箱(消息队列),通过异步消息传递与其他 Actor 交互,需要时创建新的 Actor 来处理子问题。Actor 模型的核心优势在于它天然避免了共享状态带来的并发问题:每个 Actor 串行处理自己邮箱中的消息,不存在多线程竞争条件。Rust 生态中的 Actix 框架正是这一模型的典型实现,而 Erlang/OTP 的 Supervisor 树则展示了 Actor 层级化管理(父 Actor 监控子 Actor 的生命周期,失败时自动重启)的成熟实践。jcode 的架构设计很可能借鉴了类似思路,通过父Agent对子Agent的监督来保证整体任务的可靠完成。
正是因为单个Agent的内存占用极低(27.8MB),SWARM 模式才具备实用价值——如果每个Agent都要吃掉几百兆内存,那么开十几个协作Agent的想法根本无法在单机上落地。以一台 16GB 内存的开发机为例,除去操作系统和其他应用的开销(通常占用 4-6GB),Claude Code 最多只能同时运行约 4-5 个会话,而 jcode 理论上可以同时运行上百个 Agent 实例。低内存 + 多Agent并行,这两个特性形成了相辅相成的技术闭环。这种「资源高效 → 并行规模化 → 任务完成速度提升」的链式效应,正是系统级优化带来的杠杆效果。
总结:垂直优化带来的差异化竞争力
jcode 的出现给编程Agent领域提供了一个有意思的思路:与其在功能上盲目堆料,不如在「资源效率」这个被主流工具忽视的维度上做垂直优化。
它用 Rust 换来了十几倍的内存优势和上百倍的启动速度,再基于这个底座构建出 SWARM 多Agent协作模式,逻辑上是自洽且有说服力的。这也反映了系统软件领域的一个经典规律:底层基础设施的效率提升往往能解锁上层全新的应用范式——就像容器技术的轻量化(Docker容器相比虚拟机减少了Guest OS的资源开销)催生了微服务架构,WebAssembly 的接近原生性能催生了浏览器端的重型应用,Rust 带来的极致资源效率使得多 Agent 协作从理论概念变为工程可行。历史上类似的例子还包括:固态硬盘的随机读写性能解锁了数据库的 LSM-Tree 架构,GPU 并行计算能力的提升催生了深度学习革命。对于重度使用编程Agent、追求多任务并行、或者在资源受限环境下工作的开发者来说,jcode 值得一试。
当然,需要提醒的是,本文数据主要来自单一来源(B站UP主XCommand)的实测演示,实际使用中的模型效果、稳定性、生态成熟度还需要读者自己进一步验证。选择编程 Agent 时,内存效率只是众多考量因素之一——模型能力的上限(不同LLM在代码生成、理解和调试方面的能力差异显著)、工具生态的完善度(如 MCP 协议支持、IDE 集成、版本控制集成)、社区活跃度和长期维护承诺同样重要。此外,Rust 生态虽然在性能方面表现卓越,但其生态库的丰富度和成熟度与 Node.js/npm 生态相比仍有差距,这可能影响到插件开发和功能扩展的便利性。但无论如何,一个占用27MB内存就能跑起来的编码Agent,光是这一点就足够吸引人去尝试了。
核心要点
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。