Jev AI在6项基准测试中5项匹敌或超越LLM:延迟与成本优势显著

Jev AI在六项基准中五项匹敌或超越大模型Luna,兼具低延迟低成本优势。
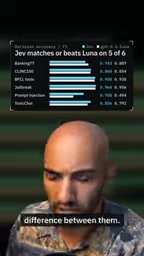
文章基于YouTube视频分析,介绍Jev AI与名为Luna的LLM在六项基准测试中的对比结果:Jev在其中五项持平或超越Luna,唯一失利是银行业意图分类基准,Luna得分为77。Jev的优势集中在护栏类测试,提示注入与毒性检测两项显著领先,说明其在安全性与合规性上更适合需要严格内容控制的场景。同时,Jev在延迟和成本上明显低于Luna,尽管原文未给出具体数值,但这使它在实时响应和大规模部署中更具性价比。文章认为,Jev为特定应用场景提供了有竞争力的替代方案,随着模型继续优化,其适用范围有望进一步扩大。
小模型挑战大模型:Jev AI的基准测试表现
据YouTube视频分析,Jev AI在六项基准测试中,有五项性能与名为Luna的LLM(大型语言模型)持平或超越。考虑到两者在延迟和成本上的显著差异,这一结果令人印象深刻。
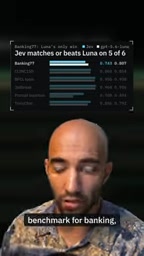
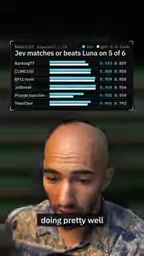
视频指出,Jev在大多数测试中要么匹配、要么超越Luna。唯一失手的是一项针对银行业的意图分类基准( banking 77 ),Luna在该项上表现更优。而在其余测试中,Jev表现良好,尤其是在护栏(guardrail)相关基准上。
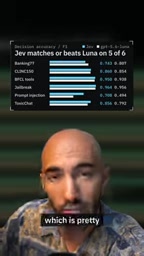
唯一失利:银行业意图分类
视频中明确提到,Luna唯一胜出的基准是银行业的意图分类任务,得分为77。该测试可能涉及对银行客户查询的意图识别,Luna在此场景下展现了优势。但除此之外,Jev在其余五项基准中均不落下风。
意图分类(Intent Classification) 是自然语言处理中的一项基础任务:给定一句用户输入,模型需要判断其所属的预定义类别,例如“查询余额”“挂失银行卡”“投诉手续费”等。银行业场景对意图分类的要求格外苛刻,因为类别体系往往很细、术语专业性强,且同一句话可能含有歧义或口语化表达。评测中常见的“77”通常指准确率或 F1 分数等指标数值。意图分类结果直接决定后续对话路由是否走向正确的业务流程,因此这一基准上的差距意味着小模型在需要精细领域知识的任务上仍可能落后于大模型。
护栏测试表现突出
Jev在护栏相关基准上表现尤为突出。视频指出,在提示注入(prompt injection)和毒性检测(toxic check)两项测试中,Jev显著超越Luna。这表明Jev在安全性和合规性方面具有优势,对于需要严格内容控制的应用场景可能更具吸引力。
提示注入(Prompt Injection) 指攻击者在输入中夹带指令,试图覆盖或绕过系统预设的行为约束,例如让模型忽略安全规则、泄露系统提示词或执行越权操作。毒性检测(Toxic Check) 则要求模型识别并拦截仇恨、骚扰、暴力等不当内容。两者同属“护栏(Guardrail)”范畴,即部署在模型输入输出两侧的安全防线。护栏能力强的模型更适合面向终端用户开放的产品,因为它在被恶意诱导时更不容易失守。小模型若能在这些基准上超过大模型,往往得益于针对安全对齐的专门训练或更保守的拒答策略。
延迟与成本:Jev的隐藏优势
视频强调,Jev与Luna在延迟和成本上存在显著差异。尽管未给出具体数值,但Jev能在保持性能的同时降低延迟和成本,这使其在实际部署中可能更具性价比。对于需要实时响应或大规模部署的场景,这一优势尤为关键。
延迟(Latency) 通常指从发出请求到收到首个 token 或完整响应的时间,直接决定交互体验是否流畅;成本 则多以每百万 token 的输入/输出价格衡量,规模越大差距越明显。小模型参数量少、推理所需的算力与显存更低,因此在同等硬件上往往能实现更高吞吐和更低单次调用成本。但性能与成本通常存在权衡,小模型常在复杂推理上吃亏。Jev 的意义在于:它在多数基准上没有被这一权衡明显拖累,使得“用更小更快的模型承担大部分流量、只把难题交给大模型”的级联架构成为可行选择。
总结与展望
Jev AI在多数基准测试中匹配或超越LLM,尤其在护栏测试中表现亮眼,仅在银行业意图分类上略逊一筹。结合其延迟和成本优势,Jev为特定应用场景提供了有竞争力的替代方案。未来,随着模型进一步优化,其应用范围有望扩大。
背景补充
需要说明的是,基准测试只能反映特定任务分布下的表现,并不等同于真实业务效果。文中提到的六项基准覆盖意图分类与安全护栏等维度,但样本规模、评测方式与提示词设计都会影响结论;延迟和成本优势也缺少具体数值支撑。因此更稳妥的解读是:Jev 在“安全护栏 + 常规分类”这类边界清晰的任务上可作为大模型的低成本替代,而在需要深层领域知识与细粒度判断的场景(如银行业意图分类)仍应保留大模型或采用混合路由策略,并通过自有数据做上线前的对照评估。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。