Jev:为软件自动化而生的结构化AI决策引擎
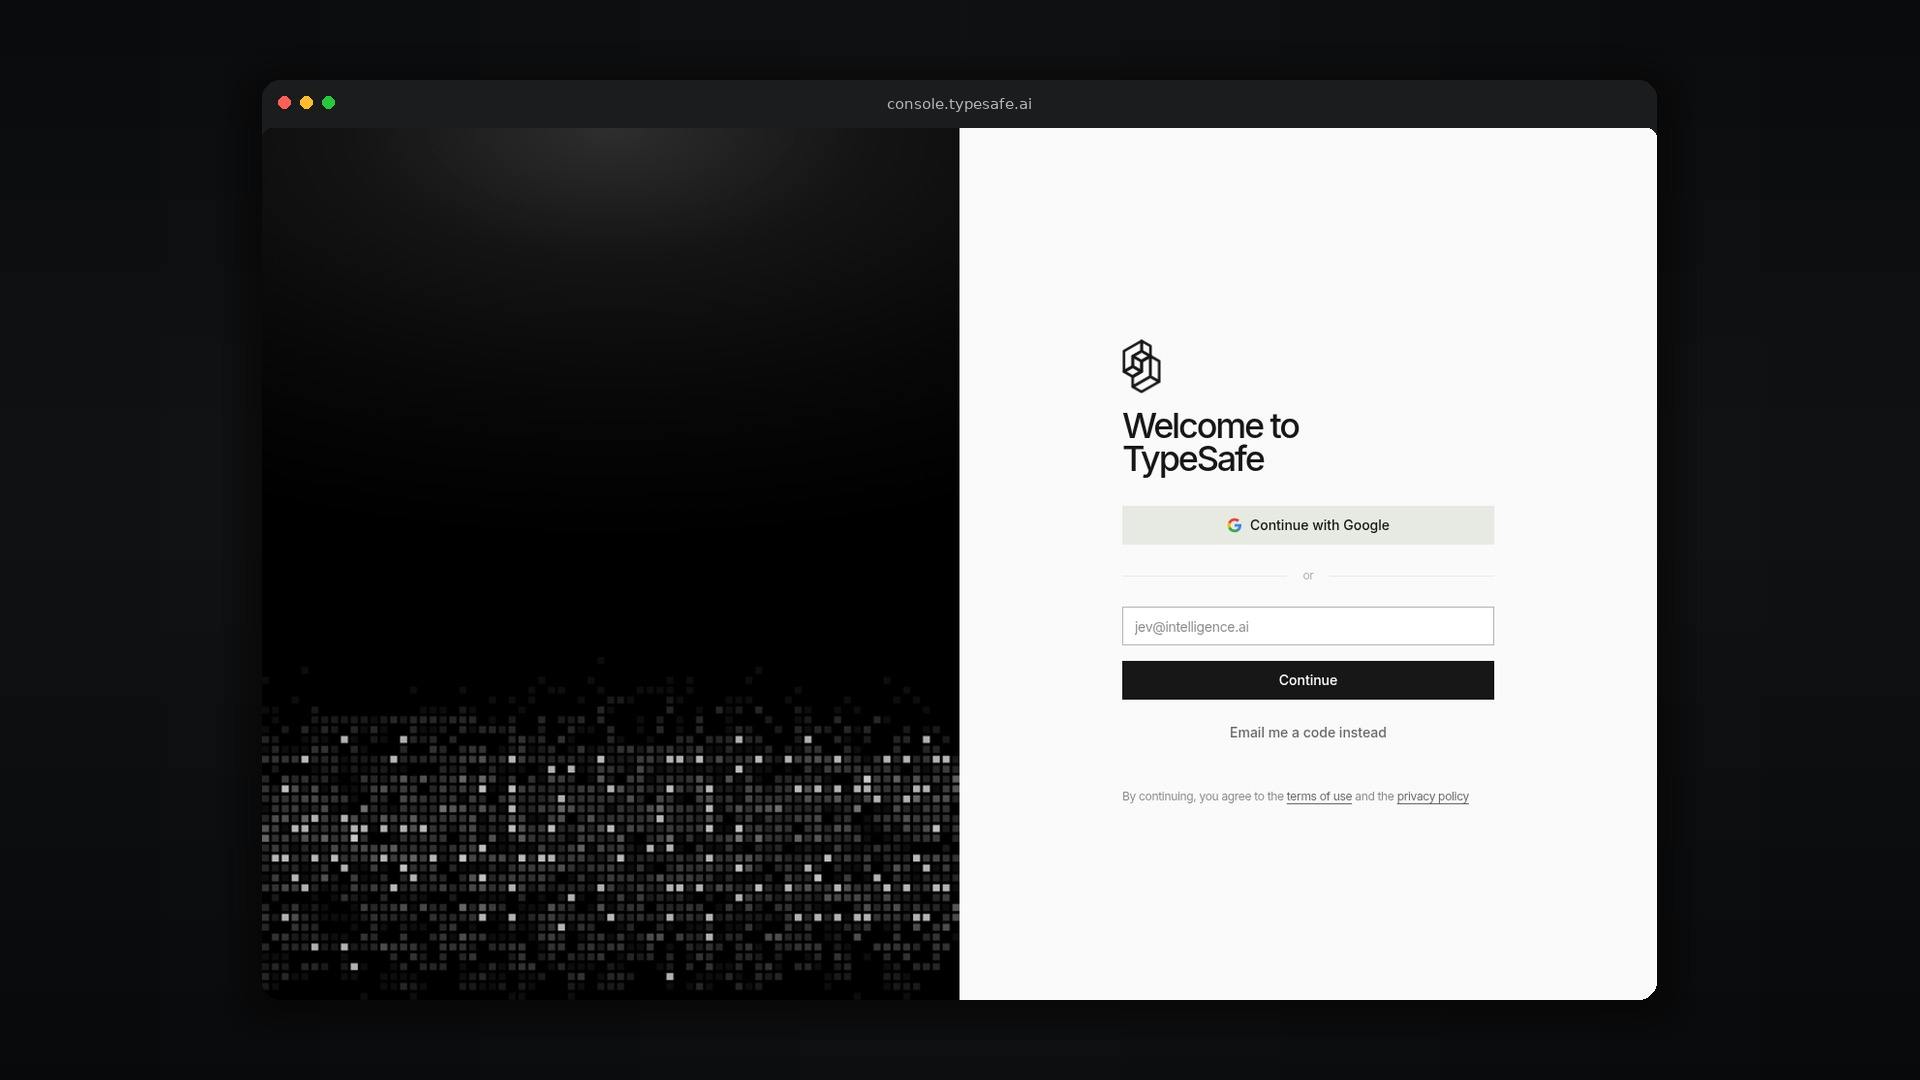
Jev放弃文本生成,专注输出类型化概率决策,以极低延迟和成本服务自动化场景。
TypeSafe AI推出的Jev模型走了一条反常识的路:不生成文字,只输出代码可直接执行的结构化决策——Choice(选择)、Score(评分)和带校准概率的Noul答案。借助并行采样技术,Jev将响应时间压缩至70-500毫秒,宣称比传统LLM工作流快20-200倍、成本低40-400倍,且输出token完全免费。其核心价值在于将AI从"生成器"变回"判断器":带校准概率的输出让系统可根据置信度动态决定是否转人工复核,天然契合内容审核、工单路由、风控打分等高频低延迟场景。当前已无waitlist面向所有人开放,在Product Hunt当日排名第四。
在大模型狂飙突进的当下,多数产品都在比拼谁能生成更流畅、更长的文本。而TypeSafe AI推出的Jev却选择了一条截然不同的路径——它不生成文本,而是直接输出你的代码可以立即执行的类型化概率决策。这个反常识的定位,让它在Product Hunt上以178票拿下当日榜单第四名。
不是聊天,而是决策
Jev被定位为TypeSafe AI的"System One"前沿模型。这个命名颇有深意:借用心理学中的"系统一"(快速、直觉式思考)概念,Jev主打的正是软件系统中那些需要快速、结构化判断的场景,而非需要深度推理和长篇输出的任务。
它的工作模式可以概括为一句话:"非结构化状态输入,类型化概率决策输出"(unstructured state in, typed probabilistic decisions out)。传统LLM工作流通常是:你给一段prompt,模型吐出一段文本,然后你还得写一堆解析逻辑去提取有用信息、处理格式错误、应对幻觉。而Jev直接返回三种结构化的答案类型——Choice(选择)、Score(评分)和Noul answers(带校准概率的答案),每个决策都附带经过校准的概率值,代码可以直接据此行动。
这种设计对于开发者而言意味着什么?意味着你不再需要为了让模型"听话"而反复调试prompt,也不需要在返回结果和业务逻辑之间搭建脆弱的胶水层。决策本身就是类型安全(TypeSafe,这也正是公司名的由来)的。
**校准概率(Calibrated Probability)**是指模型输出的置信度数值与真实准确率之间高度一致的特性。举例来说,如果模型对100个问题都给出"70%置信度",那么其中理想情况下应有约70个答案是正确的——这才叫"校准良好"。普通LLM输出的概率往往存在系统性偏差(过度自信或过度保守),而Jev专注于决策场景、放弃开放式生成,使得针对有限决策空间做概率校准在技术上更加可行。校准概率对生产系统至关重要:它让工程师可以设定阈值,比如"置信度低于60%时自动转人工审核",从而将AI决策的不确定性纳入可控的业务流程,而不是盲目信任模型输出。
速度与成本的数量级优势
Jev最抓人眼球的是它宣称的性能数据。通过**并行采样(parallel sampling)**技术,Jev能够实现约70到500毫秒的响应速度。相比可比的LLM工作流,官方给出的对比是:
- 速度快约20到200倍
- 成本低约40到400倍
- 输出token完全免费
这几个数字如果属实,将极大改变某些高频决策场景的经济账。想象一个需要每秒处理成千上万次判断的自动化系统——比如内容审核、工单分类、风控打分、路由决策——如果用传统LLM,无论是延迟还是账单都难以承受。而Jev把每一次决策的成本压缩到近乎可以忽略,输出token不计费更是直接砍掉了大头开销。
值得深究的是,这种速度和成本优势的来源,恰恰在于Jev放弃了通用文本生成。它不需要自回归地一个token一个token地生成长文本,而是针对有限的决策空间做并行采样,这在架构上天然更轻、更快。这是一种典型的"用能力换效率"的取舍——牺牲了通用性,换来了特定场景下的极致性能。
**并行采样(Parallel Sampling)**是Jev速度优势的核心机制。传统自回归语言模型生成文本时,必须一个token接一个token地顺序输出,每一步都依赖上一步的结果,天然是串行的。而对于有限决策空间(比如在5个分类标签中选一个),可以同时对多个候选答案并行评估其概率,无需顺序解码。这类似于同时打开多条赛道来赛跑,而不是让所有选手排队依次跑。这一架构差异解释了为什么Jev在决策类任务上能获得数量级的速度提升:它从根本上绕开了自回归解码的串行瓶颈。代价是无法生成任意长度的开放式文本——这正是文章所说的"用能力换效率"的取舍。
适合什么,不适合什么
理解Jev的定位,关键在于分清它擅长和不擅长的边界。
擅长的场景
Jev适合那些决策空间明确、需要高频调用、对延迟敏感的自动化任务:
- 内容/工单的自动分类与路由
- 需要打分排序的推荐或筛选逻辑
- 工作流中的条件分支判断
- 需要概率置信度来决定是否升级人工介入的场景
带校准概率这一点尤其实用。在真实的自动化系统里,知道模型"有多确定"往往和知道"它选了什么"同样重要——低置信度的决策可以自动转交人工复核,从而在自动化效率和可靠性之间取得平衡。
不适合的场景
如果你需要的是生成营销文案、撰写代码、总结长文档或进行开放式对话,Jev显然不是对的工具。它的价值在于把AI从"生成器"变回"判断器",服务于确定性的软件流程。
Jev的三种输出类型对应了软件系统中最常见的结构化决策形式:Choice类似于多选一的分类器,返回最优选项及其概率;Score返回一个数值评分,适用于需要排序或设置阈值的场景;Noul answers则是带概率标注的答案,可理解为对"是/否"或简短事实性问题的高置信度响应。这三种类型覆盖了自动化流水线中绝大多数决策节点的需求,同时通过强类型约束,使得调用方代码无需处理格式解析或幻觉兜底——模型输出本身就是可直接消费的结构化数据。
无门槛开放,降低试错成本
与许多前沿模型"申请排队"的做法不同,Jev现在已经面向所有人开放,无需waitlist,直接在console.typesafe.ai即可使用。这种无门槛策略对开发者友好,也表明团队对产品成熟度有一定信心。Makers包括Erik Gafni等人,产品被归类在API、开发者工具和人工智能三个类目下,定位清晰。
从Product Hunt上178票、排名第四的表现看,开发者社区对这种"结构化AI决策"的思路给予了正面回应。7条评论虽然不算多,但作为一个偏工程、偏底层的开发者工具,这样的关注度已属不错。
一点冷静的观察
需要提醒的是,官方给出的"快20-200倍、便宜40-400倍"是极宽的区间,实际表现高度依赖具体任务和对比基准。这类营销数字往往取的是最有利的对比场景,开发者在真正投产前,最好用自己的实际用例做基准测试。校准概率的准确性、决策类型的覆盖面,也都需要在真实数据上验证。
不过抛开数字的水分,Jev所代表的方向是值得关注的:随着AI应用从"演示"走向"生产",越来越多的团队会发现,很多场景其实并不需要一个能写诗的通用大模型,而是需要一个又快又便宜又可靠的决策组件。Jev押注的正是这个日益清晰的需求。
相关推荐
Corridor获2500万美元种子轮,瞄准中小企业健康福利经纪市场
健康福利经纪平台Corridor完成2500万美元种子轮融资,专注服务被传统经纪机构忽视的中小企业。本文分析其市场切入点、行业痛点及面临的挑战。
Disney+新用户协议:所有订阅套餐都将插播广告
Disney+更新用户协议,允许在所有订阅套餐(含无广告套餐)的影片前插播广告,引发消费者权益争议。本文解析政策变动内容、用户不满原因及流媒体行业加广告趋势。
加密手机如何阻碍多伦多枪手雇佣网络的调查
多伦多针对雇佣枪手网络的调查因犯罪嫌疑人使用难以破解的加密手机而受阻。本文梳理加密通信技术、执法后门争议以及隐私与安全之间的长期博弈。