Jev判断模型实战:6类高频应用场景全解析
Jev是专注大规模快速模式匹配的"判断模型",以极低成本替代人工做海量小决策。
Jev是由Typesafe团队打造的新型AI模型,定位为"判断模型"而非传统大语言模型。它借鉴卡尼曼的System 1概念,专注于快速、本能的模式匹配,支持选择、评分、是非三种提问方式,速度比同类快20-200倍、成本低40-400倍。其核心价值不在于替代GPT或Claude做复杂推理,而是让"对海量内容做简单判断"这件事在成本和速度上变得可行。文章梳理了六大真实用例——分析存量数据、语义搜索、输入分流、规则检查、加速AI智能体、即时响应——并给出了判断某个任务是否适合Jev的四条实操标准:答案可预设、有体量、风险可控、证据在32K token内。在招聘、金融等高风险场景中,建议搭配其他LLM构建混合复核系统。
不是又一个大语言模型,而是全新的AI原语
Jev(由Typesafe团队打造)是近期AI圈最火热的模型之一,但它的热度并非来自与GPT-6、Opus或Fable竞争,而是因为它从根本上做了一件不同的事。它不是用来写作、写代码或做复杂推理的,而是一个被作者称为"判断模型"(judgment model)的东西。
这种差异化很快转化为资本关注。据The Information报道,Typesafe正在洽谈以100亿美元或更高估值融资高达10亿美元——相比此前2亿美元估值的4000万美元种子轮,这是一次相当可观的跳跃。发布后10天内,X平台上已涌现数百篇相关帖子,每篇都有成百上千的点赞和转发。
那么,对于不是游戏设计师、也不是开发者的普通人来说,Jev值得纳入自己的AI工具栈吗?本文基于AI Daily Brief对社区真实用例的梳理,回答这个问题。
System 1思维:快速、本能的模式匹配
Typesafe借用了丹尼尔·卡尼曼《思考,快与慢》中的概念,将Jev定位为"System 1模型"——即快速、本能的模式匹配,也就是瞬间判断。判断某个任务是否适合Jev的一个好测试是:你是否需要反复阅读某些内容、做一个小判断,然后采取一个可预测的下一步。
举个例子,一个文件落入你的下载文件夹,普通软件的规则可能只是把它归类为PDF。而Jev能更进一步:这是不是发票?属于哪个项目?是否需要有人查看?做出判断后,就能可预测地进入系统的下一步。
Jev支持三种核心提问方式:
- Choice(选一个):回答"哪个最匹配",最多可列255个选项,Jev返回最佳选择以及每个选项的概率。例如"这张工单该交给账单、技术支持、销售还是其他团队?"
- Score(评分):在一个由文字描述的2到10级的量表上打分。例如"从平静到非常愤怒,这位客户有多沮丧?"Jev会给出位置和确信度。
- Null(是非题):源自伯努利分布的简称,回答"这是真的吗?",返回0到1的概率。例如"这个人是否明确要求退款?"
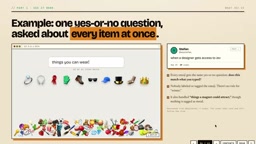
一个直观的可视化来自Stefan Annex:屏幕底部堆着一堆emoji,在文本框输入"可以穿的东西"或"冬天能穿的东西",匹配的emoji会向上飘,不匹配的掉落。背后的原理是每个emoji都被问了同一个是非题——没有人事先给emoji打标签,也没有"冬天"的规则,所有emoji在同一时刻被问"是否匹配?"
丹尼尔·卡尼曼的双系统理论(Dual Process Theory)是理解Jev定位的重要背景。在《思考,快与慢》中,卡尼曼将人类认知分为两套系统:System 1依赖直觉、自动运行、几乎不耗费意识资源,负责识别人脸、判断距离、理解简单句子;System 2则是缓慢、费力、有意识的分析推理,用于解数学题、评估复杂论点。传统大语言模型(如GPT-4、Claude)本质上是被设计成"会思考"的System 2工具——它们会推理、权衡、生成长篇答案。Jev的反向选择是:专门做System 1的事,放弃System 2的能力换取极致的速度与成本优势。这一定位解释了为什么Jev不返回推理过程,只返回概率和选择——就像人类瞬间认出一张熟悉的脸,不需要"想清楚"为什么认识。
快与便宜:从"差一个量级"到"差一个物种"
正因为Jev做的事情有限且专一,它能做得极快。Typesafe称其速度比同类快20-200倍,成本便宜40-400倍。一百万输入token仅需4.2美分,输出token免费,每次调用耗时约70到500毫秒。
关键在于,你可以对同一项目同时问多个问题。因为问题并行运行,问第9个或第10个问题不会增加时间,只增加token。Typesafe测试发现,单次调用处理13个问题,比逐个询问便宜12.2倍、快10倍,答案完全一致。
Matthew Berman分析了724条实时广告,对每条广告问12个问题(钩子原型、格式、报价、CTA意图、认知阶段等),单次请求仅耗时173毫秒。这才是模型真正的威力所在——不只是擅长判断,而是快到、便宜到可以对一切事物做判断。
不过Jev也有明确的权衡:它不写代码、不起草合同,也不做涉及诸多不可量化因素的细腻决策。它的定位是大规模、高速的小判断:归入哪个桶?有多紧急?是否相关?是否安全?
理解Jev定价的关键是"输出token免费"这一设计。传统LLM按输入和输出token分别计费,而生成长篇回答的高输出token数往往是成本的主要来源。Jev的输出极其简洁——一个概率值、一个选项编号或一个0到1的数字——因此免收输出费用实际上是对其使用场景的结构性反映。此外,"并行问题不增加时间"的特性源于Jev将多个问题打包进同一次前向推理(forward pass),类似于在一张图上同时检测多个目标,而非逐张扫描。这与传统LLM需要为每个独立问题发起独立调用的架构有根本区别,是Jev在批量判断场景下实现速度和成本双重优势的底层原因。
六大真实应用场景
场景一:分析现有数据堆
核心是对一批已有内容问同样的问题,然后统计答案。这类分析过去因人力成本无法开展,如今只需几秒、花几美分。
Matthew Berman分析37个品牌的724条广告,拆解每个钩子、格式、报价和CTA,耗时40秒、9美分。两天后他更进一步,让Jev以30种买家人格(健身房老板、牙科诊所经理、幼儿妈妈、AI好奇工程师等)浏览723条广告,判断每个买家对每条广告是"停下来看"还是"继续滑走",花22美分得到了21690个决策。作者提醒:这不是真实数据,而应被视为"假设生成器",用于在付费测试前压力测试广告角度。
Ian Nuttall对近3300条历史X帖子各问8个问题(主题、钩子、语气),再与互动数据对照,成本约13美分。
场景二:按语义搜索
用自然语言描述你要找的东西,让Jev检查每个候选项——即使字面不匹配也能找到你的本意。
A16Z的Justine Moore用它扫描数千条Zillow房源,按建筑风格、翻新状态、是否临近高速等平常无法筛选的维度分类。Burhan将一段90分钟视频按自然语言描述的主题剪辑,比如找出"对AI何时能自动化AI研究的预测"。
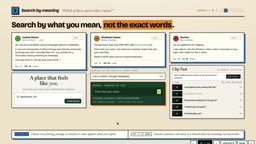
Borgia做SEO审计时,让Jev读完网站全部586页重建内部链接地图,45.1秒、21美分完成;而Cloud Opus 5只读了21页就花了1.43美元。Elvis Sananex让Jev浏览384条晨间新闻,识别15个品牌各应关注哪些,24.9秒、19美分完成;同样时间Opus 5只读了4篇。
场景三:对输入分流归类
核心问题是"这是什么,该去哪里"。比如这封邮件有多重要?这个下载文件是发票吗?这个链接有害吗?
Jonathan Unikowski提出一个有趣设想:如果收件箱不按时间倒序,而是按重要性实时排序呢?Jev在453毫秒内为100封邮件评分,成本约千分之一美分,且评分与他本人判断每封都一致。
Beyond Code的CTO Marcel Pocchio做了一个macOS应用监控下载文件夹:是发票就移到特定文件夹并正确命名,全程只用Jev。dub短链接服务的Stephen Tay喂给Jev一万个已捕获的恶意域名来标记有害链接,称"这是我们从第一天就在纠结的问题,用Jev两小时就解决了"。
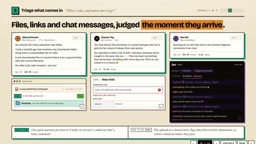
如果只能挑一个领域尝试,尤其对于多人共同经手线索、客户或联系人的公司,这类分流路由很可能成为Jev集成后不可或缺的能力。
场景四:对照规则检查工作
把"请审查这个"变成具体问题,再对每份草稿逐一提问。Langchain的Harrison Chase指出Jev"非常适合做评估,尤其是在线评估大量trace"。随着越来越多人将智能体投入生产,用它构建评估系统可能成为核心基础设施。
Every团队在12段文字中植入错误,Jev抓到7个中的6个(Claude Fable 5.1全抓到7个),但Jev只用0.35秒、成本便宜约580倍,而Fable 5.1用了8.83秒。这意味着你可以把同样的检查重复跑很多遍,仍然又快又便宜。
实操上,你可以把风格指南或"绝不想看到的措辞"清单转成一个个是非题,对长文档每个段落逐段检查。这触及了Jev带来的一个重要转变——能真正逐句细查每一处"AI腔",这与对整篇文档跑一次泛泛检查,是质的不同。
Langchain提到的"在线评估trace"指的是AI智能体评估(LLM-as-judge)这一新兴实践:在大型语言模型投入生产后,用另一个模型实时监控其输出质量,检查每次调用是否符合预期行为、是否触发幻觉、是否遵守格式规范。随着智能体系统日趋复杂,人工逐条审查已不可行,自动化评估因此成为生产级AI系统的标配基础设施。Jev在这里的优势不仅是便宜,更在于它能以极低延迟嵌入实时流水线——每条输出生成后立刻被评估,而不是批量事后抽检。这让"每次调用都被检查"从成本上变得可行,从而将质量保障从采样升级为全覆盖。
场景五:加速AI智能体
这一类更贴近开发者领域,核心是用微判断来路由智能体——哪个模型能处理这个任务?这步需要多少推理?哪个技能匹配?旧的工具输出还相关吗?
Vichin让Jev在Codex任务执行中动态调整GPT-6的推理强度:卡住时多思考,常规步骤少思考,测试中降低50%成本并加快运行。Daniel San做的"Jev Skill Suggestion for Cloud Code"为每个请求分类最匹配的技能并只注入该技能,token和成本降低88%。
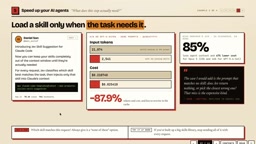
A.J. Asper构建的新harness让重复工作成本降低90%——系统边运行边学习,把步骤从LLM调用迁移到代码。以合规警报为例,每条成本从约2.95美元降到第1000条时的仅25美分。
场景六:即时响应
核心问题是"这个人现在想要什么"。Marcus Lowe设想"如果复制粘贴是智能的呢"——复制简历、粘贴到申请表,字段自动填充。Norman的版本会把粘贴文本拆分、判断每个字段、匹配、核对原文,只粘贴高置信度的匹配项。考虑到大量工作就是把信息从一种格式搬到另一种地方(邮件、PDF搬进CRM、表单、模板),这一类用例非常贴近现实。
哪些场景要谨慎,如何判断是否适用
在招聘、金钱、安全这些高风险领域要格外小心。比如用Jev对海量简历排序时,它只返回一个没有附带推理的数字。更稳妥的做法是构建混合系统:先用Jev排序,再让其他类型LLM复核处于边界的候选人。
Typesafe自己也坦承Jev的短板:不擅长计数、数学或日期(能提取事实,但实际计算要放到别处),还存在一致性和理解意图方面的问题。
判断一个任务是否适合Jev,有四条标准:
- 答案可预先写下:类别、是非、量表皆可;若答案是一句话或一次计算,则不适合。
- 有体量:存在一堆或一股数据流,比如上百张工单、上百封邮件。
- 风险可控:答错代价低或容易被发现——别把高后果的事完全交给它判断。
- 证据能在32000 token内以文本给出。
写好问题也有技巧:一个问题只问一个判断。"这是个好线索吗"不是一个判断,而是行业匹配度、公司规模、购买意图等多个判断的集合,应拆成独立问题。涉及量表时要描述每一级。最后,像所有AI一样,投入生产前先做测试——比如亲手标注50封邮件,看Jev是否与你一致。
Typesafe提到的"32000 token上下文窗口"限制值得特别说明。当前主流大语言模型的上下文窗口通常在100K到200K token之间(约75,000到150,000个英文单词),而Jev的32K窗口(约24,000个英文单词,约合15,000个汉字)相对较小。这意味着对于超长文档——如完整法律合同、书籍章节或大型代码库——Jev无法在单次调用中处理全部内容,需要提前分块(chunking)。在设计工作流时,这一限制应作为首要技术约束加以考量:如果待判断的上下文本身就需要超长输入,则需要在架构层面引入文本切分策略,或考虑先用其他工具做摘要压缩再交给Jev判断。
一个新原语,才刚刚被发掘
发布10天,Jev就从一个炫酷概念快速走向真正有价值的生产用例。但正因为它本质上是一种新原语——以极快速度、几乎零成本大规模施加简单判断——我们恐怕还需要时间才能摸清它能被多深地织入各类工作流。这种"质变而非量变"的差异,正是它值得关注的根本原因。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。