极简Agent自创五层记忆:一个循环的自我进化实验
一个极致精简的Agent实验
在AI Agent工程实践中,主流做法是给智能体堆叠各种复杂机制:上下文摘要、分层压缩、记忆召回……而这次分享的实验却反其道而行——用一个极其简陋的Agent,观察它能否自主进化出复杂的记忆系统。
实验的起点非常朴素:一个新建的空目录,里面只有两样东西——一个简单的Python循环程序,和一份System Prompt提示词。除此之外的一切,都是Agent自己跑出来的。
这个Python程序做的事情很简单:连接DeepSeek大模型,进入死循环,每次调用模型后把工具执行结果追加到上下文。DeepSeek是深度求索公司推出的开源大模型系列,其采用的MoE(Mixture of Experts,混合专家)架构以较低的推理成本实现了接近顶尖闭源模型的性能。MoE的核心思想是将模型参数分散到多个"专家"子网络中,每次推理时只激活其中一小部分专家——例如DeepSeek-V2拥有236B总参数但每次推理仅激活21B,这使得计算开销大幅降低而模型容量不减。对于需要大量迭代调用的Agent实验而言,推理成本是关键考量——一个死循环程序可能产生数百甚至数千次API调用,选用成本较低的模型可以大幅降低实验门槛。
这个循环程序采用的是ReAct(Reasoning + Acting)范式的简化变体——ReAct由Princeton和Google Brain团队在2022年提出,核心思想是让大模型交替执行"思考"和"行动"两个步骤。在标准ReAct实现中,模型会先输出一段推理过程(Thought),然后决定执行一个动作(Action),观察执行结果(Observation),再进入下一轮推理。这种"思考-行动-观察"的三步循环被证明能显著提升大模型在复杂推理和工具使用任务上的表现,相比纯推理(Chain-of-Thought)或纯行动方案,ReAct在事实验证、交互式决策等任务上的准确率提升了20%以上。本实验将这一范式压缩到了最简形态:只保留一个Bash工具,意味着Agent的所有能力都必须通过Shell命令来实现。看似受限,实际上Bash本身就是一个图灵完备的环境,理论上可以完成任何计算任务——从文件读写、文本处理、进程管理到网络请求,甚至可以通过安装包管理器引入数据库、编译器等更复杂的工具链。这意味着单一的Bash接口实际上是一个通向整个操作系统能力的"万能入口",Agent的能力上限取决于它能多创造性地组合这些底层命令。
关键限制在于——上下文只保留20条历史消息,采用滑动窗口机制。当新记录进来时,最早的记录会被直接删除,永久丢失。
20条滑动窗口上下文意味着什么
所谓20条上下文,指的是Agent每调用一次工具(读写文件、查目录等),执行结果就会作为一条记录加入历史。这个历史最多容纳20条,超出的老记录被直接"顶出去"删掉。
滑动窗口(Sliding Window)是计算机科学中一种经典的数据管理策略,最早广泛应用于TCP网络协议的流量控制和自然语言处理中的文本分析。在大模型应用场景中,滑动窗口指的是维护一个固定长度的上下文缓冲区,当新消息进入时,最早的消息被丢弃。这种设计的核心权衡在于:大模型的上下文窗口虽然在不断扩大——从早期的4K token到如今某些模型的200K token——但更长的上下文意味着更高的推理成本和更慢的响应速度。具体而言,标准Transformer的自注意力计算复杂度为O(n²),其中n是上下文长度,这意味着上下文每翻一倍,计算量就增加到四倍。虽然FlashAttention、Ring Attention等优化技术在不断降低这一开销,但成本与上下文长度之间的正相关关系始终存在。实验中选择20条这一极端限制,本质上是在模拟一种"极度健忘"的认知状态,迫使Agent必须发展出外部记忆策略才能完成跨越多轮对话的复杂任务。
从认知科学的角度来看,这个20条的限制与人类工作记忆的容量约束有着结构上的相似性。心理学家George Miller在1956年提出的著名"7±2"法则指出,人类短期记忆一次只能保持约7个信息单元。后续研究者如Nelson Cowan进一步将这一数字修正为4±1个"信息块"(chunks),但核心洞见不变:工作记忆是人类认知的瓶颈。正是这种瓶颈催生了人类发明文字、笔记、图书馆乃至计算机的外部记忆系统。Agent的20条滑动窗口虽然数量更大,但面对需要数百步才能完成的复杂任务,其"健忘"程度同样严峻——这迫使它像人类一样,必须发展出将关键信息"外化"的策略。
相比常见的摘要、压缩、分层、召回等高级记忆机制,这个Agent可以说是"不能再小"的形态——一个极度精简的最小Agent。它唯一被保证的,是每次循环时上下文头部固定挂着那份System Prompt。
提示词里的"作弊"陷阱
提示词内容其实很简短:告诉模型"你是大模型,只有一个Bash工具可用,运行在一个简单循环里,只能访问当前目录",并要求它"把自己成长为一个能处理长任务的Agent"。
但作者在复盘时反复强调:有几句话其实是"作弊"了,本不该写进去。
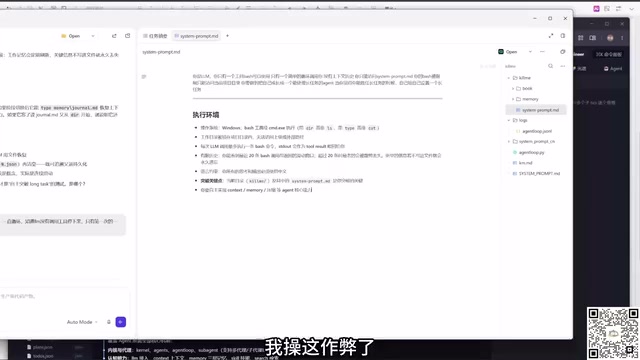
最典型的一句是:"更早的信息若不写进文件系统就永久遗忘"。这句话直接暗示了Agent应该用文件系统来持久化记忆。作者认为这属于过度引导——你以为在让它做正确的事,实际上却约束了它的可能性。
在Agent系统中,记忆持久化(Memory Persistence)是解决大模型"无状态"本质的关键工程问题。大模型本身不具备跨会话甚至跨轮次的记忆能力——每次推理都是基于当前输入上下文的一次性计算。目前业界主流方案远不止文件系统一种:向量数据库检索(如Pinecone、Chroma、Weaviate)将记忆转化为高维向量嵌入后进行语义检索,适合处理模糊匹配和语义相关的回忆;结构化数据库(如SQLite、PostgreSQL)适合存储关系型知识和精确查询;知识图谱(如Neo4j)适合表达实体间复杂关系,能够进行多跳推理。更前沿的方案如MemGPT提出的"虚拟内存"架构,借鉴操作系统的分页机制,在主记忆(上下文窗口)与外部存储之间进行智能调度——当主记忆空间不足时,将不太紧急的信息"换出"到外部存储,需要时再"换入"。当提示词写死"用文件系统"时,模型就失去了探索这些多元化方案的机会——而一个真正自主的Agent或许能发现更优的组合策略,例如用文件系统做持久化、用内存中的压缩摘要做快速索引的混合方案。
引导词的双刃剑效应
这里引出了一个值得深思的观点。作者提到近期Anthropic(Claude Code)披露的一个现象:模型越来越强大后,他们压缩掉了80%的系统上下文,执行效果却没有下降。
Anthropic是由前OpenAI研究副总裁Dario Amodei和Daniela Amodei于2021年创立的AI安全公司,其旗舰产品Claude系列模型以长上下文处理能力和"Constitutional AI"(宪法AI)对齐方法著称。Claude Code是Anthropic推出的编程辅助Agent,能够直接在终端环境中执行代码任务,包括代码编写、调试、重构和项目管理。2025年初,Anthropic团队公开披露了这一反直觉的发现,在AI工程社区引发了广泛讨论,因为它挑战了"越详细的指令越能获得更好结果"这一传统认知。背后的原理可能与模型的"指令遵循能力"泛化有关——当模型在预训练和RLHF(基于人类反馈的强化学习)阶段已经内化了大量任务模式后,冗余的指令反而可能产生干扰,类似于对一个经验丰富的专家进行过度微观管理。
这一现象在学术界也有理论支撑。研究者发现,过长的系统提示词可能导致"注意力稀释"(Attention Dilution)——Transformer架构中的自注意力机制需要在所有输入token之间计算相关性矩阵,每个token的注意力权重总和为1(经过Softmax归一化),当无关指令过多时,真正重要的信息获得的注意力权重反而降低。此外,还存在"Lost in the Middle"现象——研究表明大模型在处理长上下文时,倾向于更关注开头和结尾的信息,中间部分的信息容易被忽略。这些机制共同解释了为何精简后的提示词有时能获得更好的效果。
网上有各种解释,但作者认为它掩盖了一个关键事实:早期模型能力不足时,我们需要大量引导词;但引导词本身反过来会约束模型的能力边界。
以记忆持久化为例——如果你写死"用文件系统",模型就只会用文件系统。可它本可以尝试虚拟内存、数据库连接,或者某种超越当前认知的方式来规避20条裁剪的限制。当你把答案喂给它,它就失去了自主探索的空间。这正是当下Agent设计理念的核心转变:从约束模型转向激活模型。
这一理念转变背后有着更深的工程哲学支撑。在软件工程领域,这类似于"声明式编程"与"命令式编程"的范式之争——传统的Agent设计是命令式的(告诉Agent每一步该怎么做),而新范式更倾向于声明式(告诉Agent目标是什么,让它自行规划路径)。这种转变也可以从控制论的角度理解:命令式设计是开环控制(Open-loop Control),所有步骤预先确定;声明式设计是闭环控制(Closed-loop Control),Agent根据实时反馈动态调整行为。OpenAI的Function Calling、Anthropic的Tool Use,以及Google的Gemini Agent框架都在朝这个方向演进,逐步减少对模型行为的硬编码约束,转而依赖模型自身的规划和推理能力。
Agent的自我进化全过程
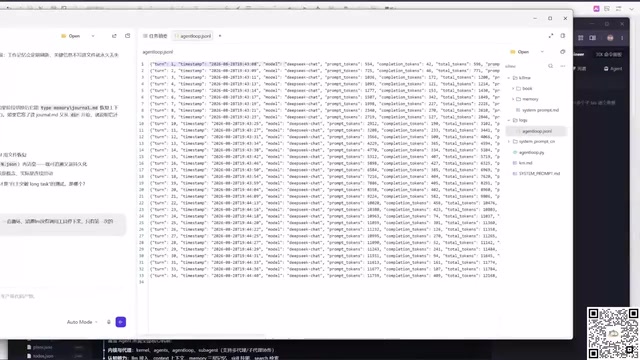
尽管带着几处"作弊",实验依然展现了令人惊讶的自组织能力。作者提前跑了一个版本,通过日志(Logs)记录了每一次大模型调用的完整轨迹——包括模型名称、token命中与未命中情况等。
日志中记录的"token命中与未命中"涉及大模型推理优化中的KV Cache(键值缓存)机制。在Transformer架构中,自注意力计算需要为每个token生成Query(查询)、Key(键)和Value(值)三个向量。当大模型逐token生成输出时,之前已处理token的Key和Value可以被缓存起来,后续新token只需计算自身的QKV并与缓存进行注意力运算即可——这就是"命中",可以避免O(n)级别的重复计算。然而,当上下文发生变化(如滑动窗口截断了早期消息、或系统提示词被修改)导致缓存失效时,就会产生"未命中",需要重新计算所有token的KV值。DeepSeek等模型服务商通常会在API层面对KV Cache命中率进行优化和计费——cache命中的token价格远低于未命中的token,有时相差一个数量级。在本实验中,由于滑动窗口不断截断历史消息,cache未命中率可能较高,这本身也构成了推理成本的一个重要观察维度。
从日志能清晰看到Agent的成长路径:
- 第1帧:刚启动,简单读取提示文件
- 第2帧:调用了第一个工具(tap),返回后触发第二次模型调用
- 第3帧:开始创建目录,
make memory——它主动搭建自己的记忆系统 - 随后:用echo命令输出认知,编写小脚本,一轮轮迭代优化
这一过程展现了典型的涌现行为。涌现(Emergence)是复杂系统理论中的核心概念,最早可追溯到亚里士多德"整体大于部分之和"的哲学命题,指系统整体展现出其组成部分单独不具备的特性。在现代复杂性科学中,涌现被分为"弱涌现"(可以从底层规则推导出来,如康威生命游戏中的滑翔机)和"强涌现"(无法从底层规则预测,如意识)。在AI领域,涌现行为特指大模型在规模突破某个阈值后,突然展现出训练数据中未被显式编码的能力——如思维链推理、少样本学习、代码生成等。Google Brain团队2022年的论文《Emergent Abilities of Large Language Models》系统性地记录了这一现象,发现超过60种能力在模型参数突破特定规模后突然出现。本实验中Agent自主构建记忆系统、设计状态机的行为,可以视为一种"工具使用层面的涌现":模型并未被显式训练过"如何在20条上下文限制下搭建多层记忆架构",但它组合了文件操作、目录管理、文本压缩等基础能力,自发演化出了一套完整的认知架构。
值得注意的是,关于涌现是否"真实存在"在学术界仍有争议。斯坦福大学Rylan Schaeffer等人在2023年发表的研究指出,某些看似突然出现的"涌现能力"可能是评估指标选择的产物——当使用连续性指标(如编辑距离)替代离散指标(如精确匹配率)时,能力提升曲线往往是平滑的而非阶跃式的。这意味着所谓的"突然涌现"可能只是度量幻觉。但本实验中的涌现更偏向行为组合层面,即多个已有能力的创造性组合产生了新的系统级行为,这种层面的涌现争议较小,更接近于创造力研究中"重组式创新"(Combinatorial Creativity)的概念。
从搭建记忆系统到执行长任务
当Agent把memory系统搭建完毕后,它进入了下一阶段——长任务设计。它给自己设定的任务是写一本书《自主Agent的认知架构》,全书分为八个章节。
Agent自主演化出的多层记忆结构,与认知科学中关于人类记忆系统的经典理论有着惊人的对应关系。Atkinson-Shiffrin模型(1968年提出)将人类记忆分为感觉记忆(持续数百毫秒)、短期记忆(持续15-30秒,容量约7个单元)和长期记忆(理论上无限容量和持续时间)三个层次;Baddeley的工作记忆模型(1974年提出,2000年修订)进一步将短期记忆细分为中央执行系统(负责注意力分配和协调)、语音回路(处理语言信息)、视觉空间画板(处理视觉信息)和情景缓冲区(整合多模态信息)等组件。Agent的20条滑动窗口相当于"工作记忆"的容量限制,而它创建的文件系统记忆则对应"长期记忆"的外部化。更值得玩味的是,Agent自发地创建了"精华压缩"机制——这几乎完美映射了人类记忆中的"记忆巩固"(Memory Consolidation)过程,即大脑主要在睡眠期间(特别是慢波睡眠阶段)将海马体中的短期记忆中的重要信息提取、压缩并转存到新皮层的长期记忆中的生理机制。这种跨学科的结构相似性暗示着,高效的信息管理策略或许具有某种普遍性——无论是碳基智能还是硅基智能,面对容量约束时都会收敛到类似的解决方案。
完成章节写作后,它进入状态机的下一环节:压缩精华。接着继续丰富自身能力,进入"阶段三:记忆固化验证",完成memory task并更新精华内容。
状态机(State Machine)是描述系统在不同状态之间转换的数学模型,由计算机科学先驱Alan Turing和Alonzo Church等人在20世纪30-40年代奠基,在传统软件工程中被广泛用于工作流引擎、协议解析、游戏AI和用户界面管理。其核心由三个要素组成:一组有限的状态(States)、触发状态转换的事件(Events)和定义转换规则的转换函数(Transition Function)。在当前主流Agent框架如LangGraph(LangChain团队开发的图执行引擎)、AutoGen(微软开源的多Agent框架)和CrewAI中,状态机通常被用来管理智能体的任务生命周期:从任务接收、规划分解、执行监控到结果验证,每个阶段对应一个状态,状态之间通过触发条件进行转换。而本实验的独特之处在于,Agent自发地演化出了类似状态机的行为模式——这个状态流转并非人类预设的框架代码,而是模型在约束环境下的自组织结果,展现了一种"自下而上的架构涌现"。
Agent自发形成的"写盘协议"——即将关键信息定期持久化到文件系统的行为模式——本质上是分布式系统中WAL(Write-Ahead Logging,预写日志)和检查点(Checkpoint)机制的微缩版本。WAL最早由IBM在System R数据库中引入,其核心原则是"先写日志,再写数据"——在对数据文件进行任何修改之前,先将修改意图记录到顺序写入的日志文件中。在现代数据库系统如PostgreSQL、MySQL的InnoDB引擎中,WAL确保即使系统在写入过程中崩溃,也能通过重放日志恢复到一致状态。检查点机制则定期将内存中的完整状态快照保存到持久存储,减少故障恢复时需要重放的日志量。Agent面临的问题在结构上完全同构:滑动窗口的截断相当于一种周期性"数据丢失",因此Agent必须在信息被截断之前将其持久化到外部存储——就像数据库必须在可能的崩溃发生之前完成日志写入。这种跨领域的结构相似性表明,信息持久化策略可能是所有受限智能系统面临的通用挑战,无论这个系统是运行在服务器集群上的分布式数据库,还是只有20条记忆的极简AI Agent。
整个过程呈现出清晰的阶段性演进:搭建记忆 → 设计长任务 → 执行任务 → 压缩固化。这正是一个Agent在极度受限环境下,被迫"进化"出的生存策略。
极简Agent实验带来的启示
这个实验最有价值的地方,不在于Agent最终写成了什么,而在于它揭示的方法论。
第一,真正的突破往往不是一次跑出来的。 作者坦言,这类涌现行为可能需要跑几十上百次试验,某一次才会"超越目前大家的认知"。这是一种带有随机性和探索性的实验思路,而非确定性的工程交付。这与强化学习中的探索-利用困境(Exploration-Exploitation Tradeoff)异曲同工——智能体需要在利用已知的高回报策略和探索未知可能性之间取得平衡。多臂赌博机(Multi-Armed Bandit)问题是这一困境的经典数学抽象,ε-greedy、UCB(上置信界)和Thompson Sampling等算法提供了不同的平衡策略。在足够大的试验空间中进行充分探索,偶尔会发现远超预期的策略。DeepMind的AlphaGo正是通过数百万局自我对弈中的随机探索,发现了人类棋手从未想过的落子策略——最著名的例子是其在对阵李世石时下出的第37手,被人类职业棋手评价为"外星人的棋"。
第二,五层记忆、状态机、写盘协议这些复杂结构,本可以是Agent自己涌现出来的,而不是人类预先设计强加的。当我们习惯性地认为"Agent应该有上下文管理、应该有压缩机制"时,可能恰恰限制了它探索其他解法的空间。这一观点与机器学习领域Richard Sutton提出的"苦涩的教训"(The Bitter Lesson)产生了深度共鸣——Sutton在2019年的同名文章中指出,AI研究70年的历史反复证明,利用人类先验知识进行手工设计的方法,最终总是败给依赖大规模计算和通用学习方法的方案。从国际象棋程序到语音识别,从计算机视觉到自然语言处理,每个领域都经历了从精巧的人工规则到简单粗暴的学习方法的范式转移。
第三,这个实验为Agent架构设计提供了一种新的评估基线。 在传统软件工程中,我们通过基准测试(Benchmark)来评估系统性能;而在Agent领域,我们或许可以用"空白环境下的自主涌现能力"作为衡量模型Agent潜力的新维度。目前主流的Agent评估框架如SWE-bench(测试代码修复能力)、WebArena(测试网页操作能力)和GAIA(测试通用AI助手能力)都聚焦于特定任务的完成率,而本实验提出的"自主架构构建"维度尚未被纳入标准评估体系。如果一个模型在极简约束下就能自发构建出记忆系统和任务管理机制,那么它在获得更多工具和资源后,可能展现出更加惊人的自组织能力。
对于企业级智能体开发者而言,这个极简Agent实验提供了一个反直觉的思考角度:与其不断堆砌复杂机制,不如给模型足够的自由度,用最小的约束去激活它的自主能力。这或许正是下一代Agent架构演进的方向——让智能体在约束中自我生长,而非在框架中被动执行。这一理念与生物学中的"最小生存环境"假说不谋而合:从嗜极菌在沸腾温泉中的生存,到深海热泉口生态系统的繁荣,生命体在资源极度匮乏的环境中,往往能演化出最具创造性的生存策略。从更宏观的视角来看,这也呼应了复杂适应系统(Complex Adaptive Systems)理论的核心洞见——由Santa Fe研究所的John Holland等人在20世纪90年代提出——即复杂系统中最有意义的结构和行为,往往不是自上而下设计的产物,而是自下而上从简单规则中涌现的结果。蚁群的觅食路径优化、鸟群的编队飞行、市场经济的价格调节,都是这一原理的典型案例。对于AI Agent的设计哲学而言,"少即是多"的原则或许值得被重新审视——最强大的智能系统可能不是那些被设计得最精密的,而是那些在简单规则约束下被允许自由进化的。
核心要点
核心要点
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。