从演示学习与行为克隆的前沿进展:基础模型如何重塑机器人学习

机器人学习领域正在经历哪些关键变革
机器人学习社区正在经历一场深刻的技术变革。一位Reddit用户在r/MachineLearning板块提出了一个核心问题:当前从演示学习(Learning-from-Demonstrations, LfD)和行为克隆(Behavioral Cloning, BC)领域的研究方向是什么?这些传统机器人学习方法是否正在被大语言模型(LLMs)、视觉Transformer(ViTs)和视觉-语言-动作模型(VLAs)等新技术彻底重塑?
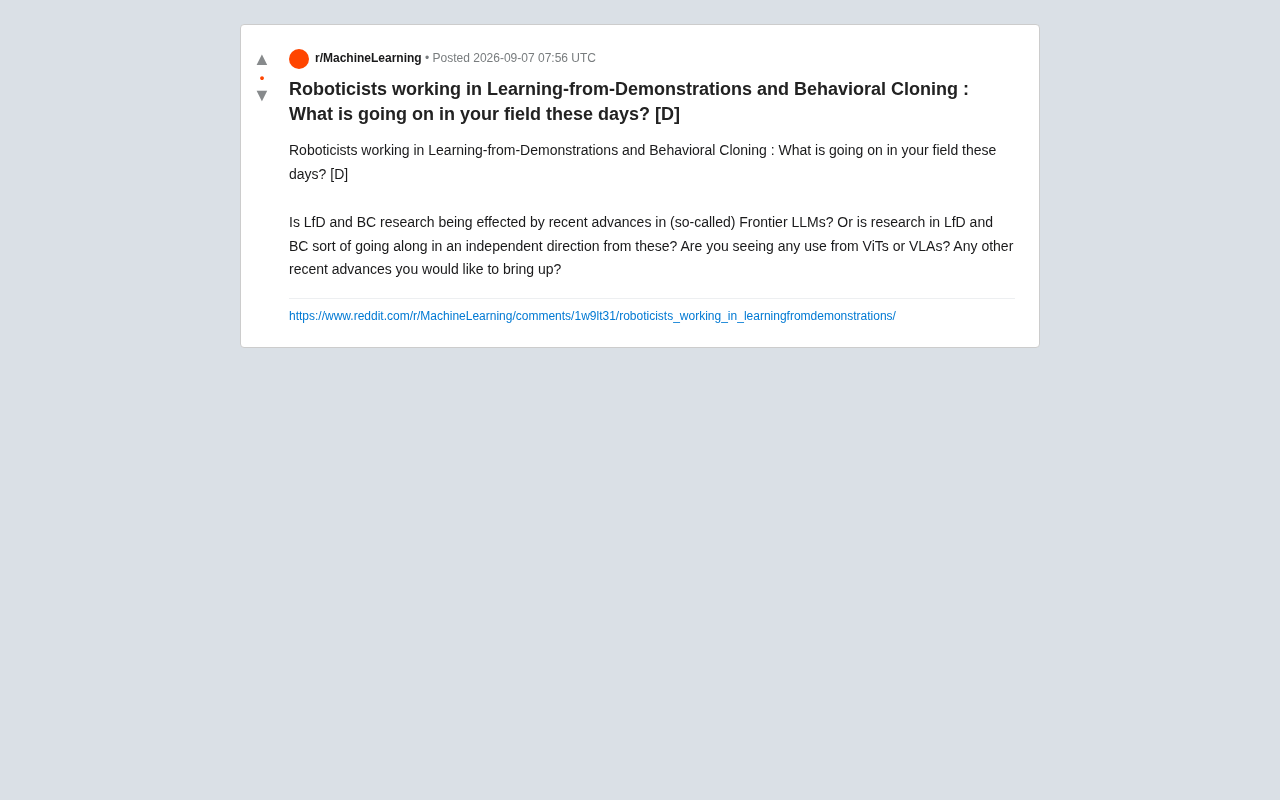
这个问题触及了机器人学习领域的核心矛盾:传统的端到端学习方法与新兴的基础模型技术之间,究竟是走向融合还是分化?
从演示学习与行为克隆面临的挑战
从演示学习和行为克隆是机器人领域的经典范式。从演示学习(Learning from Demonstrations, LfD)起源于1980年代末的机器人编程by示教(Programming by Demonstration)研究。其核心思想是让机器人通过观察专家的操作轨迹来学习技能,而非手工编写复杂的控制规则。典型的LfD流程包括:演示采集(通过遥操作、动作捕捉等方式记录专家动作)、特征提取(从原始传感器数据中抽取状态表征)、策略学习(使用监督学习等方法拟合状态到动作的映射)、策略执行与泛化。这一范式在工业机械臂示教、医疗辅助机器人等领域已有广泛应用,代表性算法包括动态运动基元(Dynamic Movement Primitives, DMP)和高斯混合回归(Gaussian Mixture Regression, GMR)等。
行为克隆(Behavioral Cloning, BC)则是LfD中最直接的实现方法,本质上是一个监督学习问题。算法将专家演示数据视为(状态,动作)配对的训练集,通过最小化预测动作与专家动作之间的差异来训练策略网络。BC的数学表述为:给定专家轨迹τ={(s₁,a₁),...,(sₙ,aₙ)},学习策略π_θ使得损失函数L=Σ||π_θ(sᵢ)-aᵢ||²最小化。BC的主要优势是实现简单、训练稳定,但其致命弱点是分布偏移(distribution shift)问题:训练时策略总是从专家状态出发,但执行时的小错误会累积导致遇到训练中未见过的状态,从而产生级联失败。
分布偏移的严重性可以用数学方式精确量化。假设策略在每步产生ε的误差概率,经过T步后,误差累积使得期望总损失为O(εT²)而非线性的O(εT),这是因为一旦偏离专家轨迹,后续每一步都在未见过的状态分布上做决策。Ross和Bagnell在2010年的开创性分析中严格证明了这一二次累积效应。从马尔可夫决策过程(MDP)的理论框架中可以更深入地理解这一问题的根源:在MDP中,策略与环境形成闭环交互,当前状态依赖于历史动作序列,而行为克隆将这个序贯决策问题简化为独立同分布(i.i.d.)的监督学习,忽略了动作对未来状态的影响。针对这一问题,研究者提出了DAgger(Dataset Aggregation)等交互式学习算法——通过在策略执行过程中交互式地请求专家标注来缓解分布偏移,但它要求专家在线持续参与,在很多实际场景中并不可行。近年来,研究者还提出了DART(使用噪声注入演示)、ValueDICE(离线分布匹配)等替代方案,试图在不需要在线专家交互的前提下解决这一根本性挑战。值得注意的是,近年来出现的隐式行为克隆(Implicit BC)和扩散策略(Diffusion Policy)从生成模型角度重新审视了分布偏移问题——通过建模动作的多模态分布而非简单回归均值,显著减轻了分布偏移导致的平均化行为,为BC范式注入了新的活力。
然而,传统方法面临几个固有局限:
- 数据效率低下:通常需要数百到数千次演示才能训练出可用的策略模型
- 泛化能力有限:难以应对训练分布之外的新场景
- 环境鲁棒性不足:对光照、物体位置等微小变化敏感
- 分布偏移问题:BC的主要问题是训练时策略总是从专家状态出发,但执行时的小错误会累积导致遇到训练中未见过的状态,从而产生级联失败
正是这些痛点,为基础模型等新技术的介入创造了空间。
基础模型如何带来范式转变
大型基础模型已开始深度渗透机器人学习领域。要理解这一趋势,首先需要回顾Transformer架构的跨域迁移历程。Transformer最初由Vaswani等人在2017年论文《Attention Is All You Need》中提出,用于机器翻译任务。其核心创新是自注意力机制(self-attention),允许序列中每个位置直接关注其他所有位置,从而突破了循环神经网络的序列依赖瓶颈。这一架构向机器人领域的迁移并非简单的模型搬运,而涉及根本性的表征转换:机器人的观测(图像、关节角度、力矩)和动作(连续的关节速度或末端位姿)需要被token化以适配Transformer的离散序列建模范式。
将机器人数据token化本身就是一个非平凡的工程与科学问题。机器人的观测空间高度异构:RGB图像是高维像素矩阵,关节角度是低维连续向量,力矩传感是时间序列信号。不同于NLP中已有成熟的BPE(Byte Pair Encoding)分词方案,机器人动作空间的离散化策略直接影响控制精度。常见方案包括均匀量化(将连续动作空间等间距划分为离散bin)和自适应量化(基于数据分布的k-means聚类)。RT-2采用了256个离散bin来表示每个动作维度,这意味着7自由度机械臂的动作空间被编码为7个token的序列。这种离散化不可避免地引入量化误差,对精细操作(如亚毫米级装配)构成挑战,催生了连续动作解码头等替代设计。Google DeepMind的Gato模型率先展示了将图像patch、文本token和离散化动作统一为同一序列的可能性,开创了通用智能体的研究方向。
视觉Transformer(Vision Transformer, ViT)是2020年Google提出的将Transformer架构应用于计算机视觉的突破性工作。不同于传统卷积神经网络的局部感受野,ViT将图像分割成固定大小的patch(如16×16像素块),并将每个patch视为一个token输入Transformer编码器,从而能够建模全局空间关系。在机器人领域,ViT的价值体现在:通过在大规模图像数据集上预训练(如ImageNet-21K),ViT学到的视觉表征具有强泛化能力,能更好地理解物体语义和空间关系;自注意力机制能够自适应地关注任务相关的视觉区域;统一的token化表示便于与语言模型融合。谷歌的RT-2、斯坦福的VoxPoser等代表性工作已证明,预训练视觉-语言模型能够显著提升机器人的zero-shot泛化能力。
zero-shot泛化是指模型在未经过特定任务训练的情况下,仅凭预训练知识就能执行新任务的能力。在机器人领域,这意味着机器人能够理解并执行训练时从未见过的指令,如'把蓝色的杯子放到木质托盘上'——即使训练中从未出现过'蓝色杯子'和'木质托盘'的组合。基础模型实现zero-shot的关键在于:通过海量互联网数据学习到物体、动作和空间关系的丰富先验知识;组合泛化能力,能将已知概念进行新组合;语言作为接口,使得任务规范可以灵活表达。例如,CLIP模型通过对比学习在4亿图像-文本对上训练,使机器人能够理解任意文本描述的物体,而无需针对每个物体单独训练。
更值得关注的是,视觉-语言-动作模型(Vision-Language-Action models, VLAs)正在重新定义机器人学习的整体架构。这类模型将视觉感知、语言理解和动作生成统一在单一框架中,使机器人能够接收自然语言指令并直接输出控制信号。典型VLA如Google的RT-2(Robotic Transformer 2)采用以下设计:首先使用预训练的视觉-语言模型(如PaLI)作为backbone来联合编码图像观察和自然语言指令;然后在输出端不仅生成文本token,还生成离散化的动作token(将连续的机器人动作量化为词汇表);通过统一的token序列建模,VLA能够利用互联网规模的视觉-语言数据进行预训练,从而获得常识推理能力,再用少量机器人演示数据微调即可实现新任务。这种架构的革命性在于打破了传统机器人学习中感知、规划、控制的模块化边界。
VLA模型的训练通常分为两阶段:首先在互联网规模的图文数据上进行视觉-语言预训练(获得物体识别、空间关系理解和常识推理能力),然后在机器人特定数据上进行微调(学习将语义理解转化为物理动作)。这一训练范式的成功依赖于"数据飞轮"效应——更好的策略能在真实环境中采集更高质量的数据,高质量数据又能训练出更好的策略。Toyota Research Institute的Diffusion Policy和Physical Intelligence的π0等模型进一步证明,将扩散模型(Diffusion Model)作为动作生成器比自回归token预测更适合连续控制任务,因为扩散模型天然支持多模态动作分布的建模,避免了离散化带来的精度损失。
基于Transformer的统一架构可以在多个任务间共享知识,从根本上突破传统行为克隆方法的任务孤岛问题。
LfD与基础模型:独立演进还是技术融合
当前的研究趋势表明,从演示学习和行为克隆并非被基础模型"取代",而是在经历一场"增强式融合"。主流方向包括以下几个:
混合架构设计
使用预训练视觉-语言模型提取高层语义特征,再结合传统行为克隆方法进行精细运动控制。这种方案同时兼顾了语义理解能力和动作执行精度,是目前工业界和学术界都在积极探索的技术路线。预训练模型负责理解"拿起红色方块"这样的高层指令并识别目标物体,而传统控制器负责规划抓取轨迹和力控制等底层执行细节。
少样本与单次演示学习
few-shot学习(少样本学习)是指利用极少量标注样本(通常5-10个)训练模型适应新任务的能力。在机器人场景中,采集大量演示数据成本高昂且耗时,few-shot学习因此具有重要实用价值。基础模型使few-shot机器人学习成为可能的机制包括:元学习(meta-learning),模型在多任务训练中学会'如何快速学习新任务';上下文学习(in-context learning),类似GPT的prompt机制,将少量演示作为上下文条件输入;迁移学习,利用预训练表征减少下游任务的样本需求。
元学习在机器人场景中的典型实现是MAML(Model-Agnostic Meta-Learning)及其变体。MAML的核心思想是学习一组"好的初始参数",使得模型在面对新任务时只需少量梯度步骤即可快速适应。在机器人操作中,每个"任务"可以是不同物体的抓取、不同目标位置的放置等。训练时,算法在大量任务上模拟"少样本学习"的过程,外层循环优化初始参数使内层快速适应效果最佳。然而,MAML在高维视觉输入下计算成本高昂,催生了基于Transformer的上下文元学习(contextual meta-learning)方法——将少量演示直接编码为Transformer的上下文token,利用注意力机制实现隐式的任务识别和策略适配,无需显式的梯度更新步骤。
相关研究显示,配合适当的提示工程策略,某些操作任务甚至可以实现one-shot学习,极大降低了数据采集成本。例如,使用CLIP等视觉-语言模型的表征,机器人抓取任务的few-shot性能可提升30-50%。
多模态数据深度利用
传统行为克隆主要依赖视觉-动作配对数据,而新一代方法开始整合语言描述、触觉反馈、力矩传感等多模态信号,构建更丰富、更鲁棒的策略表征。语言描述提供任务目标和约束的显式说明;触觉和力反馈对于接触丰富的操作(如插入、装配)至关重要;本体感知(关节角度、速度)帮助模型理解机器人自身状态。多模态融合使策略能够在不同传感器信号间建立对应关系,提升对传感器故障的鲁棒性。例如,Meta的RH20T数据集包含视觉、触觉、音频等多种模态,显著提升了精细操作任务的成功率。研究表明,多模态策略在遮挡、光照变化等challenging场景下的鲁棒性可提升40%以上。
扩散策略:行为克隆的新范式
值得特别关注的是扩散策略(Diffusion Policy)作为新一代行为克隆方法的崛起。2023年由哥伦比亚大学提出的这一方法将去噪扩散概率模型(DDPM)应用于机器人动作生成,代表了BC范式的重要演进。传统BC使用确定性网络或简单高斯分布建模动作,在面对多模态动作分布时容易产生"模式平均"问题(如在两条都可行的路径之间预测出一条不可行的中间路径)。扩散策略通过迭代去噪过程从高斯噪声中逐步恢复出动作序列,天然能够表达复杂的多模态分布。该方法在多个操作基准上取得了state-of-the-art性能,并且与动作分块技术天然兼容——每次去噪过程生成一个完整的动作序列片段。这一成功推动了生成模型在机器人控制中的广泛应用,包括Physical Intelligence的π0和Google的Aloha等后续工作,证明了行为克隆在生成模型加持下仍然具有强大的生命力。
未来研究中的开放问题
尽管技术融合趋势明显,机器人学习领域仍存在诸多未解难题:
-
实时性挑战:基础模型的计算开销如何适配机器人实时控制的延迟要求?大型Transformer模型的推理延迟通常在100ms以上,而机械臂控制频率要求达到100-1000Hz(即1-10ms的控制周期)。当前解决方案包括:模型蒸馏,将大模型的知识压缩到小模型中,推理速度可提升5-10倍;早期退出机制(early exit),根据样本难度动态调整计算量;分层架构,将基础模型用于高层规划(10-100Hz)而低层控制使用轻量PID或MPC控制器(1000Hz)。例如,Google的RT-1使用EfficientNet作为视觉编码器,推理延迟控制在3Hz,通过动作分块(action chunking)技术预测未来多步动作来弥补低频率的不足。动作分块是近年来应对推理延迟的重要技术创新,最早在ACT(Action Chunking with Transformers)中被系统性提出,其核心思想是模型在每次前向推理时不只预测下一步动作,而是预测未来一个窗口内的多步动作序列(如未来50-100步)。这样即使模型推理频率只有3-10Hz,通过在推理间隔内按序执行预缓存的动作序列,实际控制频率仍可达到50Hz以上。动作分块还隐式地引入了时间一致性约束,减少了逐帧预测中常见的动作抖动问题,已被广泛应用于RT-1、Octo等主流机器人基础模型中。英伟达的ORBIT框架则通过GPU加速使Transformer策略达到50Hz的控制频率。
-
可解释性需求:在安全关键应用场景(如手术机器人、自动驾驶)中,如何保证决策的可解释性?端到端神经网络策略的黑盒特性使得故障诊断和安全认证面临挑战。研究方向包括:注意力可视化,通过热力图展示模型关注的图像区域,帮助理解决策依据;反事实解释(counterfactual explanation),通过修改输入观察最小改变并观察输出变化来揭示因果关系;神经符号方法(neuro-symbolic),将神经策略与符号规划相结合,如使用LLM生成可读的中间推理步骤。例如,Code as Policies方法让LLM生成Python代码来表达机器人任务规划,代码本身即是可解释的任务分解。SayCan框架则将LLM的高层规划与视觉grounding相结合,明确展示'为什么选择这个动作'。在医疗和自动驾驶等安全关键领域,可解释性不仅是研究需求,更是监管合规的必要条件。
-
物理交互的迁移边界:预训练知识在涉及物理接触和力交互的任务中,迁移能力的边界在哪里?视觉-语言预训练主要来自静态图像和文本,缺乏物理动力学和因果关系的真实体验。接触丰富的操作(如布料折叠、液体倾倒、螺丝拧紧)需要精确的物理建模,纯视觉预训练的帮助有限。混合方法包括:结合物理仿真器(如Isaac Gym、MuJoCo)进行预训练,让模型在虚拟环境中积累物理交互经验;使用触觉基础模型(如Meta的Touch and Go)补充物理先验,触觉传感器能直接感知接触力、滑动等信息;因果世界模型,学习物体间的因果关系和物理约束。Sim-to-Real(仿真到真实的迁移)是弥补这一缺陷的经典范式,其核心挑战在于仿真与真实世界之间的现实差距(reality gap)。为了跨越这一鸿沟,研究者发展出域随机化(Domain Randomization)技术——在仿真中随机化物理参数(摩擦系数、质量、阻尼等)和视觉参数(纹理、光照、相机位姿等),迫使策略学习对这些变化鲁棒的行为。NVIDIA的Isaac Gym利用GPU并行化可同时运行数千个仿真环境,使训练效率提升数个数量级。近期的趋势是将可微物理仿真(differentiable simulation)与神经网络结合,允许梯度直接从物理约束反向传播到策略参数。可微物理仿真的技术核心是将物理引擎中的前向动力学方程实现为可微分运算,使得损失函数相对于策略参数的梯度可以沿时间反向传播通过物理模拟步骤。传统的强化学习方法(如PPO)需要通过大量采样来估计策略梯度,而可微仿真提供的解析梯度方差为零且信息量远大于采样估计。关键技术挑战包括接触动力学的不可微性(碰撞事件导致状态不连续),通常通过软接触模型或随机平滑技术来近似处理。代表性框架包括NVIDIA的Warp、Google的Brax和CMU的Nimble。例如,MIT的DiffSkill通过可微物理仿真学习操作技能,在布料折叠等任务上显著优于纯视觉方法。DeepMind的相关研究表明,触觉反馈可使插入任务的成功率从60%提升至95%以上。
-
数据采集与评估标准:如何建立统一的机器人学习基准和评估协议?不同实验室使用不同的机器人平台、任务定义和成功标准,导致研究结果难以比较。Open X-Embodiment等大规模多机器人数据集和标准化评估协议的建立正在改善这一状况。Open X-Embodiment是由Google DeepMind联合全球21个机构于2023年发布的大规模机器人数据集,包含来自22种不同机器人形态的超过100万条真实操作轨迹。这一数据集的意义远超数据量级本身:它首次验证了跨具身形态(cross-embodiment)迁移学习的可行性——在多种机器人数据上联合训练的策略(如RT-X模型)在每种机器人上的表现都优于仅用该机器人数据训练的策略。这一发现类似于NLP中多语言联合训练带来的性能提升,暗示不同机器人形态之间存在可共享的操作知识。与此并行的DROID数据集(分布式机器人交互数据集)则强调了数据收集流程的标准化,提供统一的硬件方案和标注协议,为社区贡献可复现、可比较的基准数据。
这些问题的答案,将决定机器人学习领域接下来的发展走向。可以确定的是,从演示学习和行为克隆不会消亡,但它们的实现形式正在被深刻改写——从孤立的算法模块,演变为与大规模基础模型协同工作的智能系统核心组件。传统方法积累的精细控制、安全保障和领域知识仍然不可或缺,而基础模型带来的语义理解、常识推理和泛化能力则打开了新的可能性空间。未来最有前景的方向是将两者的优势有机结合,构建既能理解高层意图又能精确执行底层动作的机器人智能系统。
核心要点
- 从演示学习和行为克隆面临数据效率低、泛化能力弱和分布偏移等固有挑战,其中分布偏移的误差以O(εT²)的速度累积,根源在于将序贯决策问题简化为i.i.d.监督学习
- Transformer架构从NLP到视觉再到机器人的跨域迁移,需要将多模态观测和连续动作token化为统一序列表示,其中动作量化策略直接影响控制精度
- 视觉Transformer通过全局注意力机制和大规模预训练提供强大的视觉表征能力
- 视觉-语言-动作模型将多模态感知与动作生成统一,实现端到端的指令到执行映射,其训练依赖两阶段范式和数据飞轮效应
- 扩散策略作为新一代行为克隆方法,通过建模多模态动作分布解决了传统BC的模式平均问题
- 当前主流方向是增强式融合:混合架构、few-shot学习和多模态整合
- 元学习(MAML)和上下文元学习为机器人少样本适应提供了系统性的解决方案
- 动作分块、模型蒸馏和分层架构是应对实时性挑战的关键技术
- Sim-to-Real迁移、可微物理仿真和域随机化正在弥合基础模型在物理交互方面的能力缺口
- Open X-Embodiment等标准化数据集验证了跨具身形态迁移学习的可行性
- 未来机器人学习将是传统精细控制与基础模型语义理解的有机结合
相关推荐
企业级AI Agent全栈开发实战:从零搭建可上线智能体的学习路径
一份企业级AI Agent全栈开发课程导学解析:涵盖为什么学Agent、适合人群、LangChain与CrewAI框架学习路径,以及从单智能体到多智能体的实战落地方案,助你搭建可上线的智能体应用。
从真实项目拆解AI智能体:基于LangGraph的学习助手架构实践
以真实上线的AI学习助手为例,拆解基于LangGraph、Neo4j知识图谱、Redis与MinIO的智能体架构实践,解析为何面试官偏爱复杂真实项目,以及FDE岗位的求职方向。
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。