机器学习学术界与工业界正在分道扬镳?

机器学习学术界与工业界关系逆转:从idea输出方变为追随者,需重新定位比较优势。
文章回顾了机器学习领域学术界与工业界关系的结构性变化。2012至2018年间,学术界处于“卖方市场”,ADAM、TRPO等方法快速被工业界采纳。但过去几年,大型科技公司建立起规模远超高校的研究团队,工业界成为主要idea发生器,学术界的大量跟进论文难以获得严肃采纳。优化器和网络架构等学术提案遇冷,根源在于学术评价体系与工程现实之间的错位——论文追求benchmark上的边际提升,工业界关心大规模系统下的稳定性与总成本。工业界的“无动于衷”还有制度性原因:基础设施兼容性、迁移成本和内部迭代优先。文章最后探讨学术界的价值所在,认为应转向工业界不易做的长周期、批判性和基础性研究,并指出当前正处于旧模式松动、新模式未成型的过渡期。
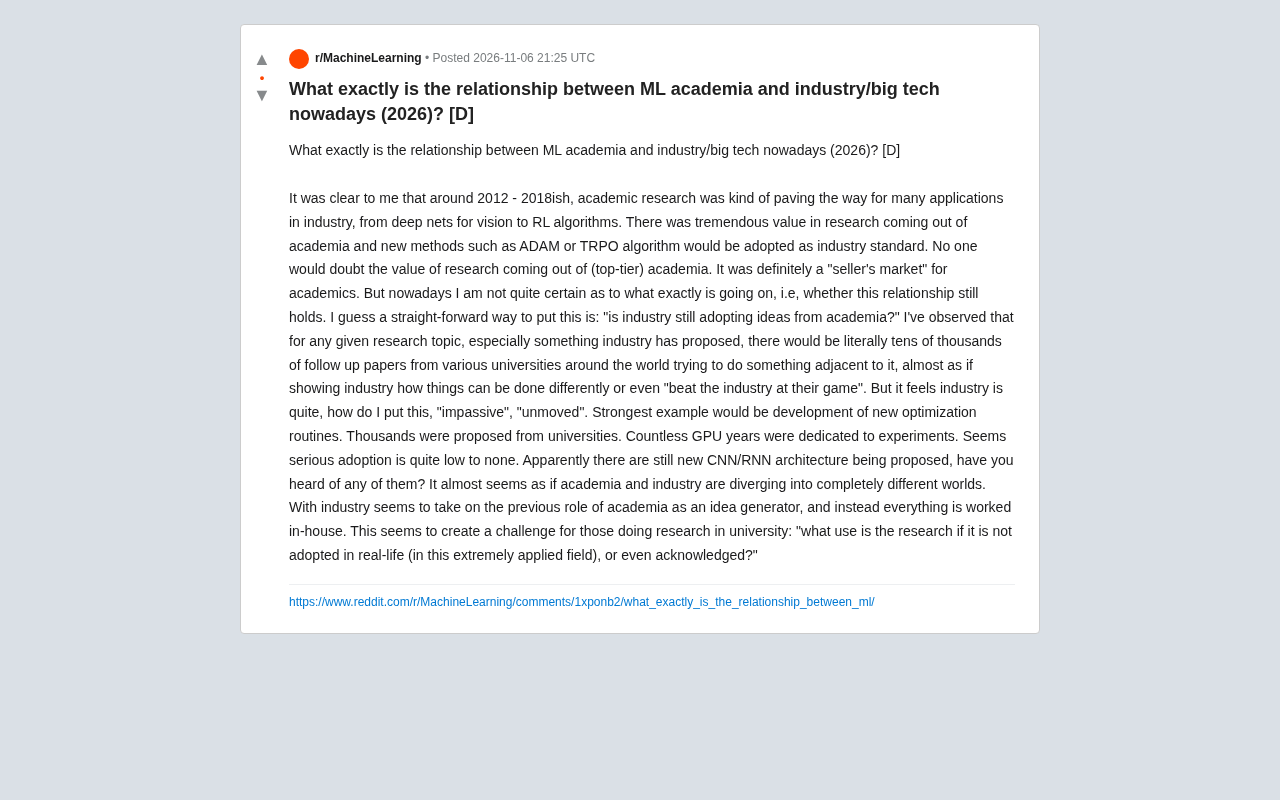
过去十年,机器学习领域最引人注目的变化之一,是学术界与工业界之间那条曾经清晰的“idea 传送带”正在变得模糊。一位研究者在 Reddit 上发帖感叹:2012 到 2018 年间,学术研究几乎在引领工业应用的每一步——从视觉领域的深度网络到强化学习算法,ADAM、TRPO 这些出自学术论文的方法很快成为工业标准。那是一个属于学术界的“卖方市场”。但如今,他观察到一种截然不同的景象:工业界提出的方向会引来全球高校数以万计的跟进论文,却似乎不为所动;学术界仍在不断提出新的优化器、新的 CNN/RNN 架构,却很难看到它们被真正采纳。这种错位感,正在成为许多机器学习研究者共同的困惑。
从“卖方市场”到“各说各话”
帖子中回顾的那个阶段有其特殊背景。深度学习刚刚证明自己在视觉、语音等任务上的压倒性优势,工业界急需方法论指导,而学术界恰好是这些方法的策源地。ADAM 优化器、TRPO 强化学习算法从论文到工程实践的速度非常快,因为工业界当时缺乏足够成熟的内部研究体系,需要从外部吸收养分。
但这一格局在过去几年发生了逆转。大型科技公司已经建立起规模远超多数高校实验室的研究团队,拥有海量数据、充裕算力和明确的商业场景。当工业界自己成为“idea 发生器”时,学术界的角色就被动了许多。发帖者用了一个很形象的描述:学术界像是在试图“在工业界擅长的领域打败工业界”,但工业界对此“无动于衷”。
ADAM 与 TRPO 是深度学习早期两个具有代表性的算法。ADAM(Adaptive Moment Estimation)由 Kingma 和 Ba 于 2014 年提出,是一种基于梯度的随机优化方法,通过计算梯度的一阶矩和二阶矩估计,为不同参数自适应地调整学习率。它实现简单、对超参数不敏感,迅速成为训练深度网络时最常用的优化器之一。TRPO(Trust Region Policy Optimization)由 Schulman 等人于 2015 年提出,是一种用于强化学习的策略梯度算法,通过在信任域内约束策略更新幅度来保证训练稳定性,后来被 PPO 等更简化的变体继承。两者都出自学术论文,却很快被工业界采纳为标准工具,这正是“卖方市场”阶段的典型写照:学术界提供方法论,工业界直接吸收并大规模应用。
优化器与架构:学术提案为何难被采纳
发帖者给出了两个具体例子。其一是优化例程:高校提出了成千上万种新优化器,消耗了难以计数的 GPU 实验时间,但真正被工业界严肃采纳的寥寥无几。其二是网络架构:新的 CNN/RNN 架构仍在被不断提出,但有多少能进入实际生产系统,答案并不乐观。
这种现象背后并不完全是“学术研究质量下降”。更可能的原因是评价体系与工程现实之间的错位。学术论文追求在标准 benchmark 上的边际提升和理论优雅性,而工业系统关心的是在大规模数据、异构硬件和长周期维护下的稳定性与总成本。一个在小型图像分类数据集上表现优异的优化器,放到千亿参数模型的分布式训练中,可能连收敛都成问题。工业界不是没有看到这些论文,而是“看到之后觉得不值得换”。
Benchmark 与工程现实之间的错位是理解这一现象的关键。学术论文通常在小规模标准数据集(如 CIFAR-10、ImageNet 子集)上评估优化器或架构,报告的是准确率、收敛速度等指标。但工业界的生产系统面对的是千亿参数级别的分布式训练、异构硬件集群、混合精度计算和长周期维护。一个在学术 benchmark 上提升 0.5% 的优化器,在真实场景中可能因为通信开销、数值稳定性或与现有工具链不兼容而被放弃。此外,工业界评估新方法时还要考虑迁移成本、回滚风险和长期维护责任,这些维度在论文中几乎从不出现。因此,学术提案“遇冷”往往不是质量不足,而是评价维度不匹配。
工业界为何显得“无动于衷”
发帖者感受到的“冷漠”,其实有制度性原因。大型科技公司的研究团队如今有自己的发表节奏、内部评审和产品落地路径。外部学术提案要进入这套体系,需要经过比论文审稿更复杂的评估:能否在现有基础设施上运行、是否兼容已有的工具链、迁移成本是否可控、长期维护由谁负责。这些问题的答案往往指向“不如自己内部迭代”。
另一个被忽视的因素是人才流动。工业界已经从高校吸纳了大量研究者,许多曾经会在学术界产生影响力的方向,如今直接在公司内部推进。学术界的“跟进论文”数量庞大,但其中相当一部分是在工业界已经公开的方向上做增量改进,很难形成反向输出。
学术界的研究还有用吗?
这是发帖者最核心的焦虑:在一个极度应用导向的领域里,如果研究不被实际采纳、甚至不被承认,它的价值在哪里?
一种回答是,学术界的价值不应只用“被工业采纳”来衡量。基础理论、可解释性、鲁棒性、公平性、小样本学习等方向,短期内难以直接转化为产品收益,但它们是领域长期健康发展的基础设施。工业界有动力做“下一个大模型”,但未必有动力做“十年后才能用上的理论工具”。
另一种回答更现实:学术界需要重新定位自己的比较优势。在算力和数据上无法与工业界竞争时,学术界可以转向工业界不易做的方向——小规模下的机理研究、跨学科应用、独立基准的构建、以及对工业界方法的批判性审视。发帖者提到的“数万篇跟进论文”现象,恰恰说明学术界在选题上过度依赖工业界信号,这种策略本身需要反思。
可解释性、鲁棒性与公平性等研究方向,是学术界能够发挥独特价值的典型领域。工业界的产品化压力使其更关注短期指标和商业回报,而这类研究往往需要长期投入且难以直接量化收益。例如,可解释性研究试图揭示模型决策的内在逻辑,鲁棒性研究关注模型在对抗样本或分布偏移下的表现,公平性研究则审视算法对不同群体的影响。这些方向不仅关乎技术可靠性,也涉及伦理和社会责任,是领域长期健康发展的基础设施。工业界有动力做“下一个大模型”,但未必有动力做“十年后才能用上的理论工具”,这正是学术界可以填补的空白。
分道扬镳还是重新分工
把当前局面描述为“学术界与工业界分道扬镳”,可能只说对了一半。更准确的描述或许是:两者正在形成一种新的分工,但分工的边界尚未稳定,评价体系也没有跟上。工业界负责大规模工程化和产品化,学术界负责探索性、批判性和长周期研究,这个分工在理论上合理,但在实践中面临 funding、发表压力和人才市场的多重扭曲。
对于身处其中的研究者,发帖者的困惑是真实的:在一个应用驱动的领域,如何证明自己工作的价值?这个问题没有标准答案,但至少可以明确一点——简单跟随工业界的热点做增量论文,既难以获得工业界采纳,也难以形成学术独立性。找到工业界“不能做”或“不愿做”的问题,可能比在工业界擅长的领域里竞争更有生命力。
这场讨论在 Reddit 上引发的共鸣,本身就说明它不是个别研究者的感受,而是一个结构性变化的缩影。学术界与工业界的关系仍在演化,而 2026 年的我们,正处在旧模式已经松动、新模式尚未成型的过渡期。
Funding 与发表压力是理解学术界行为模式的重要背景。学术研究者的职业发展高度依赖论文发表数量和引用量,而顶会论文的审稿标准往往偏好“在标准 benchmark 上刷新 SOTA”的工作。这种激励结构导致研究者倾向于跟随工业界的热点方向,因为热门方向更容易获得关注和引用,也更容易在短期内产出可发表的增量成果。相比之下,长周期、高风险、跨学科的研究方向在现有评价体系下处于劣势。因此,学术界在选题上过度依赖工业界信号,不仅是个人选择,也是制度压力下的理性反应。要改变这种局面,需要从 funding 机制和评价标准层面进行结构性调整。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。