寄生弹定理:AI自修流水线为何永远修不好自己
AI流水线自修时,修复者与被修物同处一个进程,导致补丁永远无法在当前周期生效。
本文围绕「寄生弹定理」展开:当AI修复逻辑与被修复对象跑在同一进程载体上,修复动作在物理上无法当场生效。作者从七天实战中提炼出三类死区变体——启动路径自锁(修复者根本等不到被激活)、ESM模块缓存冻结(新代码在磁盘但内存中仍是旧版本)、验证结果排队延迟(效果要等下一个run才能确认)。三者的公共根因是「载体没分离」。对应的破局原则是:判定逻辑子进程化以绕过缓存冻结、用语义幂等替代引用计数以避免自锁、在报告中诚实标注修复的生效轮次。文章最终指出,最危险的bug不是让系统崩溃的,而是让系统无法被修复的,因此任何自动化自修系统都必须预留人类可从外部介入的通道。
让AI流水线自己修自己的bug,听起来是自动化的终极形态。但一位B站UP主在连续七天的实战中,撞上了一个反复出现的残酷规律——他将其命名为「寄生弹定理」:一条会自己开发自己的流水线,永远修不好让自己启动的那段代码。
这不是玄学,而是系统架构层面的必然。当修复者和被修物跑在同一个载体上,修复就永远无法当场生效。本文拆解他遭遇的三个真实变体,以及破局的三条原则。
寄生弹定理:修复者与被修物的载体困境
用一句话概括这个定理:当修复者和被修物跑在同一个载体上,修复永远无法当场生效。
设想你用进程A去修进程A的bug。修完的那一刻,正在运行的仍然是旧代码——新代码要等进程重启才能加载。更致命的情况是,如果你要修的偏偏是让A启动的那段路径,那么连「下一次机会」都不会有:A根本起不来,也就没有下一次运行去加载修复。
这就是为什么AI报告「修好了」,流水线却还是起不来的根本原因。AI在逻辑层面确实产出了正确的补丁,但补丁所在的载体和被修复对象是同一个,修复动作在物理上无法在当前运行周期内生效。
三个死区变体:一个比一个刁钻
作者在七天里踩中三个变体,恰好对应三种不同的「自修窗口为零」情形。
变体一:启动路径自锁
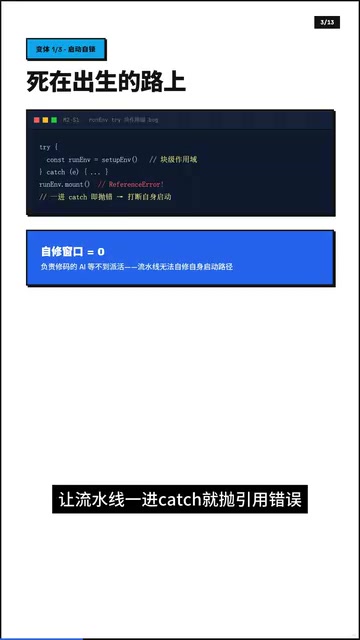
最典型的一例。编排器里一个作用于启动阶段的 try 块抛出了引用错误,流水线一进入缓存阶段就崩溃,直接打断自己的启动流程。负责修代码的AI根本等不到被派活——流水线死在了出生的路上。
更棘手的是配套的锁释放逻辑用了引用计数,结果双重获取的单例锁被拿了两次却只释放一次,系统把自己彻底锁死。这里的自修窗口为零:修复物就是启动路径本身。
变体二:ESM缓存冻结判定逻辑
这个变体更隐蔽。编排器进程启动那一刻,通过 import 引入的判定模块就被缓存成了「定格版本」。开发窗口里的AI明明把判定逻辑改对了,但运行中的「裁判」还在用旧规则判卷——修了等于没修。
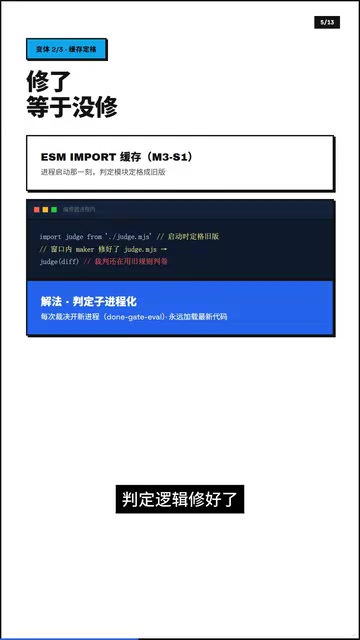
问题出在长驻进程里的模块缓存:新代码存在于磁盘,但内存里跑的还是启动时加载的旧模块。解法是把判定逻辑子进程化,每次裁决都新开一个进程,从而加载到最新代码。
ESM(ECMAScript Modules)是 Node.js 现代模块系统的标准格式。与旧版 CommonJS 的 require() 不同,ESM 的 import 语句在进程启动时被静态解析并一次性加载到内存,之后不会再重新读取磁盘。这意味着只要宿主进程没有重启,无论你在文件系统上如何修改模块代码,内存中运行的永远是启动那一刻缓存的「快照」。这一特性在普通开发场景下反而是性能优势——避免了重复 I/O,加快了模块解析速度。但在需要热更新判定逻辑的 AI 流水线场景中,它会精确地制造出「改了等于没改」的幻觉。子进程化的解法利用的正是进程边界天然清除内存缓存的性质:每次新开子进程,操作系统分配全新的内存空间,import 重新从磁盘读取,从而绕过了长驻进程的缓存冻结问题。
变体三:验证结果的排队延迟
最磨人的一类。修复的真实效果要等到下一个 run 才生效。作者提到某个模块的两个片区,修复要跨到下一轮才验证;而断路器机制更是要四个 run 才能收口。中间还夹杂着通道抽风、环境损坏、漏包、外壳超时收口等各种插曲。
修复本身没有错,只是它的验证永远要排队。这类问题识别不出来,团队就会陷入「在当前轮无限重试」的慢性烧钱状态。
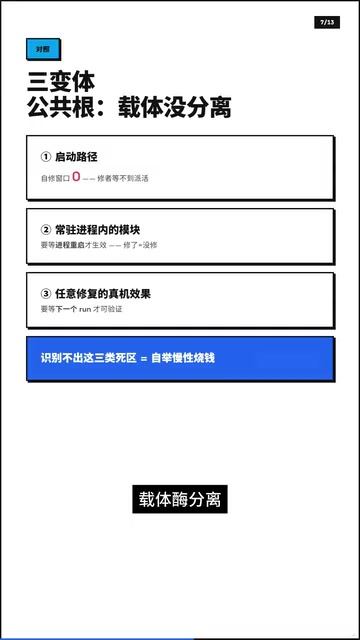
三个变体摆在一起,规律就浮现了:第一例的自修窗口为零,第二例要等进程重启才生效,第三例要等下一个 run 才可验证。公共根因只有一个词——载体没分离。
断路器(Circuit Breaker)是借鉴自电路保护的软件容错模式:当某个下游服务或模块的失败率超过阈值,断路器自动「跳闸」,在冷却期内拒绝所有请求,防止雪崩式连锁失败。冷却期结束后进入半开状态,允许少量试探性请求通过,成功则恢复,失败则重新跳闸。这套机制本身引入了多个 run 跨度的状态机转换,意味着一次修复的效果必须经历「关闭→跳闸→冷却→半开→验证」的完整周期才能被确认。在 AI 自修流水线中,如果修复逻辑本身就嵌套在断路器保护的调用链里,验证延迟会被进一步放大。文章提到「四个 run 才能收口」,正是断路器状态机与流水线调度周期叠加的结果,而非修复本身有问题。
破局三原则:把裁判搬到进程外
针对这三类死区,作者提炼出三条可落地的原则。
原则一:载体分离
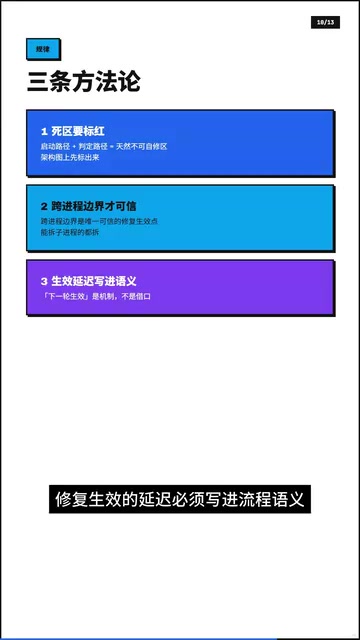
要修的代码绝不能跑在要被修复的进程里。判定逻辑一律子进程化。跨进程边界,是唯一可信的修复生效点——能拆子进程的都拆出去。这样每次裁决都基于磁盘上的最新代码,而非内存里的定格版本。
原则二:语义幂等
锁的获取与释放不要依赖引用计数,因为引用计数会自锁。改用规格级的「存在即处理」判断——不数次数,只判断状态是否满足。这样即便流程被重复触发,也不会把自己锁死。
引用计数(Reference Counting)是一种常见的资源生命周期管理策略:每次获取锁或引用时计数加一,释放时减一,归零则销毁。这套机制在单线程、线性流程中运作良好,但在流水线被重复触发、异常中断或并发调用的场景下极易出现计数不对称——获取了两次却只释放一次,锁就再也无法被清除。语义幂等的思路是把「该状态是否存在」作为唯一判断依据,而非依赖「被操作了多少次」这一过程信息。具体实现上,可以用数据库或文件系统中一个带有明确语义的布尔标志替换计数器,任何时刻都能通过读取当前状态来判断是否需要处理,重复触发只会得到相同结果,而不会累积副作用。这也是分布式系统中「至少一次投递」场景下的标准防护模式。
原则三:诚实披露延迟
「修复要下一个 run 才生效」这件事必须写进终审报告,不许粉饰成「当场已验证」。下一轮生效是机制而非借口,把它当成流程语言的一部分明确标注出来。
最有意思的验证发生在断路器机制建好的当天:流水线自己的窗口派发就崩了。作者按刚建好的诊断注入通道把诊断位回填,一个窗口就收了口。机制先于落地,先治好了自己——这个「验证自己的验证」的闭环,才是整套实践真正的副产品。
今天就能用的三个动作
这三条原则都不需要引入新框架,当天就能生效:
- 画出自动化系统的启动依赖图,把「修不了自己」的死区在架构图上标红。启动路径和判定路径是天然的不可自修死区。
- 把常驻进程里的判定逻辑拆成子进程,每次裁决都携带最新代码,堵住模块缓存冻结的漏洞。
- 给修复验证写明生效轮次,别在当前轮里无限重试。
作者最后的洞察值得记住:最危险的bug不是让系统崩溃的bug——系统崩了你至少还知道。最危险的是让系统「无法被修复」的bug,它挡住的是所有未来的修复。
寄生弹定理教会的不是如何识别自举,而是先给自己留一扇人能推开的门。在设计任何自动化自修系统时,都要预留一个人类可以从外部介入的通道,否则一旦踩中死区,整套系统就会陷入无解的死循环。
相关推荐
用Google ADK打造自主代码监控Agent:让非技术人员也能管项目
一位技术博主用Google ADK(Agent Development Kit)构建了自主代码库监控Agent,实现测试覆盖率提升、每日提交摘要与Kubernetes集群只读监控,并部署到Google Cloud定时运行。本文详解Agent与Assistant区别、ADK开发流程及安全注意事项。
Cherry Studio + MCP 实战:搭建本地知识库与自动化AI智能体
本文详解如何用开源客户端 Cherry Studio 结合 MCP 协议和 Ollama,搭建自动化 AI 智能体与本地知识库,涵盖 DeepSeek 模型配置、UV/Bun 环境、Function Call 限制及网页抓取、Shell 控制等实战场景。
五角大楼承认AI过度依赖酿祸:误袭伊朗学校事件警示
五角大楼承认AI过度依赖酿祸:误袭伊朗学校事件警示
五角大楼承认对AI系统的过度依赖是误袭伊朗某学校事件的重要原因,本文剖析军事AI在目标识别、人在回路机制与问责难题上的深层风险及其对AI部署的普遍启示。