奖励预算机制破解LLM推理RL的早熟收敛难题

奖励预算通过固定每提示总奖励构造递减回报优势,抑制策略尖锐化并提升LLM推理RL训练。
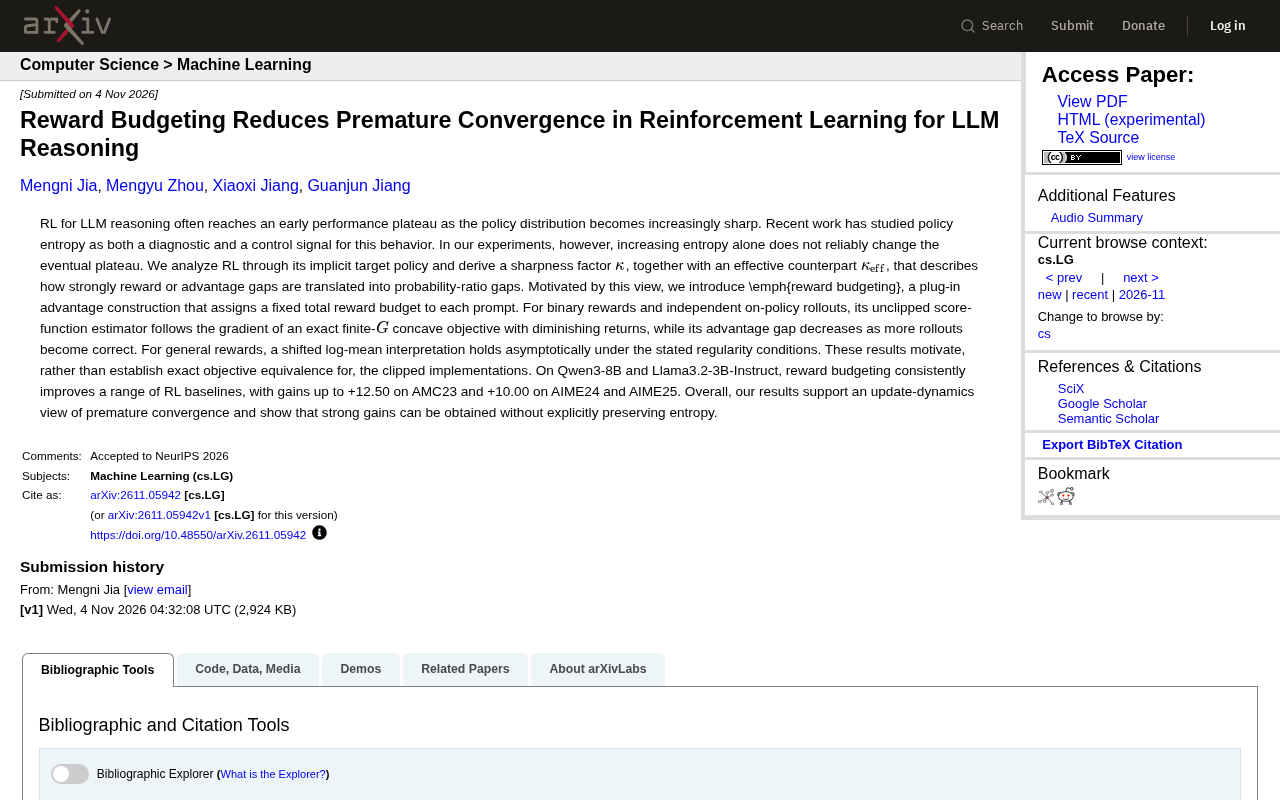
文章介绍了一项针对大语言模型强化学习推理训练中早熟收敛问题的新研究。作者指出,策略分布随训练变得尖锐导致性能停滞,而单纯提高熵并不能可靠突破平台期,说明熵只是症状而非病因。研究从更新动力学出发,推导出描述奖励差距转化为概率比差距强度的尖锐度因子κ,并提出“奖励预算”机制:为每个提示分配固定总奖励,在预算约束下构造优势函数,使回报递减、优势差距随正确样本增多而缩小。在Qwen3-8B和Llama3.2-3B-Instruct上,该方法一致改善多种RL基线,AMC23最高提升+12.50,AIME24/25各提升+10.00,且无需显式熵正则化。作者也承认理论主要针对未裁剪估计器,裁剪实现的等价性尚未严格证明。
强化学习(RL)在提升大语言模型(LLM)推理能力方面展现出巨大潜力,但一个顽固的问题始终存在:策略分布随着训练进行变得越来越尖锐(sharp),导致模型过早收敛到次优解,性能提升陷入停滞。近期一项研究从更新动力学的角度重新审视了这一现象,并提出了名为“奖励预算”(reward budgeting)的简单插件式方法,在不显式维持熵的情况下显著改善了多个RL基线。
熵作为控制信号的局限
此前的研究试图将策略熵同时作为诊断工具和控制信号,通过人为增加熵来延缓收敛。但该论文的作者在实验中发现,仅仅提高熵并不能可靠地改变最终的平台期。这意味着,熵可能只是症状而非病因,真正的问题在于奖励或优势差距如何被映射到概率比差距上。
这一观察促使研究者转向一个更根本的视角:分析RL的隐式目标策略。他们推导出一个“尖锐度因子”κ(kappa)及其有效版本κ_eff,用来描述奖励差距或优势差距转化为概率比差距的强度。κ值越大,策略越容易变得尖锐,从而过早锁定在某些行为模式上。
策略熵(policy entropy) 在强化学习中衡量策略输出的不确定性或随机性。对于LLM,它大致对应给定提示时模型生成不同回答的分散程度:熵高时模型倾向于探索多种推理路径,熵低时则高度集中在少数甚至单一路径上。RL训练中,策略往往随着奖励优化而逐步熵减,最终“坍缩”到某类固定行为,这正是早熟收敛的典型表现。因此不少工作把熵当作诊断指标——熵下降预示探索不足;也把它当作控制信号——通过熵正则项或熵奖励人为维持随机性。但熵是策略分布的整体统计量,并不能直接反映奖励差距如何转化为参数更新幅度,这解释了为何单靠调熵有时无法改变平台期。
奖励预算:固定总额的优势构造
基于上述分析,研究者提出了奖励预算机制。其核心思想非常简洁:为每个提示(prompt)分配一个固定的总奖励预算,然后在这个预算约束下构造优势函数。对于二元奖励和独立的同策略 rollout,这种未裁剪的得分函数估计器遵循一个精确的有限G凹目标函数的梯度,该目标函数具有递减回报特性;同时,随着更多 rollout 变得正确,优势差距会相应减小。
对于一般奖励形式,在给定的正则条件下,该方法可以渐近地解释为一种平移对数均值(shifted log-mean)形式。研究者谨慎地指出,这些结果是为裁剪实现提供动机,而非建立精确的目标等价性。这种理论上的克制反而增强了方法的可信度。
同策略 rollout(on-policy rollout) 指用当前正在训练的策略本身采样生成轨迹,再用这些轨迹计算优势并更新同一策略。与之相对的离策略方法使用旧策略或行为策略产生的数据,需要重要性采样校正。同策略保证了梯度估计的无偏性,但代价是数据利用率低、每次更新后需重新采样。本文的理论推导明确建立在同策略、独立采样的 rollout 之上,这使得“固定总奖励预算下优势差距随正确样本增多而减小”的结论具有清晰的概率含义;一旦引入离策略数据或跨迭代复用,优势的统计性质会改变,预算机制的效果也需重新审视。
实验效果:多模型多基准的稳定提升
在 Qwen3-8B 和 Llama3.2-3B-Instruct 两个模型上,奖励预算机制一致地改善了多种RL基线。具体而言,在 AMC23 基准上获得了最高 +12.50 的提升,在 AIME24 和 AIME25 上分别有 +10.00 的提升。这些增益是在不显式保留熵的情况下取得的,直接挑战了“必须维持熵才能避免早熟收敛”的常见假设。
更新动力学视角的启示
这项工作的价值不仅在于一个即插即用的技巧,更在于它提供了一种理解早熟收敛的新框架。与其将熵视为需要人为调节的旋钮,不如关注奖励信号如何塑造更新动力学。奖励预算通过限制每个提示的总奖励,自然地产生递减回报,使得策略不会因为少数高奖励样本而过度尖锐化。
对于实践者而言,这意味着在RL训练LLM推理能力时,可以尝试在优势计算阶段加入这种预算约束,而无需修改现有的熵正则化或裁剪机制。代码层面的改动很小,但潜在收益显著。
优势函数(advantage function) 衡量某个动作(在LLM中即某个token或整条回答)相对于基线策略的平均表现好多少,通常写作 A(s,a)=Q(s,a)−V(s),其中 Q 是动作价值、V 是状态价值。策略梯度方法用优势乘以对数概率的梯度来更新参数:优势为正则提高该动作概率,为负则降低。优势的绝对尺度直接决定每次更新的步幅,因此当少数高奖励样本产生极大优势时,策略会被猛烈推向这些样本,分布迅速尖锐化。奖励预算正是从这一环节入手:限制每个提示可分配的总奖励,使优势差距随正确样本增多而收缩,从而在源头抑制过大的更新步幅,而不依赖事后裁剪或熵正则。
局限与未来方向
论文作者明确承认,当前的理论结果主要针对未裁剪的估计器,对于实际使用的裁剪实现,等价性并未严格建立。此外,实验规模限于两个中等规模的模型,在更大模型和更多样化任务上的泛化能力仍需验证。不过,这些局限并不削弱核心贡献——它指出了一个被忽视的调节杠杆,并给出了有理论支撑的实证证据。
总体来看,奖励预算机制为LLM推理的强化学习训练提供了一条简单而有效的路径,其背后的更新动力学视角也可能启发更多关于RL训练稳定性的研究。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。