教材还是病例?数据类型如何塑造医疗大模型能力
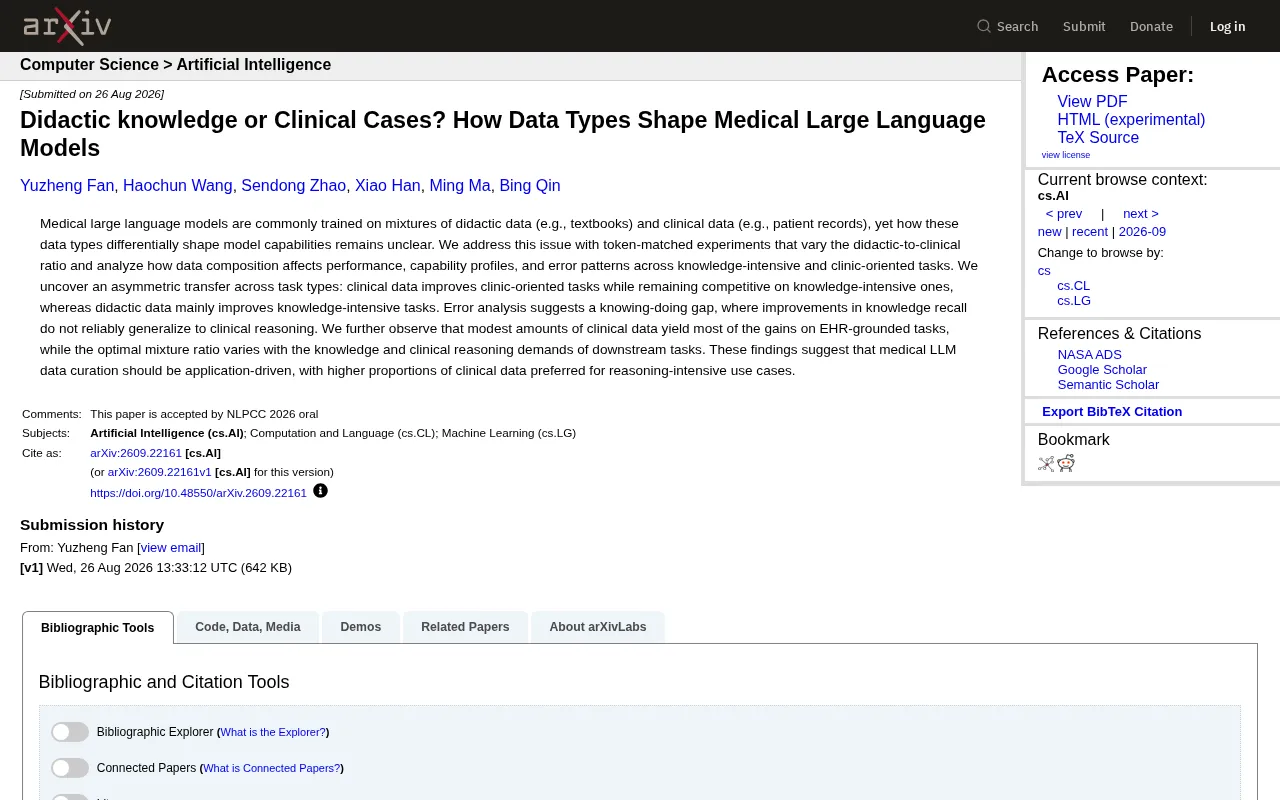
对照实验揭示临床数据比教材数据迁移范围更广,且存在知识记忆与临床推理之间的「知行鸿沟」。
这项发表于 arXiv 的研究通过 token 数量对齐的严格对照实验,系统比较了教学型数据(教科书)与临床型数据(患者病历)对医疗大语言模型能力的差异化影响。核心发现是两类数据之间存在非对称迁移:临床数据不仅提升了临床推理任务表现,在知识密集型任务上也保持竞争力,而教学数据主要强化知识记忆,难以迁移至实际诊疗推理。研究还揭示了「知行鸿沟」——知识记忆的提升并不能可靠转化为临床推理能力——对当前依赖 USMLE 等知识型基准评估医疗模型的做法提出了警示。此外,少量临床数据即可带来 EHR 任务的大部分收益,意味着数据类型与配比比单纯数据量更能决定模型的临床价值。
医疗大语言模型(Medical LLM)通常混合两类数据进行训练:以教科书为代表的教学型数据(didactic data),以及以患者病历为代表的临床型数据(clinical data)。但一个长期悬而未决的问题是——这两类数据究竟如何差异化地塑造模型能力?一篇新发布于 arXiv 的研究通过严格的对照实验,给出了颇具启发性的答案。
研究方法:Token 对齐的对照实验
这项研究的核心设计在于token-matched experiments(token 数量对齐的实验)。研究者在保持训练 token 总量一致的前提下,系统性地调整教学型数据与临床型数据的配比,从而干净地分离出「数据类型」这一变量的影响,而不是让数据量的差异干扰结论。
实验横跨两类下游任务:一类是知识密集型任务(knowledge-intensive tasks),例如医学知识问答,考察模型对事实性医学知识的掌握;另一类是临床导向型任务(clinic-oriented tasks),例如基于电子健康档案(EHR)的推理,考察模型在真实诊疗场景下的应用能力。这种任务分层是理解后续结论的关键。
电子健康档案(EHR,Electronic Health Record)是指以数字化形式记录的患者完整医疗信息,涵盖诊断记录、检验结果、用药历史、手术记录及医生诊疗笔记等。与教科书的结构化叙述不同,EHR 数据高度非结构化,充斥着临床缩写、不规范表达和大量上下文依赖,这正是临床型数据区别于教学型数据的本质所在。基于 EHR 的推理任务要求模型不仅掌握医学知识,还需理解真实诊疗流程中的语言模式与决策逻辑,因此常被视为衡量医疗 AI 临床实用性的重要基准。
核心发现:非对称的能力迁移
研究最重要的发现是数据类型之间存在非对称迁移(asymmetric transfer)。
具体来说,临床型数据不仅显著提升了临床导向型任务的表现,在知识密集型任务上也保持了相当的竞争力;而教学型数据则主要提升知识密集型任务,对临床任务的帮助有限。
换句话说,临床数据的「泛化半径」更大——它既能教会模型如何在真实场景中推理,又不会在纯知识考核上明显掉队。而教材数据更像是「偏科生」,擅长背诵知识,却难以迁移到实际诊疗判断中。
「知而不能行」的鸿沟
研究通过错误分析揭示了一个耐人寻味的现象,作者称之为knowing-doing gap(知行鸿沟):模型在知识记忆(knowledge recall)上的进步,并不能可靠地泛化为临床推理(clinical reasoning)能力的提升。
这一发现对医疗 AI 的评估范式提出了警示。业界常用医学考试题(如 USMLE 类基准)来衡量医疗大模型的水平,但高分并不等于模型能在真实病例中做出正确判断。会背知识点和会看病之间,隔着一道并非靠堆砌教材就能跨越的鸿沟。这也解释了为什么许多在标准化测试中表现亮眼的模型,落地到临床辅助场景时仍显吃力。
USMLE(United States Medical Licensing Examination,美国执照医师考试)是目前医疗大模型基准测试中最常被引用的评估标准之一。该考试分三个阶段,涵盖基础医学科学、临床知识与临床技能,以多选题为主。由于题目格式标准化且答案明确,很适合用于快速评估模型的医学知识掌握程度,GPT-4 等主流大模型均已在该基准上达到甚至超越人类平均水平。然而,USMLE 本质上仍是知识性考核,其题目场景经过高度简化,与真实病历中的模糊信息、多系统交互和决策不确定性相去甚远。这正是本研究所揭示的"知行鸿沟"在评估层面的体现——高 USMLE 分数更多反映的是知识记忆能力,而非临床推理的实际水平。
少量临床数据即可撬动大部分收益
另一个具有实践价值的观察是:适量的临床数据就能带来 EHR 相关任务上的大部分收益。这意味着即便临床数据获取成本高、隐私限制严,团队也不必追求海量临床语料——在合理配比下,少量高质量临床数据的边际效益极高。
同时,研究强调最优混合比例并非固定,而是随下游任务对知识与临床推理的需求而变化。推理密集的应用需要更高比例的临床数据,知识查询类应用则可以更依赖教学数据。
临床数据的稀缺性与高成本是医疗 AI 领域长期存在的核心瓶颈。一方面,患者病历受 HIPAA(美国健康保险流通与责任法案)等隐私法规严格保护,去标识化处理成本高昂且存在再识别风险;另一方面,真实临床数据往往分散在各医疗机构的孤岛系统中,难以汇聚。这使得边际收益递减的规律在临床数据上具有重要现实意义——如果少量精选的临床语料即可捕获大部分能力提升,那么团队便可将有限的数据获取资源集中于质量而非数量,同时通过合理的教学数据补充来降低对临床数据体量的依赖。
对医疗 LLM 数据策展的启示
综合这些结果,研究给出的核心建议是:医疗大模型的数据策展应当是**应用驱动(application-driven)**的,而非一味追求数据规模或某种「标准配方」。
- 对于面向真实诊疗、推理密集的用例,应优先提高临床数据的比例;
- 对于知识检索、科普问答类用例,教学数据仍是高效选择;
- 评估时不能只看知识型基准,还需引入临床推理型评测,才能真实反映模型的落地能力。
对于正在构建医疗垂直大模型的团队而言,这项工作提供了一个务实的思路框架:先明确应用场景对「知识」与「推理」的需求权重,再据此设计数据配比,而不是把所有能拿到的语料一股脑塞进训练集。数据的类型与配比,可能比单纯的数据量更能决定模型的临床价值。
相关推荐
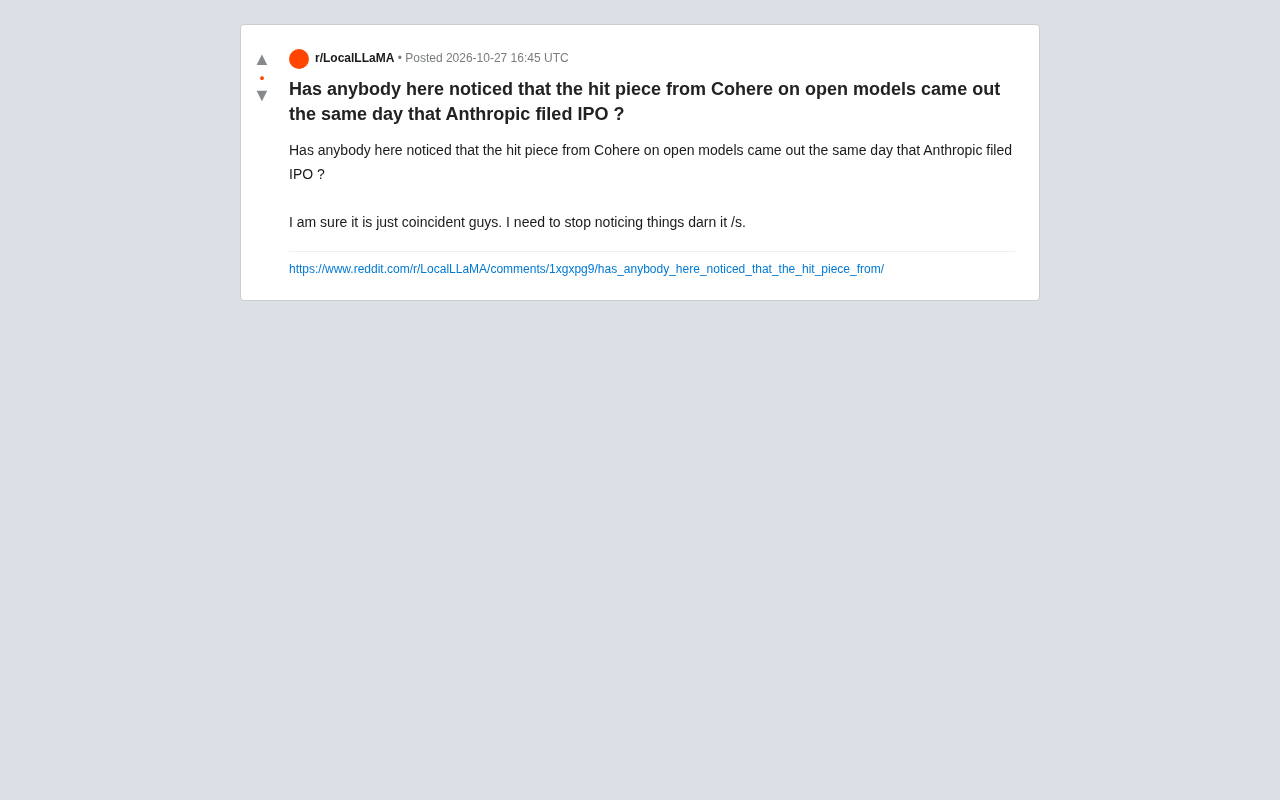
Cohere质疑开源模型与Anthropic IPO同日:巧合还是策略?
Reddit用户发现Cohere批评开源模型的文章与Anthropic提交IPO在同一天发布,引发社区对闭源厂商公共言论商业动机的讨论。本文分析这一时间巧合背后的开源与闭源之争,以及社区反应揭示的信任问题。
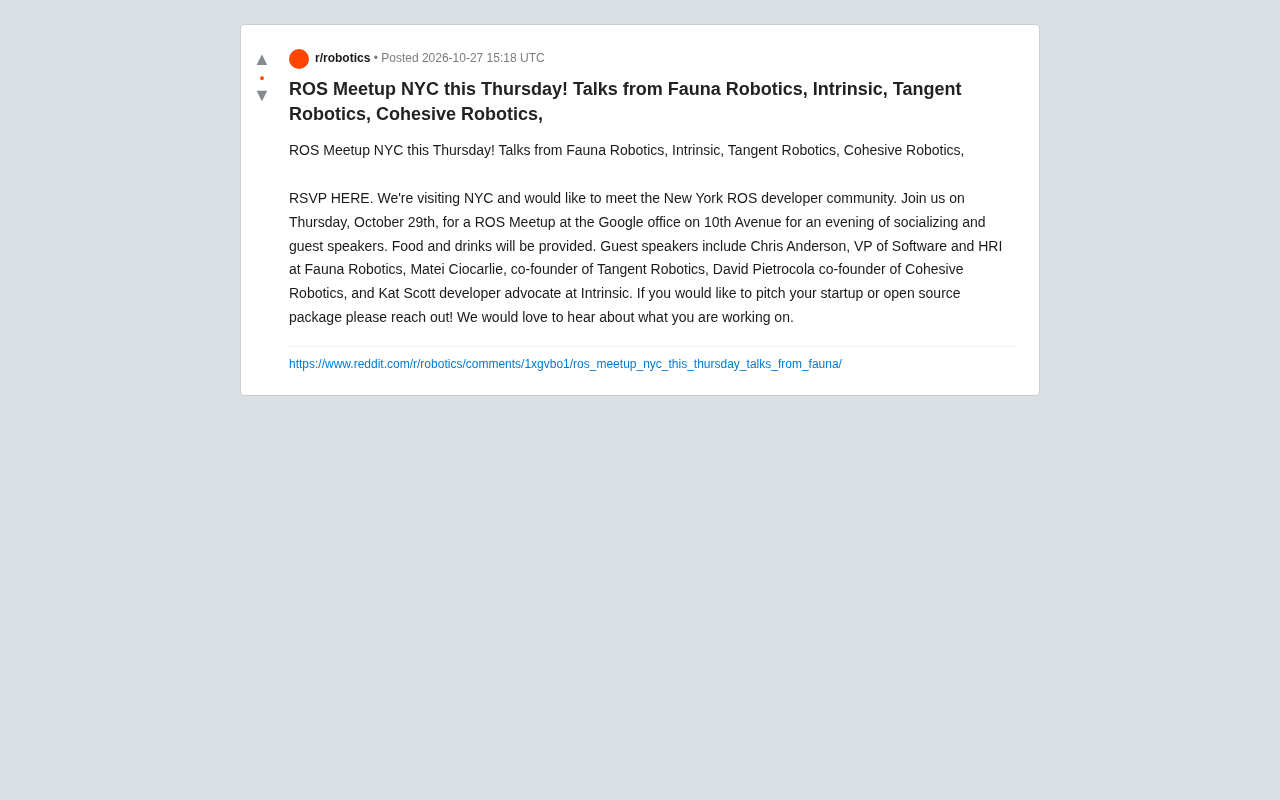
纽约ROS开发者聚会:四家机器人公司演讲
纽约ROS开发者聚会将于周四在谷歌办公室举行,Fauna Robotics、Intrinsic、Tangent Robotics、Cohesive Robotics等公司代表将发表演讲,活动免费并提供餐饮,开放报名与演讲征集。
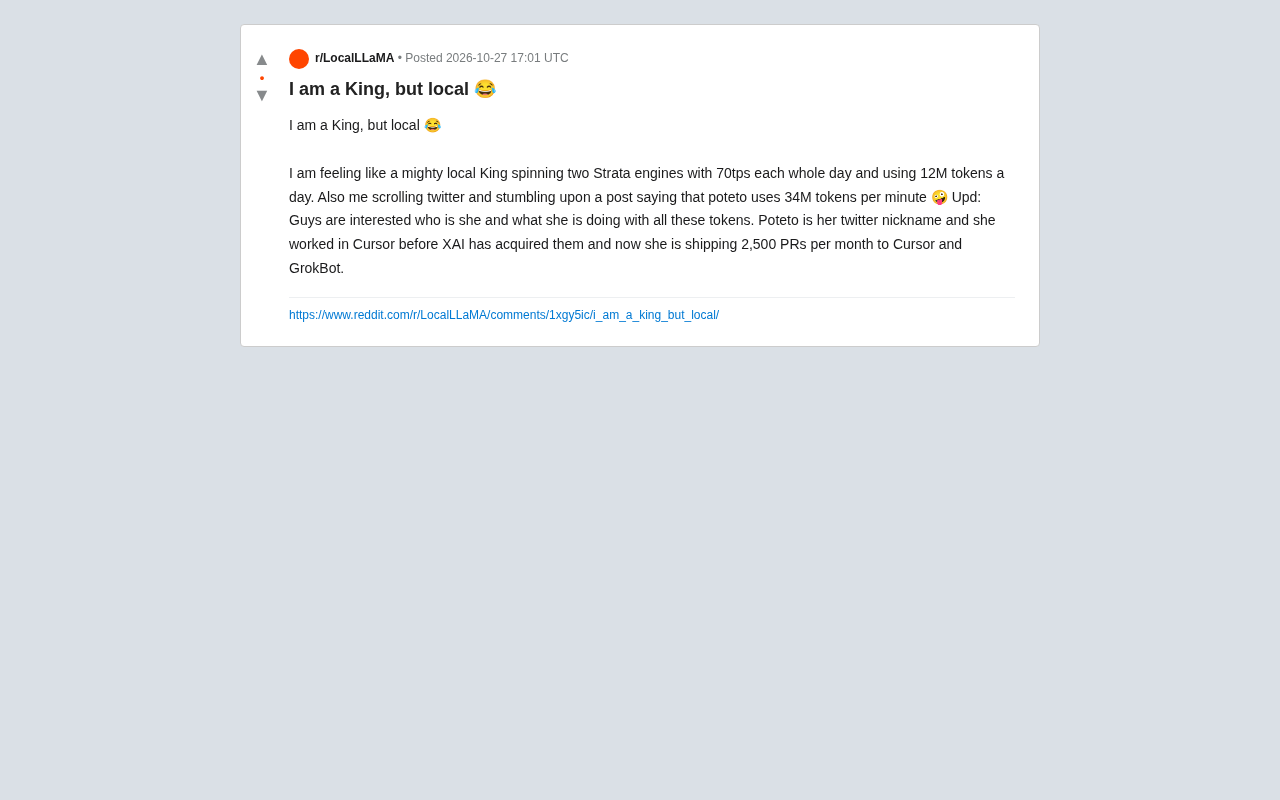
本地AI王者:日耗12M token背后的算力差距与竞争焦虑
Reddit开发者自嘲本地AI王者:日耗12M token,却被每分钟34M token的云端玩家降维打击。文章探讨本地部署与云端自动化的算力差距、token消耗量背后的行业焦虑,以及开发者如何在两种模式间找到平衡。