教师视角:AI作弊的四大动机与学术诚信危机
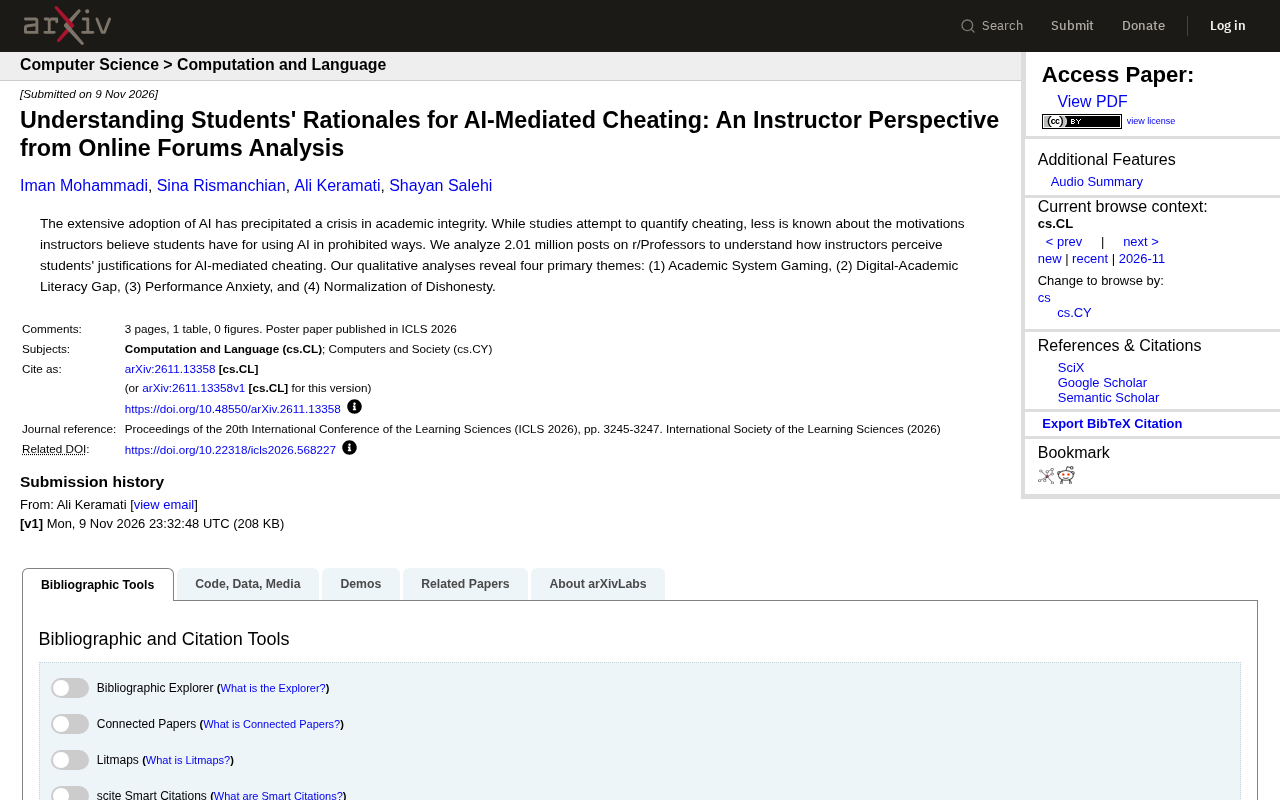
研究分析201万条教师论坛帖,揭示学生为AI作弊辩护的四大动机。
一项定性研究挖掘 Reddit 教师社区 r/Professors 的 201 万条帖子,从教师视角归纳出学生为 AI 辅助作弊辩护的四类典型说辞:将作弊视为对僵化评分体系的“学术系统博弈”;因不熟悉 AI 使用边界而产生的“数字-学术素养差距”;高压环境下的“表现焦虑”;以及同伴普遍违规导致的“不诚实行为正常化”。研究认为,这些动机交织,说明单纯依靠规则与惩罚难以奏效。教育者应针对不同动机设计干预:反思作业真实性、显性教授 AI 规范、关注学生心理健康、建设透明诚信文化,从而在 AI 时代构建更有效的学术诚信框架。
引言
随着AI工具在学术场景中的广泛采用,学术诚信正面临一场危机。过往研究多聚焦于量化作弊行为,却鲜少探讨教师眼中学生使用AI作弊的动机。近期一项研究通过分析Reddit论坛r/Professors上的201万条帖子,从教师视角揭示了学生对AI辅助作弊的四大合理化说辞。这些发现不仅勾勒出作弊行为的复杂动机,也为教育者应对AI时代的诚信挑战提供了新思路。
研究方法:从教师社区挖掘真实声音
该研究采用定性分析方法,对r/Professors论坛的201万条帖子进行挖掘。这个社区聚集了大量高校教师,他们在此分享教学经验、讨论学生行为。研究者通过分析教师们的叙述,归纳出他们认为学生用来为AI作弊辩护的主要理由。这种方法绕过了直接询问学生的潜在偏差,从第三方观察者视角捕捉动机,具有独特的价值。
r/Professors 是 Reddit 上规模最大的高校教师匿名社区之一,成员以北美高校的终身轨教师、讲师和兼职教员为主。其讨论具有自发、非结构化、去身份化的特点,教师在其中往往比在正式问卷中更愿意描述学生的具体违规细节与自己的真实判断。研究者选取该社区作为数据源,本质上是一种"自然主义取样":帖子并非为研究而写,因而较少受到社会赞许性偏差的影响。不过这一路径也有局限——发帖教师对作弊动机的归因属于第二手观察,可能夹杂个人情绪与刻板印象,且样本以英语国家的理工与社科教师为主,结论的跨文化适用性需谨慎对待。201 万条帖子的规模则保证了主题饱和度的达成,使归纳出的四类说辞具有统计意义上的普遍性。
四大主题:学生合理化AI作弊的典型说辞
基于教师们的讨论,研究提炼出四个核心主题:
1. 学术系统博弈(Academic System Gaming)
教师认为,部分学生将AI作弊视为对僵化评分体系或“无用”作业的反抗。他们觉得系统本身存在缺陷,使用AI只是“聪明地”应对规则,而非真正的欺骗。这种心态将作弊行为重新定义为对不公平制度的合理博弈。
“学术系统博弈”可与游戏研究中的“规则利用”(rule exploitation)和道德心理学中的“道德推脱”(moral disengagement)联系起来。班杜拉提出,个体可通过重新定义行为、淡化后果、归咎受害者等机制,让不道德行为在自我评价中变得可接受。当学生把作业描述为“无用”、把评分体系描述为“僵化”时,实际上是在完成一次责任转移:作弊的责任被归给制度,而非自己。这一心态在高等教育普及化、学费上涨与就业竞争加剧的背景下尤为突出,学生倾向于以“投入产出比”衡量学业,AI 因而被工具化为一种效率优化手段。理解这一点对教学设计至关重要——若作业本身缺乏真实性(authentic assessment),学生的博弈借口就更容易获得同伴认同。
2. 数字-学术素养差距(Digital-Academic Literacy Gap)
教师们观察到,学生可能缺乏对AI工具使用边界的认知。他们不清楚何时使用AI构成抄袭,也不理解学术规范中关于原创性的要求。这种素养差距导致学生无意中越界,却自认为合理。
“数字-学术素养”是数字素养(digital literacy)与学术素养(academic literacy)的交集概念。数字素养指有效、批判性地使用数字工具的能力;学术素养则指理解学科写作规范、引用惯例与知识生产逻辑的能力。二者的落差在于:学生可能熟练操作生成式 AI,却未内化“何为原创贡献”“何时必须标注来源”的学科共识。这一概念与“AI 素养”(AI literacy)框架相通,后者通常包含技术理解、批判评估、伦理判断与实际应用四个维度。研究表明,多数高校的 AI 使用政策以禁令或声明为主,缺乏课程层面的显性教学,学生只能从同伴或工具默认行为中推断边界。因此,“无意越界”并非纯粹的道德问题,而是课程设计未提供足够脚手架的结构性缺口。
3. 表现焦虑(Performance Anxiety)
高压的学习环境催生了焦虑情绪。教师认为,学生因害怕失败、追求高分而转向AI作弊。在竞争激烈的氛围中,AI被视为缓解焦虑的捷径,作弊动机与情绪压力紧密相连。
4. 不诚实行为的正常化(Normalization of Dishonesty)
当周围同学都在使用AI作弊且未受惩罚时,个体更容易将其视为常态。教师们指出,这种群体效应削弱了道德约束,使学生对作弊的负罪感降低,逐渐接受不诚实行为。
“正常化”机制可从社会规范理论理解。描述性规范指“别人实际上怎么做”,指令性规范指“别人认为应该怎么做”;当学生观察到同伴普遍使用 AI 且未见后果时,描述性规范会压倒指令性规范,形成“大家都这样”的认知。这与学术诚信研究中的“作弊文化”概念一致:班级层面的作弊普遍率是预测个体作弊行为的最强变量之一。此外,检测困难加剧了这一过程——生成式 AI 的输出难以被可靠识别,惩罚的不确定性降低了被抓获的预期成本,从而进一步削弱威慑。研究提示,透明、一致且被广泛知晓的诚信政策和低风险的作业设计,比事后惩戒更能抑制规范漂移。
对教学实践的启示
这些发现提示教育者,单纯强调规则和惩罚可能不足以应对AI作弊。理解学生的动机是设计有效干预措施的前提。例如,针对系统博弈心态,教师可以反思作业设计的合理性;针对素养差距,需加强AI使用规范的明确教学;针对焦虑,需关注学生心理健康;针对正常化,需建立更透明的学术诚信文化。
结语
这项研究通过教师视角揭示了AI作弊动机的多面性,为学术诚信建设提供了实证基础。随着AI技术持续演进,教育者需要更深入地理解学生行为背后的逻辑,才能构建适应时代的诚信框架。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
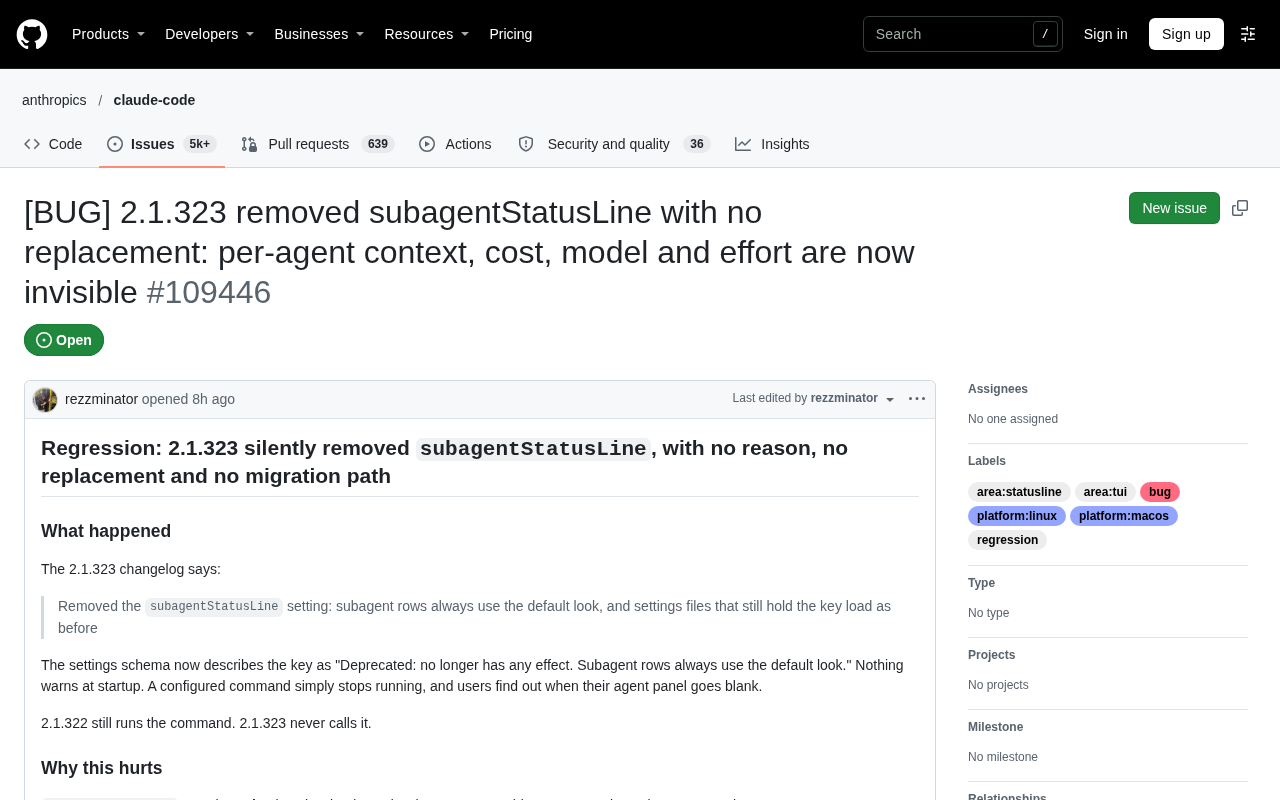
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
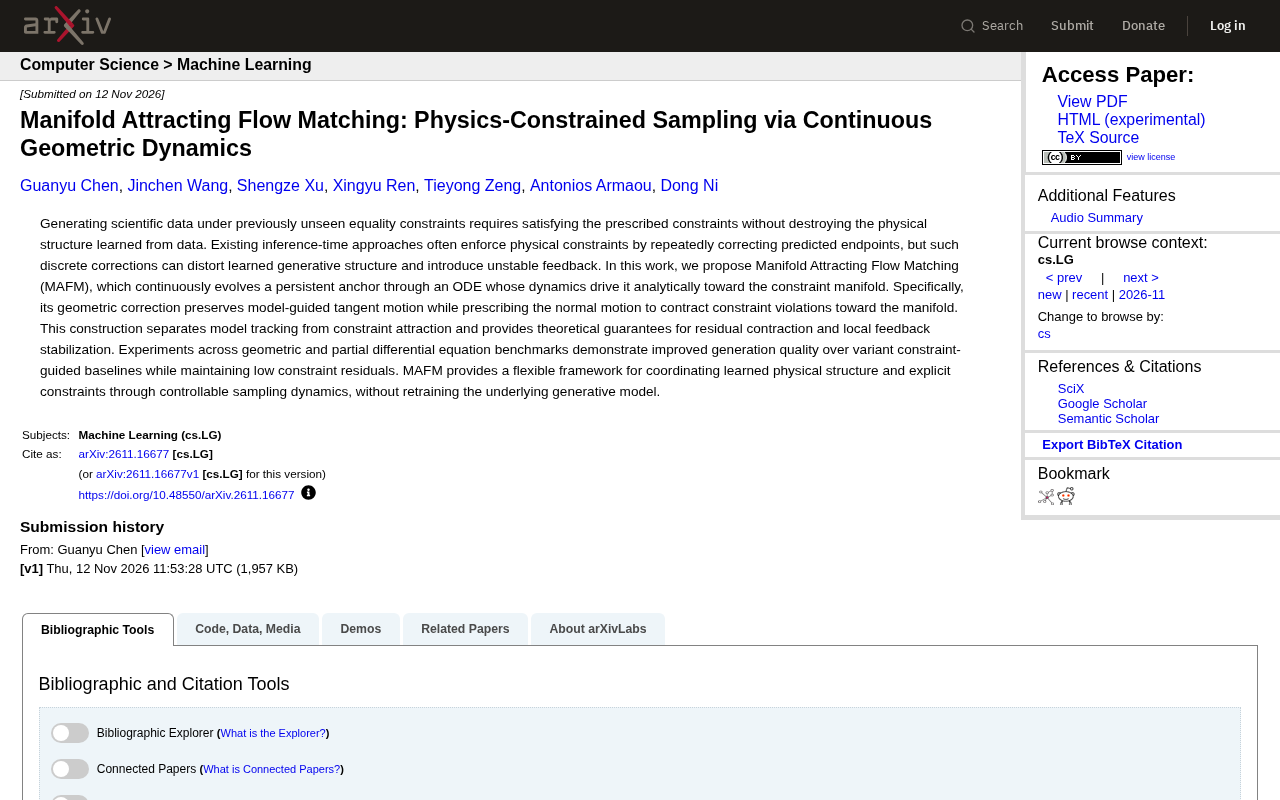
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。